ИИ-агенты собираются в команду
Сложную задачу часто нельзя решить одним универсальным агентом. Чтобы создать игру, например, нужно изучить требования, написать код, подготовить графику, собрать части проекта и проверить результат. Каждый шаг требует своих инструментов и навыков. А ещё важно передать результаты дальше так, чтобы следующий участник понял, на что опираться.
Авторы Raven предлагают строить системы именно так: как команду из специализированных ИИ-агентов, которые умеют работать вместе. Исследовательский агент ищет информацию, агент для программирования пишет и проверяет код, дизайнер готовит визуальные материалы. Отдельный управляющий агент разбивает запрос на задачи и связывает их в общий план.
Ключевая идея — считать отдельным рабочим модулем модель вместе с её обвязкой: инструментами, памятью, правилами выполнения и проверками. Тогда можно подключать разных агентов, не заставляя их работать по одному сценарию.
Как Raven собирает рабочий план
Управляющий агент описывает задачи в виде графа. Узлы — вызовы отдельных агентов, а стрелки показывают, какие результаты нужны для следующих шагов. Независимые задачи можно выполнять параллельно; зависимые запускаются, когда готовы их входные данные.
Например, если нужно сделать сайт о научной работе, два исследовательских агента могут отдельно изучить алгоритмы и способы их оценки. Агент для программирования дождётся обоих отчётов и соберёт эксперимент. Дизайнер подготовит страницу на основе результатов. Управляющий агент объединит готовые материалы.
Перед запуском система проверяет структуру плана: все ли задачи описаны, существуют ли нужные зависимости, подходит ли выбранный агент и может ли он работать с указанными файлами. Это помогает отсеять ошибки в графе до того, как агенты начнут тратить время и вычислительные ресурсы.
Результаты передаются как файлы и записи с понятными связями. Так агенту не приходится полагаться на пересказ управляющего агента или заново получать длинный отчёт в своём запросе. Для каждой задачи сохраняются инструкция, результат и ход работы. Если позже понадобится продолжить проект, можно обратиться к уже готовому результату или возобновить работу агента с сохранённым контекстом.
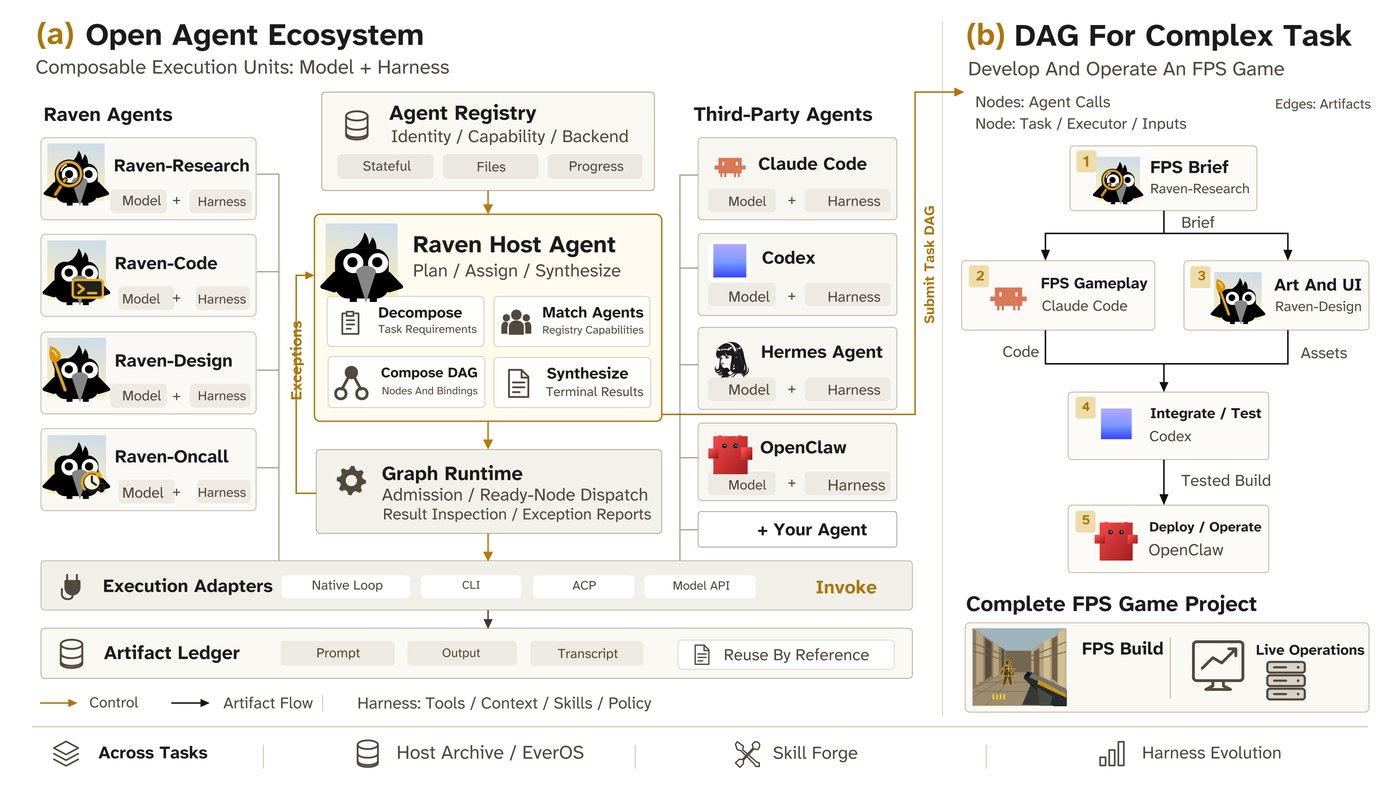
В Raven специализированные агенты выполняют узкие задачи, а управляющий агент связывает их результаты в общий план.
Есть и защита от ситуации, когда исполнитель объявляет работу законченной, хотя нужного файла или результата нет. После вызова отдельный проверяющий агент смотрит на запрос, ответ и часть истории выполнения. Если результата не хватает, управляющий агент может дать исполнителю дополнительные инструкции, отказаться от задачи или перестроить оставшийся план.
Но такая проверка оценивает, выполнена ли задача в заявленном смысле, а не всегда — верен ли результат по существу. Поэтому для кода нужны тесты, для исследования — проверка источников, а для дизайна — просмотр готового изображения.
Обвязка может улучшаться
Raven включает метод изменения обвязки агента, пока сама языковая модель остаётся неизменной. Можно менять четыре части: работу с памятью, планирование, выбор доступных инструментов и действия агента, включая проверку завершения.
Если агент регулярно заканчивает работу без ответа или не запускает тесты после правки кода, система ищет способ исправить именно это поведение. Она создаёт варианты обвязки, проверяет, сработало ли изменение, и сравнивает результат с прежней версией на одних и тех же задачах. Лучшие варианты проходят более полную проверку на обучающем наборе. Затем выбранную обвязку замораживают и оценивают на отдельных задачах, которые не участвовали в настройке.
Так, в опытах HarnessBank с неизменной моделью Qwen3.6-27B улучшенная обвязка повысила долю решённых задач на семи проверках. На AppWorld прирост составил 15,4 процентного пункта, на BrowseComp+ — 13,9, на LiveCodeBench — 13,7. По SWE-bench Verified показатель вырос на 5,1 пункта, но эта разница не прошла критерий, использованный авторами для оценки прироста.
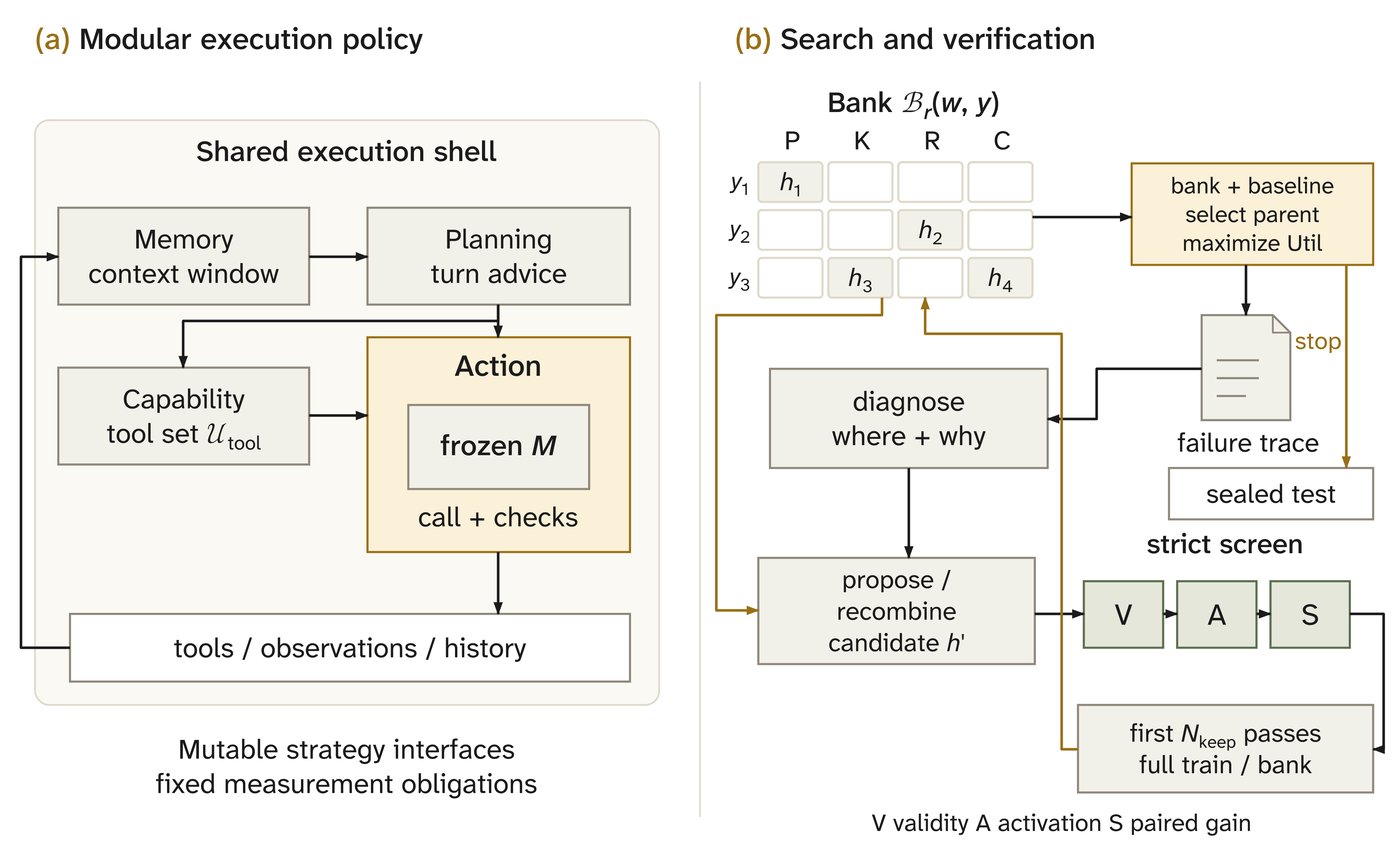
Обвязка меняется вокруг неизменной модели, а новые варианты проходят проверку перед оценкой на отложенных задачах.
У метода есть ограничения. Он выбирает варианты по результатам обучения и не гарантирует, что улучшение повторится на новых задачах. Авторы также отмечают, что подробные настройки отдельных опытов HarnessBank опубликованы не полностью. Поэтому эти цифры показывают возможности подхода, но не дают полной картины того, сколько стоило получить каждый результат.
Память хранит опыт, навыки превращают его в инструкции
У Raven два вида памяти. Первый помогает сохранять сведения о пользователе: его предпочтения, ограничения и контекст прошлых разговоров. Второй записывает опыт самого агента: какую задачу он выполнял, что делал и какой вывод можно использовать в дальнейшем.
Сначала переписка делится на смысловые части. Из них создаются короткие описания эпизодов и отдельные факты. Похожие эпизоды объединяются, чтобы система могла восстановить не только конкретный факт, но и контекст, в котором он появился. При поиске Raven использует и совпадения слов, и близость смысла, а потом возвращает найденный факт вместе с эпизодом, к которому тот относится.
Из повторяющегося опыта агент может получить навык — инструкцию для определённого класса задач. Например, случаи, когда нужно изменить проект и проверить правку, могут со временем превратиться в процедуру: сначала воспроизвести ошибку, затем внести небольшое изменение и запустить тесты.
Для навыков Raven обращается к трём источникам: локальной библиотеке, памяти агента и общему каталогу SkillHub. Найденные материалы объединяются, а управляющий механизм выбирает подходящие для текущей задачи. Если выбор не срабатывает, система использует отдельное правило: берёт несколько наиболее высоко оценённых вариантов из списка.
Каталог SkillCorpus, на котором основана часть экспериментов, содержит 96 401 активный навык. Перед добавлением материалы проверяли на дубликаты, качество и потенциально опасные инструкции. В опытах с фиксированной библиотекой навыки повышали результат на всех трёх проверках: SkillsBench, GDPval и QwenClawBench. На SkillsBench прирост Raven составил 6,5 и 13,4 процентного пункта для двух размеров модели. На GDPval прибавка была скромнее — от 1,2 до 1,9 пункта во всех проверенных сочетаниях агента и модели.
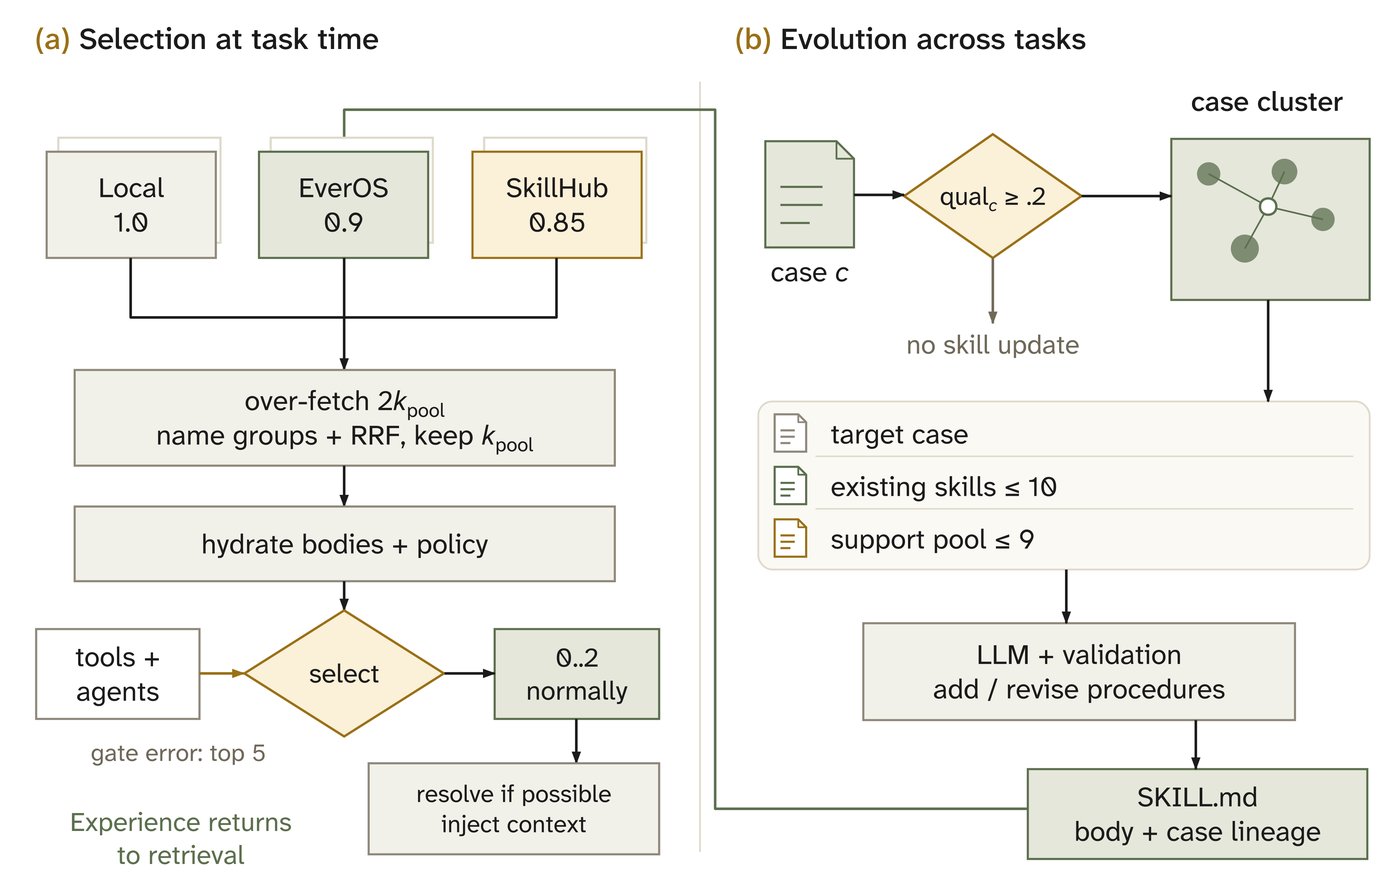
Поиск памяти сначала находит подходящие эпизоды, а затем выбирает факты, сохраняя их исходный контекст.
Что показывают испытания
Чтобы отдельно проверить работу управляющего агента, авторы создали бенчмарк из 140 задач. В каждой нужно выбрать специалистов и определить, какие результаты должны предшествовать другим. Raven сравнили с Claude Code и Hermes Agent на двух языковых моделях, не запуская самих исполнителей: оценивался только составленный план.
Raven показал лучший результат по всем четырём показателям на обеих моделях. На одной Exact Match — доля планов, совпавших с допустимым эталоном по составу специалистов и зависимостям, — составил 71,1% против 60,7% у лучшего соперника. На другой — 86,7% против 76,2%. Это говорит о том, что Raven точнее выбирал исполнителей и связывал их задачи. Однако бенчмарк проверяет планы, а не качество итоговой работы команды.
Профильные агенты оценивали отдельно. Raven-Research отвечал на вопросы с опорой на сведения в интернете. На DeepResearch Mixed с моделью DeepSeek-V4-Flash он набрал 76,5% точности. Сильнейший из сравниваемых агентов на той же модели получил 68,9%. При этом стоимость одного ответа Raven оценили в 0,0242 доллара: немного дороже одного соперника и дешевле другого. Пять из шести сопоставлений на одинаковых моделях дали статистически значимое преимущество; в шестом разница в 3,3 пункта не прошла такую проверку.
Raven-Code проверяли на задачах по программированию, включая исправление ошибок и перенос целого проекта на новый технологический набор. На SWE-bench Pro он решил на 15 задач больше, чем Claude Code с той же моделью. На SWE-Refactor результаты Raven превышали опубликованные показатели других систем на 9,5 пункта для DeepSeek-V4-Flash и на 3 пункта для GPT-5.6 Luna. Здесь важно учитывать, что часть сравнений сделана с внешними результатами, а настройки и условия работы систем различались.
Raven-Design создаёт слайды, сайты и визуализации с предварительным просмотром результата. На PresentBench он получил 80,2 балла с Claude Opus 5 и 72,9 с GPT-5.6 Luna. Во втором случае Claude Code набрал 52,4. Оценка проверяет не только внешний вид: в ней учитываются полнота, точность и соответствие исходному материалу.
Raven-Oncall отвечает за долгие вычислительные задачи, например запуск обучения и наблюдение за его ходом. В наборе из 17 научных задач он успешно выполнил 14 с Claude Opus 5; Claude Code — 11. Такие сравнения зависят от конкретных задач, инструментов и правил оценки, но показывают, зачем системе отдельный исполнитель для работы, которая продолжается часами.
Вывод
Raven предлагает собирать ИИ-системы из специализированных агентов, связанных явными зависимостями, и сохранять их опыт для следующих задач. Управляющий агент строит план, исполнители передают результаты как артефакты, а обвязки и навыки могут меняться без обновления самой модели.
Результаты выглядят многообещающе, особенно в планировании и профильных задачах. Но испытания проводились на разных наборах данных и по разным протоколам. Некоторые сравнения опираются на опубликованные таблицы других систем, а дополнительные слои памяти и обратной связи пока не проверены в полном составе.
Практический вопрос остаётся открытым: дают ли несколько агентов лучший итог, чем один хорошо оснащённый агент, если считать общую стоимость — включая планирование, проверки, повторы и передачу результатов. Теория Raven описывает условия, при которых такое объединение может расширить круг решаемых задач. Проверить, насколько часто эти условия выполняются в реальной работе, должны будущие сравнительные испытания.
Читайте также
 Как тысяча ИИ-агентов работают вместе без начальника
 Как дать ИИ-агенту больше свободы с меньшим риском
 Как ИИ-агент подбирает прошлый опыт под новую задачу
 ИИ-судья сохраняет 99% точности за меньшие деньги
 Как самоулучшение ИИ-агента улучшает результаты и экономит токены
 Почему ИИ-агентам трудно работать с разными данными
 Как ИИ-агентам экономить контекст и избегать сбоев
 Как ИИ симулирует мысли пользователя
 Как ИИ-агенты восстанавливают приложения по их поведению
 Как ИИ помогает разрабатывать игры
 Как проверить, понимает ли ИИ-ассистент мотивы людей
 Как ИИ-агент управлял интернет-магазином и увеличил капитал в 14 раз
ИИ-обзоры простыми словами
Каждый день читаем свежие статьи об ИИ и пересказываем главное естественным языком — без хайпа и воды. Если хотите понимать, куда движутся ИИ-агенты раньше остальных, — подписывайтесь.
Новые обзоры — каждый день
В Telegram