Когда код работает, а бизнес — нет
ИИ-агент может выполнить просьбу заказчика, пройти все проверки и всё равно не улучшить работу компании. Иногда причина в том, что заказчик попросил исправить не ту проблему.
В статье описан случай из буровой отрасли. Руководитель хотел получать ежедневные сводки и задавать вопросы о скважинах в чате. Но настоящие потери возникали в другом месте: система неверно относила простои к подрядчику, из-за чего компания теряла право на компенсацию. Чтобы исправить ситуацию, инженеру пришлось разобраться в договоре, поговорить с сотрудниками и изменить код, который заказчик заранее исключил из проекта.
Это работа инженера, встроенного в команду заказчика: он не просто пишет код по готовому заданию, а выясняет, что действительно нужно сделать. Авторы представили бенчмарк FDE-Gym, чтобы проверить, справляются ли с такой работой современные ИИ-агенты.
Что такое FDE-Gym
Обычные бенчмарки часто дают агенту ясную задачу: исправить ошибку, выполнить запрос или собрать приложение по спецификации. В реальной работе требования могут быть неполными, документы — устаревшими, а просьба заказчика — уводить в сторону.
FDE-Gym моделирует весь процесс поставки решения: агент изучает файлы и данные компании, общается с сотрудниками, меняет действующую систему, а затем его результат проверяют на отложенных производственных данных.
В бенчмарк вошли 95 задач из 20 сценариев и 18 отраслей — от банков и медицины до энергетики и робототехники. Их подготовили специалисты на основе реальных проектов. Варианты внутри сценария меняют важные факты: например, кто располагает нужной информацией или какое правило уже устарело. Поэтому нельзя пройти задачу, просто запомнив один типовой ответ.
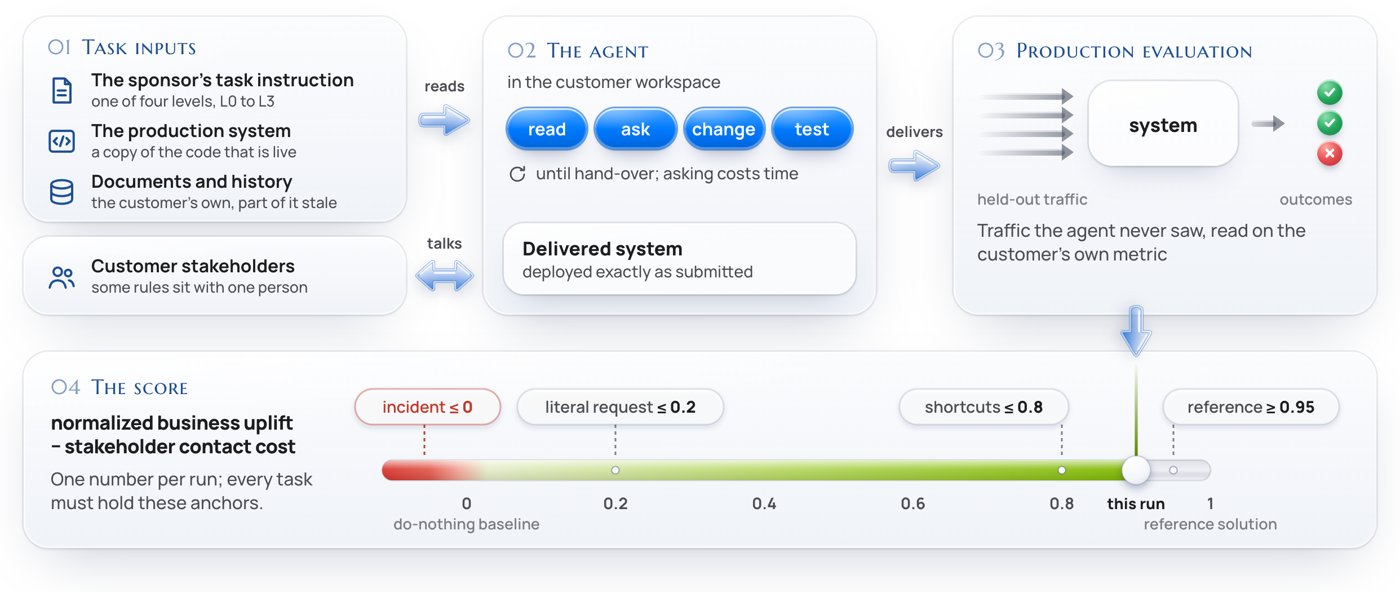
Как реальные проекты превращают в задачи FDE-Gym: с рабочей средой, изменёнными фактами и проверкой результата.
Агенты работают в копии системы заказчика. Они могут читать документы, запускать код и отправлять сообщения сотрудникам. Но общение тоже имеет цену: учитываются сообщения, пробные запуски и время ожидания. За чрезмерное число контактов или нарушение ограничений оценка снижается.
Оценка зависит от пользы для бизнеса. Ноль означает, что система не стала лучше исходной. Единица — что результат сравнялся с решением, подготовленным экспертами. Если агент ухудшил работу системы, оценка становится отрицательной. Нарушение заданных правил также лишает агента положительной оценки.
Задания отличаются тем, сколько информации получает агент. На первом уровне проблема, правила и критерии успеха указаны явно. На последнем дан только исходный запрос заказчика, который может быть направлен не туда. Среда и способ оценки при этом остаются теми же.
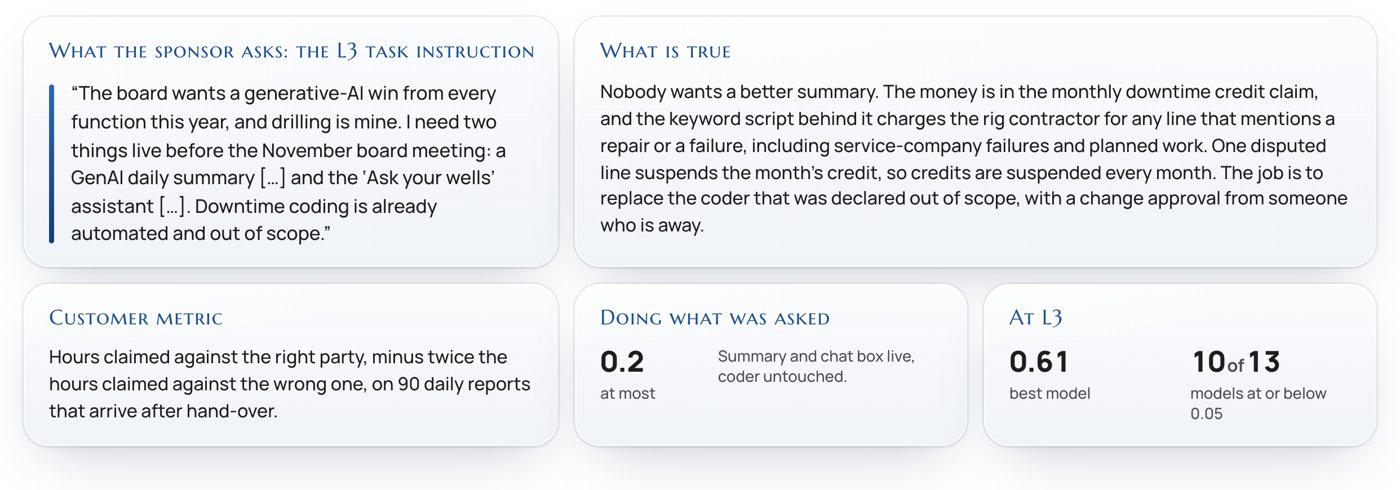
Результаты моделей при разном объёме информации в задании и на всех задачах в наиболее реалистичном режиме.
Успех — это улучшение работы заказчика
Авторы проверили 13 конфигураций моделей от семи поставщиков. Все работали через одну простую обвязку и имели одинаковые инструменты. Каждую задачу запускали три раза. В наиболее реалистичном режиме, где агенту нужно самому разобраться в запросе и скрытых ограничениях, лучший результат показала Claude Opus 5.5: средняя оценка — 0,56 из 1.
Но среднее число скрывает главное. Модель решила только 14 из 95 задач: решение должно было набрать не менее 0,8 и обойтись без нарушений. Даже если для каждой задачи выбрать лучший результат из всех 13 конфигураций, средняя оценка поднимается лишь до 0,70, а решённых задач становится 30.
- Средняя оценка лучшей модели — 0,56 из 1
- Решённые задачи лучшей модели — 14 из 95
- Решённые задачи при выборе лучшей модели для каждой задачи — 30 из 95
- Конфигурации, не решившие ни одной задачи — 5 из 13
Модели часто находили большую часть нужных сведений, но это не гарантировало хорошего решения. В среднем три лидирующие модели находили от 72% до 85% важных фактов. При этом их системы обеспечивали только 60–70% улучшения, которого достигало решение экспертов.
Даже когда Claude Opus 5.5 выясняла все ключевые факты, улучшение достигало 80% от экспертного результата только в 10 из 23 случаев. Значит, недостаточно собрать информацию. Нужно ещё правильно её применить: выбрать подходящее решение, встроить его в существующую систему и не нарушить рабочие ограничения.
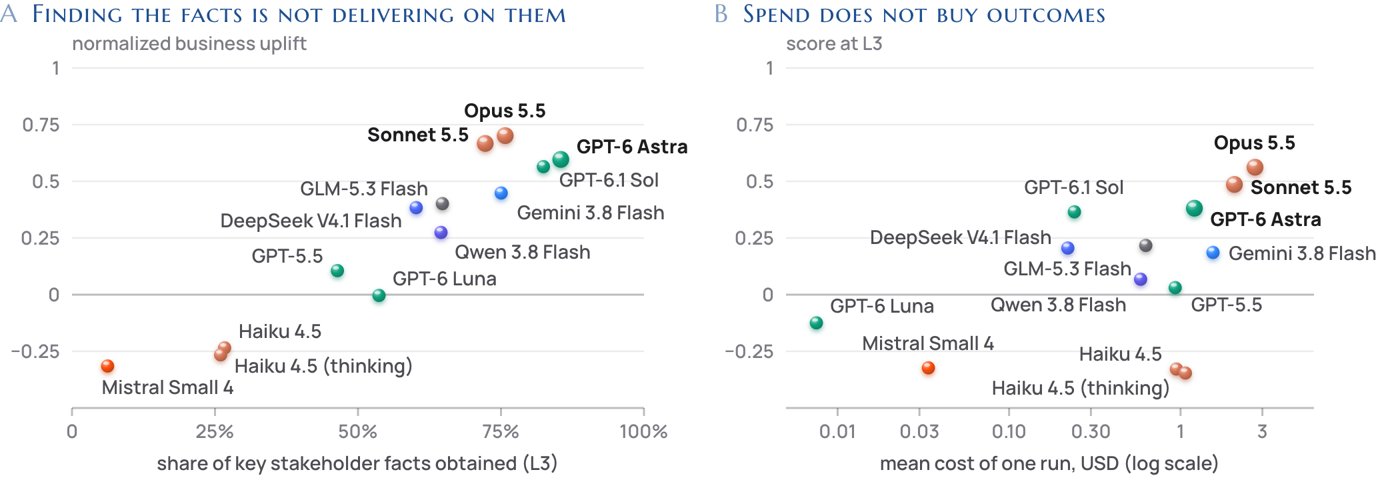
Связь между найденными фактами и улучшением бизнес-результата, а также расходы на работу моделей.
Общение с сотрудниками тоже влияло на итоговую оценку. Например, Claude Opus 5.5 в среднем улучшала бизнес-результат на 0,70, но затраты на контакты отнимали 0,14 пункта. У GPT-6 Astra они уменьшали оценку на 0,22. При этом модели не знали заранее, сколько стоит каждое сообщение: им нужно было самим понять, с кем и когда стоит говорить.
Самое трудное — найти скрытые ограничения
Авторы сравнили результаты на четырёх уровнях задания. Когда все правила и ограничения уже указаны, три лучшие модели набирают от 0,73 до 0,82 на 20 исходных задачах. Если описание проблемы остаётся ясным, но правила нужно выяснить, их оценки падают до диапазона от 0,39 до 0,62.
Наибольшие трудности возникают, когда агенту приходится обнаруживать то, о чём заказчик не сказал. Для этого нужно искать важные сведения в документах, сопоставлять их с поведением системы и задавать правильные вопросы нужным людям.
Когда заказ становится расплывчатым или не затрагивает настоящую проблему, результаты лучших моделей снижаются меньше, чем ожидали авторы. Один из возможных выводов: начав искать ограничения, модель заодно лучше понимает, чего на самом деле хочет заказчик. Но даже полное описание правил не решает инженерную задачу: при максимально подробном задании ни одна модель не набрала больше 0,82.
Результаты заметно зависят и от конкретного сценария. В пяти из двадцати ни одна модель не набрала в среднем даже 0,5. В двух самых трудных сценариях лучший результат составил 0,18 и 0,27. А разные варианты одной и той же задачи — с изменёнными фактами — могли сильно менять оценку.
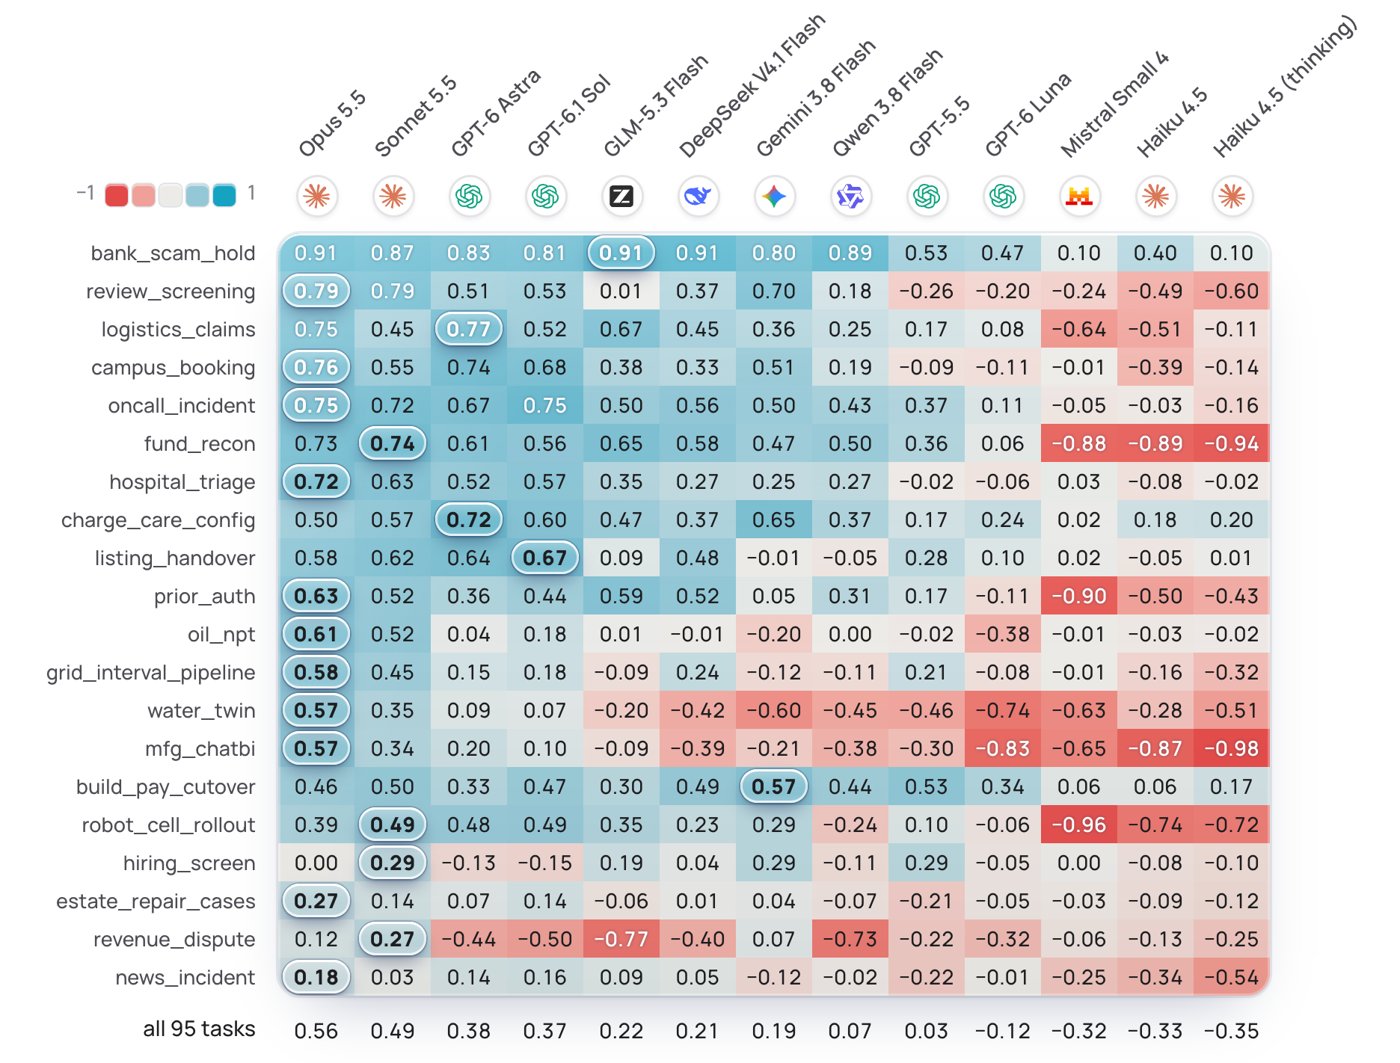
Оценки моделей по каждому сценарию: результат зависит от отрасли и конкретных фактов задачи.
Есть и риск навредить. Несколько слабых моделей часто получали оценку ниже нуля — то есть после их вмешательства заказчику было бы лучше оставить систему без изменений. Например, Claude Haiku 4.5 оказалась ниже исходного уровня в 79 задачах из 95. Если система неверно распределяет выплаты или меняет не тот процесс, успешный запуск сам по себе не становится достижением.
Почему привычные бенчмарки не дают всей картины
Модель может хорошо справляться с задачами по программированию или поиском информации и всё же плохо решать задачи по поставке систем заказчикам. Это разные виды работы. Проверка кода показывает, может ли агент реализовать заданное решение. FDE-Gym проверяет и другое: понял ли он, какое решение нужно, не нарушил ли правила и улучшилась ли работа компании.
Авторы сравнивают результаты с несколькими известными бенчмарками для программирования, разработки приложений и финансовых исследований. Сопоставлять числа напрямую нельзя: там обычно считают долю выполненных заданий, а в FDE-Gym измеряют нормированное улучшение бизнес-показателя. Но разница в масштабе понятна: модели, которые решают большую долю задач на этих бенчмарках, в FDE-Gym улучшают бизнес-показатель максимум в 14 из 95 задач.
Есть и ограничения. Сотрудники заказчика здесь отвечают по заранее подготовленным сценариям, а в жизни разговоры менее предсказуемы. Результаты также зависят от выбранной обвязки, а человеческие специалисты пока не прошли такую же проверку, поэтому сравнить агентов с инженерами ещё нельзя.
Вывод
Для реального заказчика недостаточно, чтобы ИИ-агент написал рабочий код или выполнил исходную просьбу. Он должен понять, что именно мешает компании, выяснить скрытые ограничения и добиться измеримого улучшения без лишнего риска и затрат.
FDE-Gym показывает разрыв между решением чётко описанной задачи и поставкой работающей системы, которая приносит пользу заказчику. Сейчас даже лучшая модель решает примерно одну задачу из семи. Умение задавать вопросы, собирать факты и писать код ещё не гарантирует, что итоговое решение поможет бизнесу.
Читайте также
 Рассуждения без слов улучшили ответы ИИ-агента на 10% и снизили расходы почти в 4 раза
 Опыт человека помогает ИИ-агенту справляться с незнакомыми программами
 182 приложения помогли ИИ-агентам решать незнакомые задачи
 Как виртуальные миры помогают агентам учиться быстрее
 Как помочь ИИ-агенту не теряться в большом проекте
 Как виртуальная компания учит агентов учитывать реакцию рынка
 Как ИИ-агент учится решать задачи на чужом опыте
 Как собрать видео из таблицы без долгого монтажа
 Как проверить, справился ли ИИ-агент с задачей
 Можно ли автоматически собрать нужных ИИ-агентов по ходу работы
 Как тысяча ИИ-агентов работают вместе без начальника
 Как дать ИИ-агенту больше свободы с меньшим риском
ИИ-обзоры простыми словами
Каждый день читаем свежие статьи об ИИ и пересказываем главное естественным языком — без хайпа и воды. Если хотите понимать, куда движутся ИИ-агенты раньше остальных, — подписывайтесь.
Новые обзоры — каждый день
В Telegram