Миры, которые можно написать кодом
ИИ-агенту мало дать цель и список доступных действий. Ему нужно где-то пробовать, ошибаться и видеть последствия своих решений. Но привычные симуляторы требуют моделей, текстур и сложной графики. А видеомодели умеют создавать красивые сцены, но им трудно поручить точные правила: чтобы дверь открывалась от нажатия, предмет оставался на месте, а столкновения происходили предсказуемо.
В статье предлагают соединить эти подходы. AgentGarten хранит правила и состояние мира в коде, а вид для агента создаёт нейросетевой рендерер. Получается среда, где физика остаётся под контролем, а сцена выглядит как обычное видео. В такой среде агенты могут учиться действовать, а затем передавать накопленный опыт следующим участникам в виде коротких заметок.
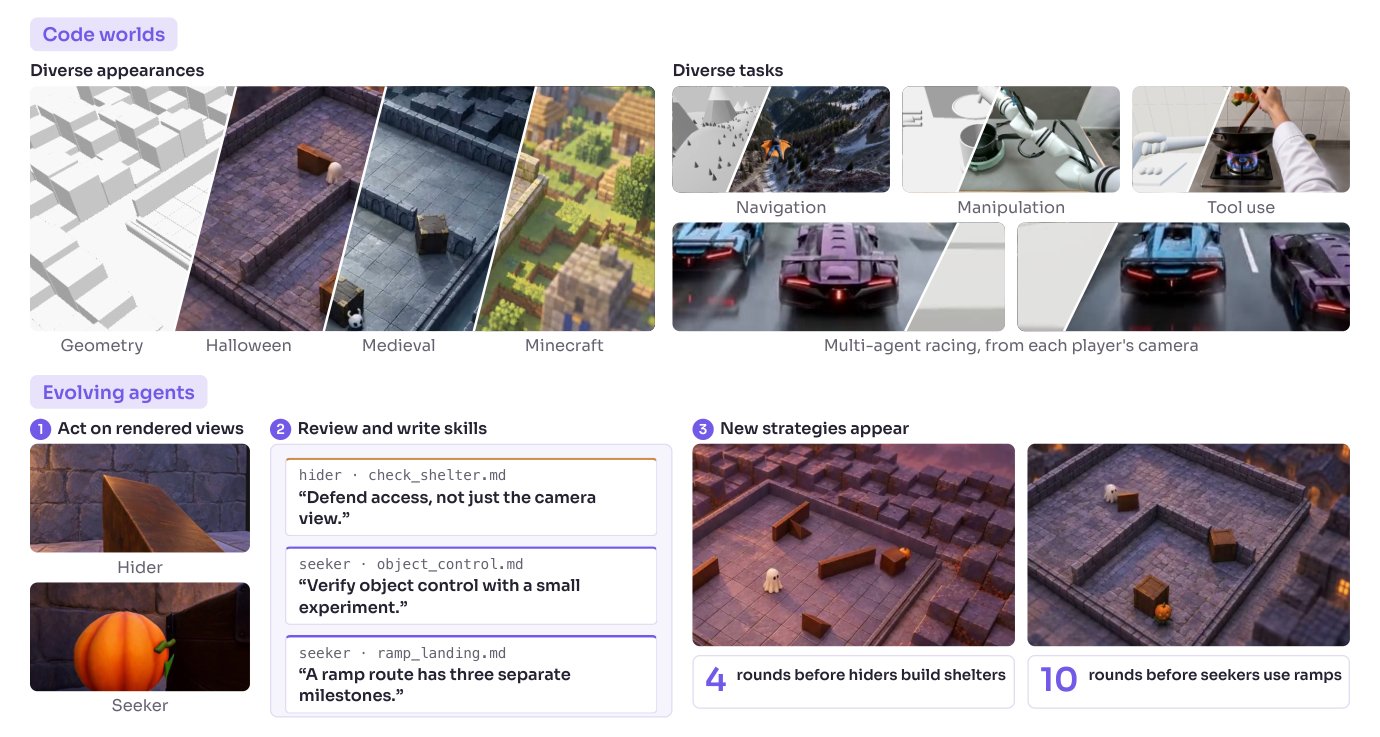
Миры в коде можно показать в разных стилях и для разных задач, а агенты учатся в них по записям прошлых раундов.
Состояние отдельно, картинка отдельно
В AgentGarten за происходящее отвечает симулятор или игровой движок. Он хранит положение объектов, их свойства и правила взаимодействия. Когда агент двигается или берёт предмет, движок обновляет состояние мира и передаёт рендереру описание видимой геометрии.
Рендерер превращает это описание в кадры. Он получает карту глубины или нормалей поверхности — информацию о форме объектов и их положении, — а также изображение-образец, текстовое описание и предыдущие кадры. На выходе получается визуальное наблюдение, которое агент использует, чтобы выбрать следующее действие.
Такое разделение важно для долгих взаимодействий. Если изображение получилось неточным, ошибка не меняет состояние симулятора. Предмет не телепортируется из-за того, что видеомодель нарисовала его чуть в стороне. Кроме того, одну и ту же историю действий можно показать с другой точки или в другом визуальном стиле: события останутся прежними, поменяется только картинка.
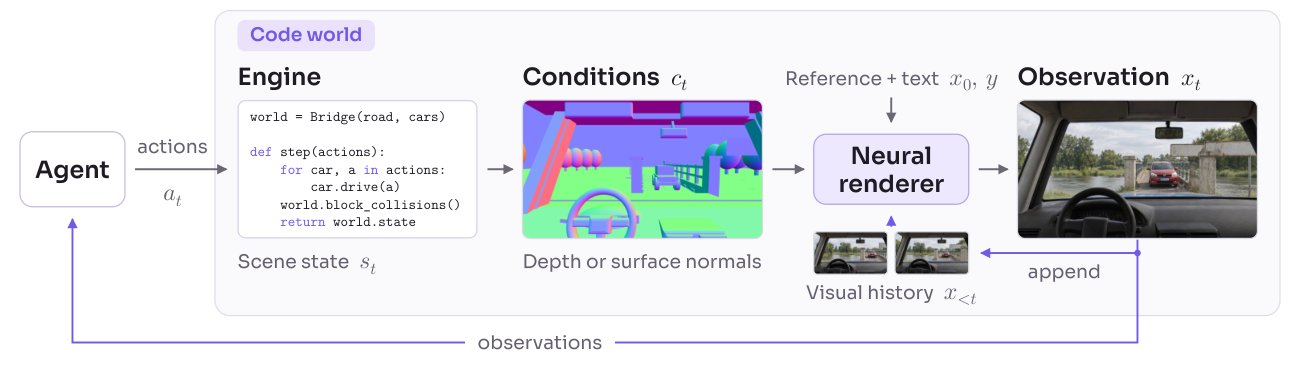
Движок обновляет состояние мира, а нейросетевой рендерер превращает описание геометрии в кадры для агента.
Мир можно собрать по текстовому описанию или по одной картинке. Во втором случае отдельные модели помогают распознать объекты и оценить глубину. Затем агент для программирования создаёт сцену: задаёт расположение предметов, физические свойства и правила. Он проверяет результат, рассматривая кадры из разных точек и запуская пробные действия. Если конструкция неустойчива или движение выглядит неправдоподобно, код исправляют.
Для этого не нужно создавать подробные трёхмерные модели каждой детали. Программа задаёт основную геометрию и поведение, а рендерер отвечает за внешний вид. Например, из фотографии гостиной можно собрать сцену с видимой комнатой и добавить за ней другие помещения, которых на исходном снимке не было.
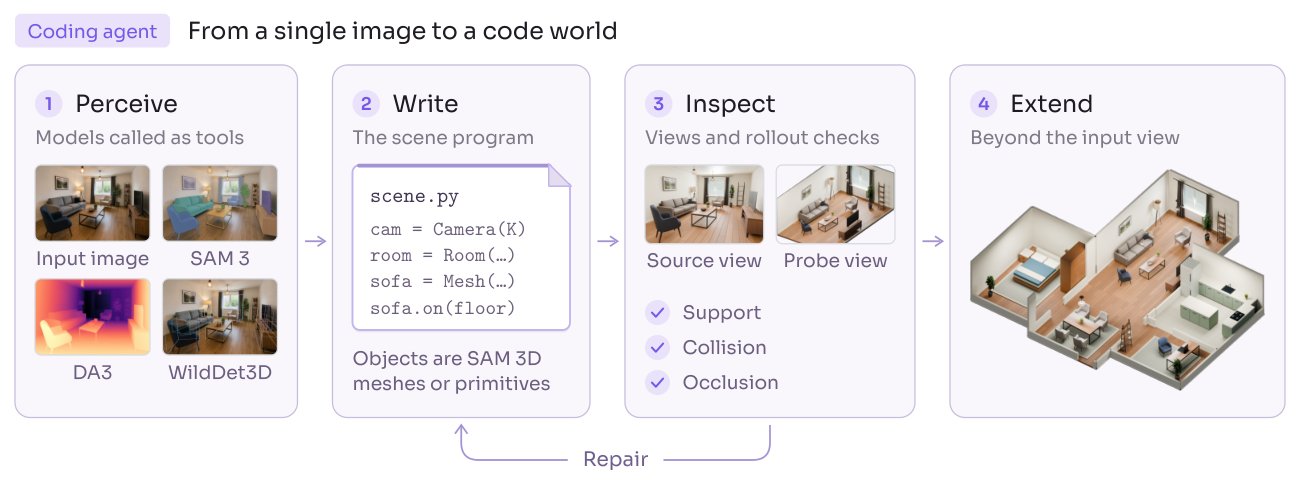
Сцену по одной фотографии собирают из оценки геометрии и кода, а затем проверяют пробными запусками.
Как рендерер учится работать быстро
Для интерактивной игры недостаточно убедительно рисовать отдельные кадры. Рендерер должен учитывать предыдущие наблюдения и быстро показывать результат каждого действия. Авторы взяли предварительно обученную видеомодель и научили её работать с геометрией и создавать видео короткими блоками.
В обучении есть две части. Сначала модель учится продолжать последовательность кадров, опираясь на уже готовую историю. Затем её ускоряют: вместо многих шагов создания видео оставляют четыре шага. Это нужно, чтобы агент мог быстро действовать и сразу видеть последствия.
Авторы называют свой метод Adversarial Forcing. Он сочетает обучение на собственных видеопродолжениях модели и дополнительную проверку качества с помощью настоящих видеоданных. Такая проверка нужна из-за характерной проблемы долгих генераций: по мере продолжения видео текстуры могут повторяться, а детали сцены — исчезать.
Есть и техническая проблема. При обучении на последовательных кадрах поздняя ошибка должна помогать модели лучше обрабатывать ранние кадры, которые попадают в историю. Но если хранить весь граф вычислений, расход памяти становится слишком большим. Поэтому авторы сначала записывают результат обычного запуска, а затем повторяют вычисления по блокам и пересчитывают историю так, чтобы через неё проходил градиент. Этот приём они назвали точным повтором.
Точность здесь не только в смысле «примерно совпало». По сравнению с пересчётом всей последовательности одним вызовом такой способ воспроизводит результат запуска побитно. При этом он не увеличивает пиковый расход памяти. На одном графическом ускорителе H100 рендерер выдаёт более 35 кадров в секунду при разрешении 480 × 832.
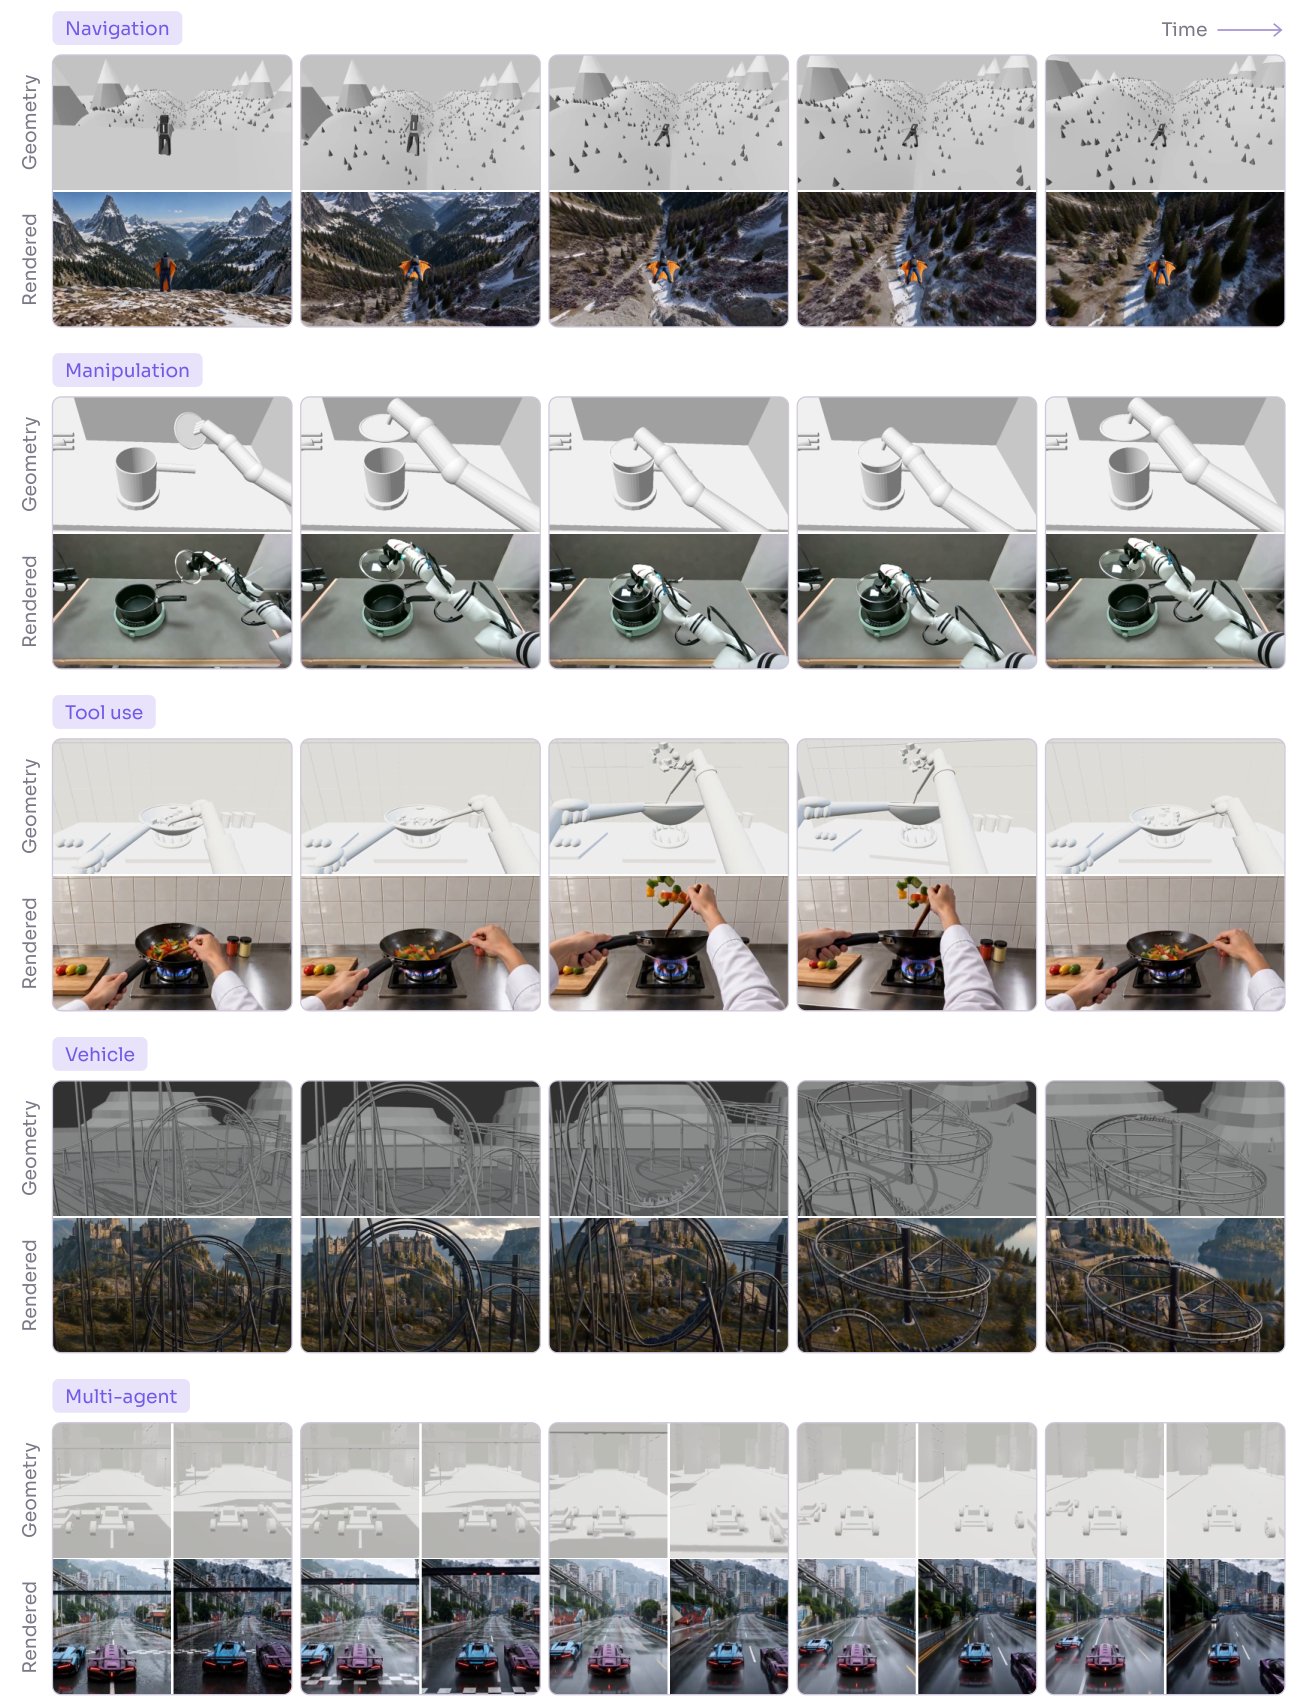
Пять миров в пяти моментах одного запуска: сверху — геометрия сцены без текстур, снизу — кадр, который рендерер рисует по ней.
Агенты учатся на опыте друг друга
Авторы проверили среду на нескольких задачах. Самый наглядный пример — игра в прятки. Один агент прячется, второй ищет его. Они видят только кадры от первого лица, действуют короткими программами на языке Python и не получают координаты объектов или полное состояние симулятора.
После каждого раунда агент разбирает свои действия и записывает выводы в «книгу навыков» — набор файлов с наблюдениями и советами. Следующие агенты начинают разговор с чистого листа, но получают эти записи и могут применять их в новой партии.
Так, прячущийся агент научился двигать панель, чтобы перекрыть вход. Ищущий — переносить рампу к стене и забираться наверх. Если первая попытка не удавалась, он мог переставить рампу ближе и попробовать снова. По данным авторов, укрытия появились к четвёртому раунду, а использование рампы — к десятому.
Для сравнения: в более раннем исследовании игры в прятки агенты, обучавшиеся с нуля методом обучения с подкреплением, осваивали укрытия примерно за 25 миллионов эпизодов, а рампы — примерно за 100 миллионов. Это не прямое сравнение двух методов. Новые агенты уже имеют общие знания об объектах и пространстве благодаря предварительному обучению; их задача — применить эти знания в конкретной среде и исправлять ошибки действий.
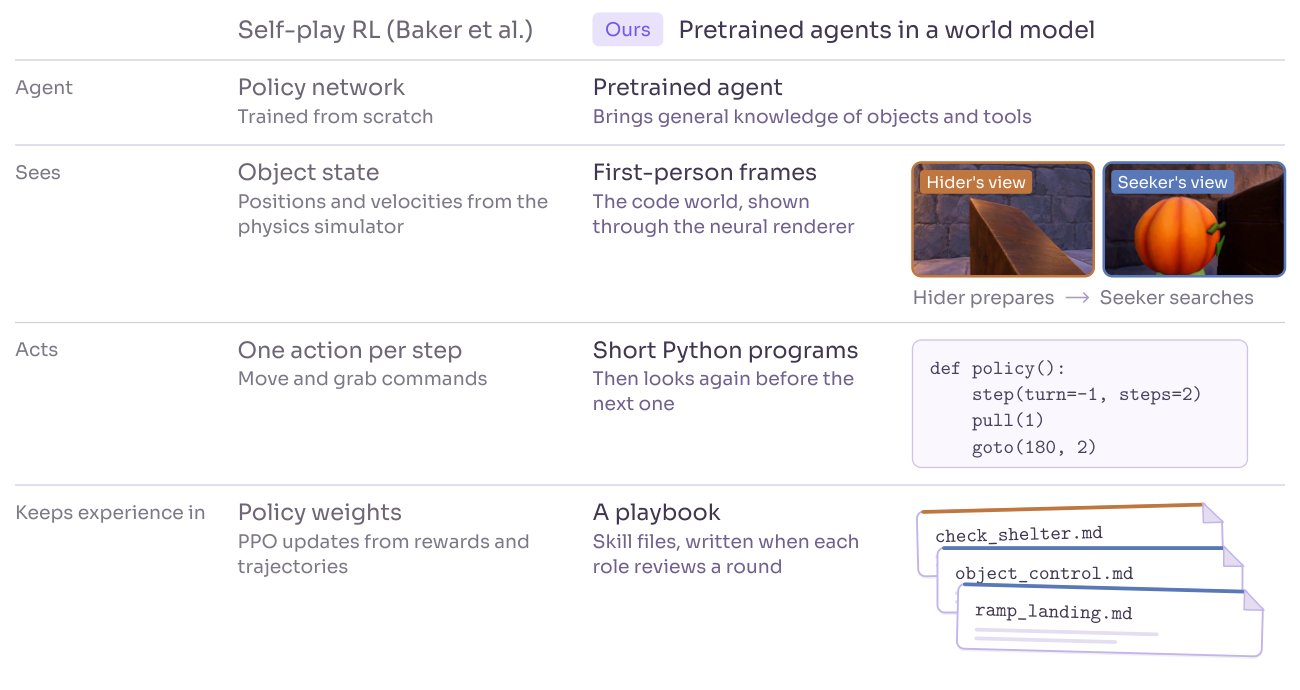
В игре в прятки агенты видят мир от первого лица и осваивают укрытия и рампы, записывая опыт для следующих раундов.
Тот же подход проверили ещё в четырёх мирах: с собакой, с которой нужно поддерживать контакт; с узким мостом, по которому должны разъехаться две машины; в пастушьей задаче; и с погрузчиком в карьере. Во всех случаях агенты получали описание цели, доступных действий и ограничений, но не готовое решение.
Результаты менялись от задачи к задаче. На мосту время проезда сократилось с 71 до 41 секунды. В пастушьей задаче агенты стали загонять в загон всех четырёх овец. В карьере прогресс оказался неровным: во втором раунде погрузчик не набрал очков, зато в четвёртом доставил камень в бункер и завершил задание почти в пределах отведённого времени.
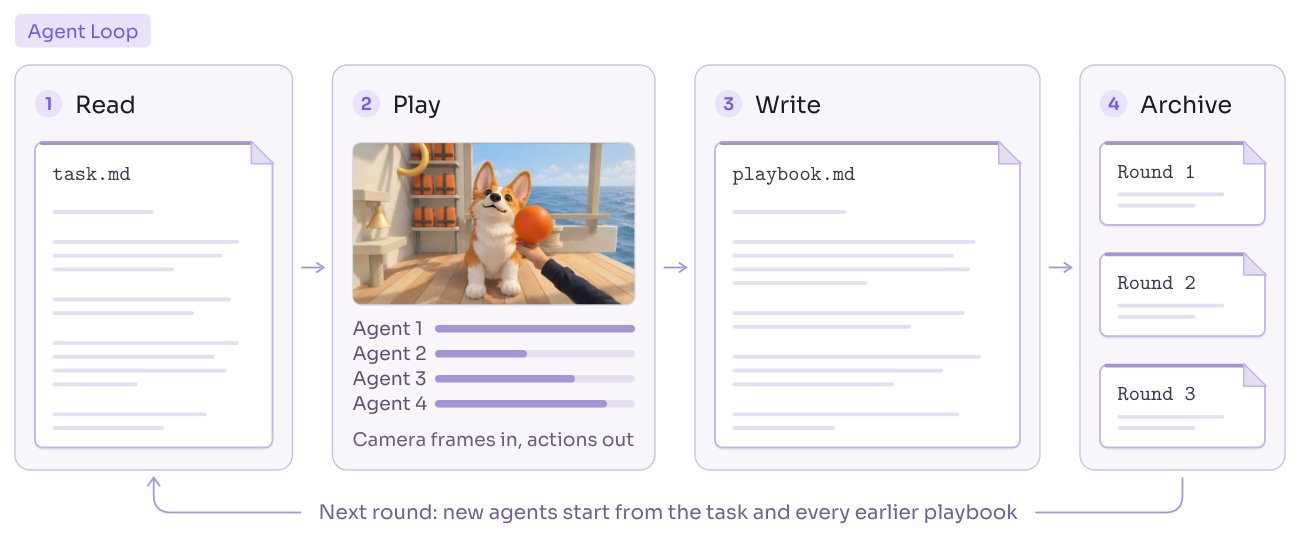
После каждой попытки агент записывает выводы, которые наследуют участники следующего раунда.
Где проходят границы подхода
AgentGarten соединяет управляемость симулятора с гибкостью создания видео. Но нейросетевой рендерер передаёт не всё, что знает движок. Глубина и нормали хорошо описывают форму и положение, но не всегда позволяют понять, что именно происходит. Например, по геометрии можно не заметить вращение симметричного предмета, если его внешний контур не меняется. Цвет, материал и небольшие детали тоже могут теряться, особенно после долгого исчезновения объекта из кадра.
Есть ограничения и у проверки обучения агентов. Работа показывает, что агенты справляются с несколькими специально созданными мирами и улучшаются за несколько раундов. Но это ещё не доказывает, что они смогут так же учиться в незнакомых средах или надёжно переносить навыки между задачами. Сейчас записи привязаны к отдельным мирам. Если таких сред станет много, агентам придётся выбирать, какие заметки полезны для текущей ситуации, а какие устарели.
Наконец, среду нужно сначала создать. Авторы хотят поручить эту работу агентам для программирования и автоматически проверять, достаточно ли мир понятен, решаем и полезен для обучения. Иначе можно быстро получить много сцен, в которых нечему учиться или правила плохо согласуются с тем, что видит агент.
Вывод
AgentGarten предлагает способ расширить среду для обучения ИИ-агентов: правила остаются в исполняемом коде, а изображение создаёт общая видеомодель. В такой среде агент видит последствия действий, пробует снова и передаёт опыт другим через записи навыков.
Пока показаны отдельные задачи, а разница между несколькими раундами и миллионами эпизодов относится к разным схемам обучения. Но сама идея ясна: если можно быстрее создавать новые миры и показывать их агенту в реальном времени, можно чаще проверять, какие навыки он действительно приобрёл и способен ли применить их в следующей задаче.
Читайте также
 Как помочь ИИ-агенту не теряться в большом проекте
 Как виртуальная компания учит агентов учитывать реакцию рынка
 Как ИИ-агент учится решать задачи на чужом опыте
 Как собрать видео из таблицы без долгого монтажа
 Как проверить, справился ли ИИ-агент с задачей
 Можно ли автоматически собрать нужных ИИ-агентов по ходу работы
 Как тысяча ИИ-агентов работают вместе без начальника
 Как дать ИИ-агенту больше свободы с меньшим риском
 Как ИИ-агент подбирает прошлый опыт под новую задачу
 ИИ-судья сохраняет 99% точности за меньшие деньги
 Как самоулучшение ИИ-агента улучшает результаты и экономит токены
 Почему ИИ-агентам трудно работать с разными данными
ИИ-обзоры простыми словами
Каждый день читаем свежие статьи об ИИ и пересказываем главное естественным языком — без хайпа и воды. Если хотите понимать, куда движутся ИИ-агенты раньше остальных, — подписывайтесь.
Новые обзоры — каждый день
В Telegram