Агент учится на общих навыках
В одном бенчмарке нужно разгадывать правила настольной игры, в другом — проходить лабиринт, в третьем — управлять роботом. На первый взгляд, это совсем разные задачи. Но за каждой может стоять одна и та же способность: следить за состоянием мира и не забывать, что изменилось после действия.
На этом наблюдении построена The Trinity — система, которая улучшает обвязку ИИ-агента не отдельно для каждой задачи, а с учётом общих требований к способностям. Авторы оставили саму модель неизменной. Менялись инструменты и правила, которые направляют её работу: как собирать факты, проверять варианты, планировать действия и решать, когда пора остановиться.
В результате система улучшила средний результат на 34 пункта на 28 обучающих бенчмарках и на 26 пунктов на 18 ранее не встречавшихся. Среди проверок были и задачи на настоящих роботах.
Почему задачам нужны общие способности
Многие современные ИИ-агенты должны работать долго и в разных форматах: читать текст, разбирать изображения и видео, выбирать действия и учитывать их последствия. Ошибка на раннем шаге может испортить всё продолжение: агент неверно понял сцену, сделал неподходящий ход, а затем строит план на ошибочном представлении.
Обычно такую проблему решают отдельно для каждого набора задач. Но отдельные настройки плохо переносятся на другие условия. И одна общая обвязка тоже может быть неудобна: задачи требуют разных навыков и иногда спорят друг с другом. Например, осторожность помогает не делать необратимых ходов, но может мешать действовать быстро.
Авторы предлагают группировать задачи по нужным способностям, а не по внешнему сходству. Разгадывание сетки и движение по лабиринту выглядят по-разному. Но обе задачи требуют замечать изменения и вести точный учёт состояния. Если обучить этому общему навыку, он может помочь сразу в нескольких средах.
В системе задействованы три роли:
🟠 Создатель придумывает небольшие учебные миры с понятными правилами и проверяемыми результатами.
🟠 Исследователь проходит эти миры и собирает примеры удачных и неудачных действий.
🟠 Эволюционер разбирает эти примеры, группирует задачи по нужным способностям и предлагает изменения обвязки.
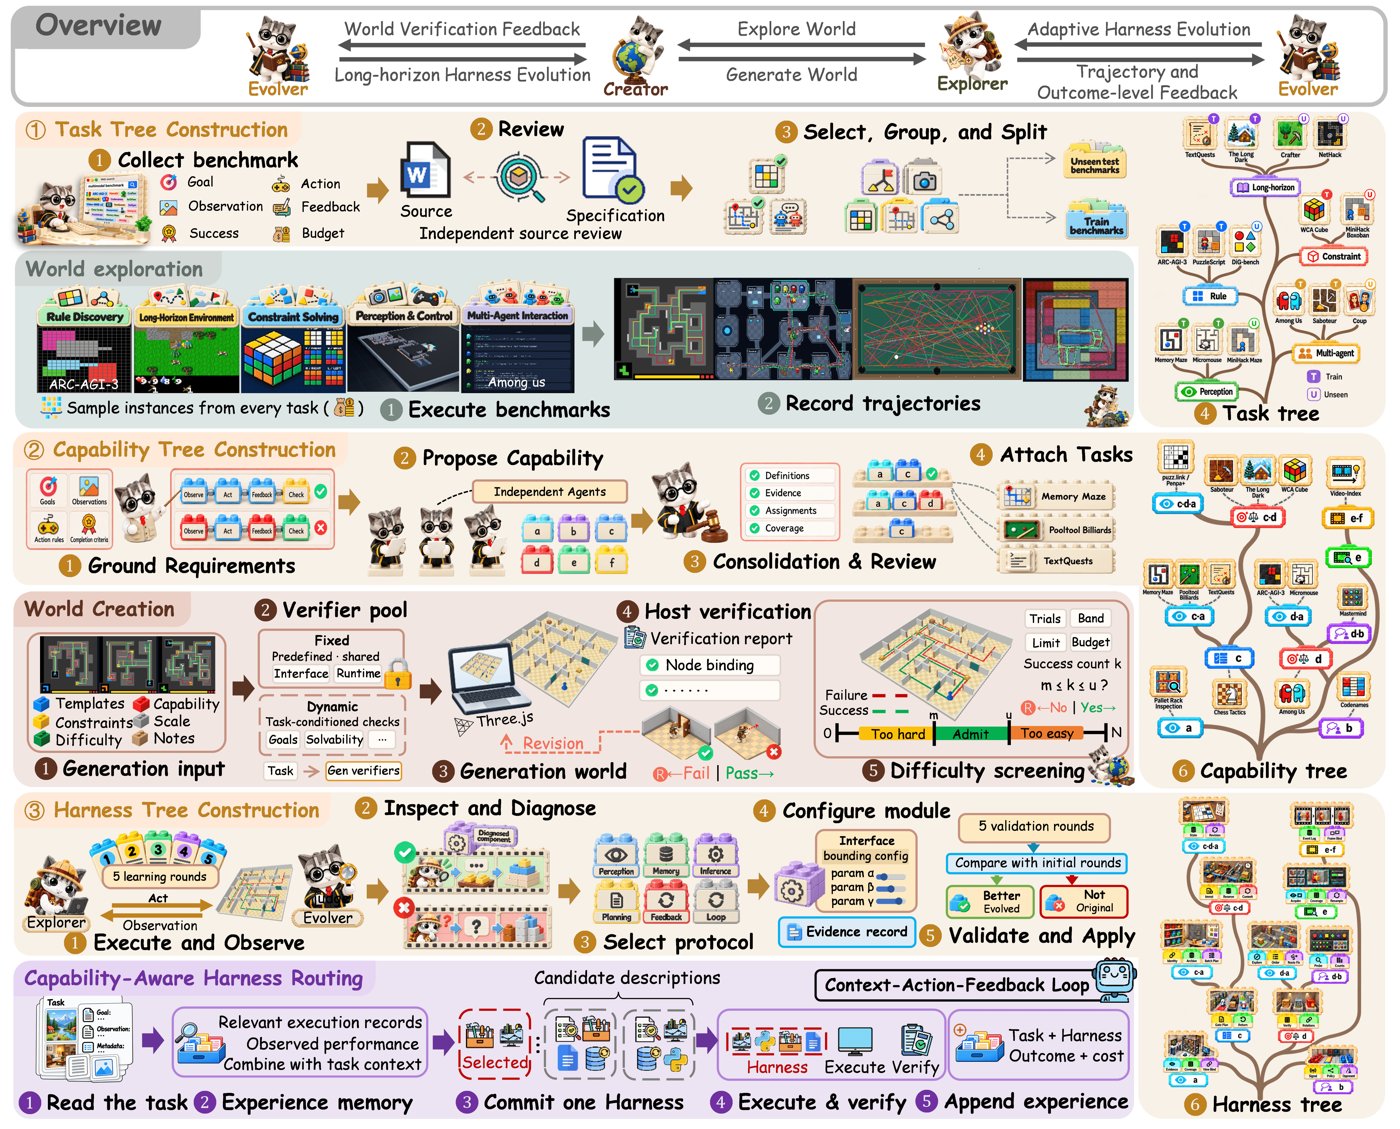
Три роли системы связывают задачи, учебные миры и развитие обвязки ИИ-агента.
Как способности превращаются в модули
Сначала команда собрала 44 бенчмарка: 28 для обучения и 18 для проверки на новых задачах. Они охватывают головоломки, видеозадачи, игры с другими участниками, управление и робототехнику. Часть сред исследователи воссоздали по опубликованным правилам.
Затем систему запускали на обучающих задачах и изучали записи её действий. Так исследователи выделили шесть общих способностей: отслеживание восприятия и состояния, проверку гипотез, работу с ограничениями, выбор цели, поиск нужных кадров в видео и понимание событий между кадрами.
Из этих способностей собрали дерево. Узел отвечает за сочетание требований, а задачи из разных областей могут оказаться в одной ветке. Например, планирование, осмотр объектов и движение по лабиринту могут требовать похожего контроля состояния и проверки результата. Дерево фиксирует общие навыки, а не внешнее сходство задач.
Дальше для каждого узла Создатель строит упрощённый учебный мир. Если нужная способность — проверять, действительно ли цель достигнута, среда может учить этому на простой задаче с предметами и правилами. Она должна быть достаточно понятной для проверки, но при этом сохранять ключевую логику исходных задач. Результаты затем измеряют на первоначальных бенчмарках: так проверяют, перенёсся ли навык за пределы учебного мира.
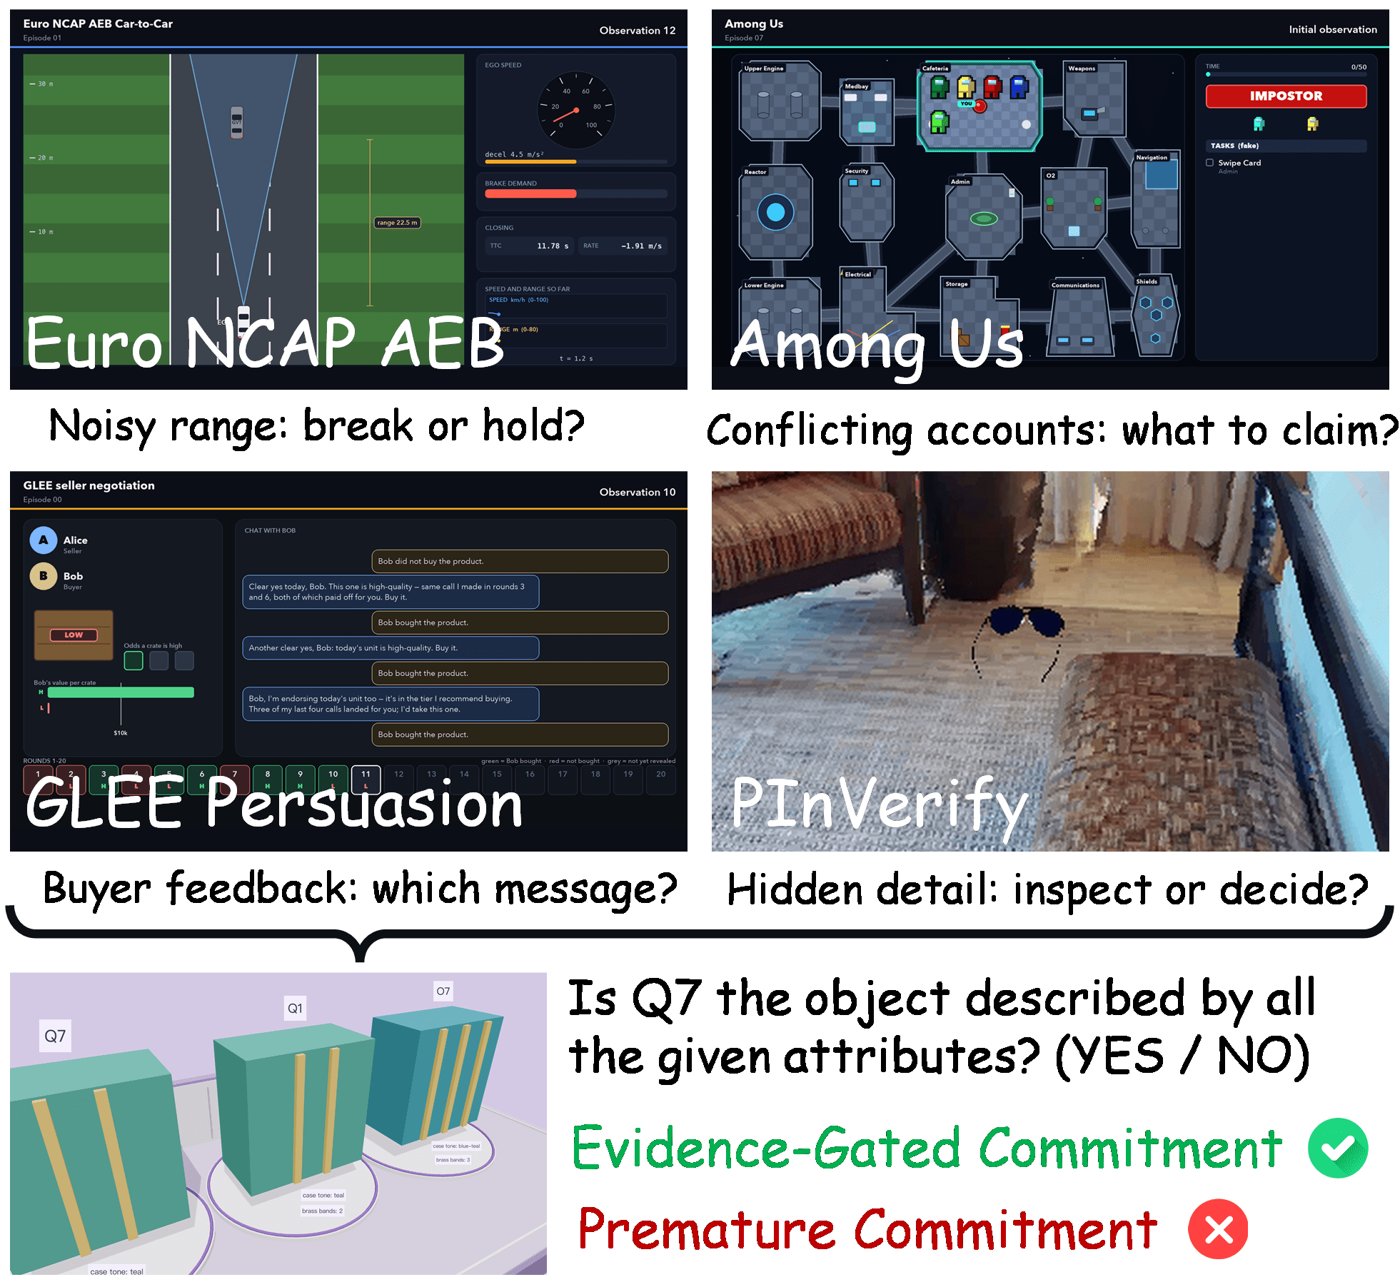
Учебный мир создаётся из общей способности, нужной нескольким разным задачам.
Сама обвязка состоит из модулей: одни помогают воспринимать данные, другие — вести память, проверять гипотезы или выбирать действия. ИИ-агент не меняет веса модели. Он улучшает эти модули по записям взаимодействий: сравнивает успешные и неудачные попытки и предлагает точечные изменения.
Новые модули проходят проверки: у них должны быть понятные входы и выходы, они должны опираться на реальные примеры и соответствовать версии, которую заменяют. Дочерние ветки дерева могут наследовать модули родителей, но сохранять собственные настройки. Так формируются разные обвязки для разных сочетаний способностей.
Это решает ещё одну задачу: не нужно каждый раз собирать всю систему заново. Модуль, который помогает отслеживать состояние, можно повторно использовать в нескольких ветках. А неподходящие решения не обязаны распространяться на все задачи.
Что показали эксперименты
Авторы сравнили разные способы организации обвязок. Один общий набор модулей, отдельная настройка для каждой категории задач и группировка по способностям давали разные результаты. Лучше всех на новых задачах показало себя дерево способностей, обучавшееся в созданных системой мирах: оно набрало 47,26 пункта против 42,92 у общей обвязки. На обучающих задачах результат составил 56,95 против 53,04.
Затем систему улучшали в течение четырёх циклов. Средний результат на обучающей выборке вырос с 39,1 до 73,2 пункта, на новых задачах — с 42,1 до 64,1. Самый большой прирост пришёлся на первый цикл, но следующие три тоже добавили очки.
Улучшение распределилось неравномерно. Например, результат в ARC-AGI-3 вырос с 41,0 до 53,6 пункта, а в SciGym — с 45,2 до 57,1. На бенчмарке Eleusis итог, напротив, оказался немного ниже, чем после первого цикла. Средние значения скрывают такие различия, поэтому их важно смотреть вместе с результатами отдельных задач.
Маршрутизатор выбирает подходящую обвязку для каждой задачи по открытым данным о ней и проверенному опыту прошлых запусков. На обучающих бенчмарках он набрал 71,27 пункта, на новых — 60,96. Для сравнения, подбор лучшей обвязки задним числом давал 73,16 и 63,61 пункта соответственно. Значит, выбор можно автоматизировать почти без потери результата. Маршрутизатор при этом не получает правильные ответы из проверочной выборки: он использует только доступное описание задачи и опыт, собранный на обучающих запусках.
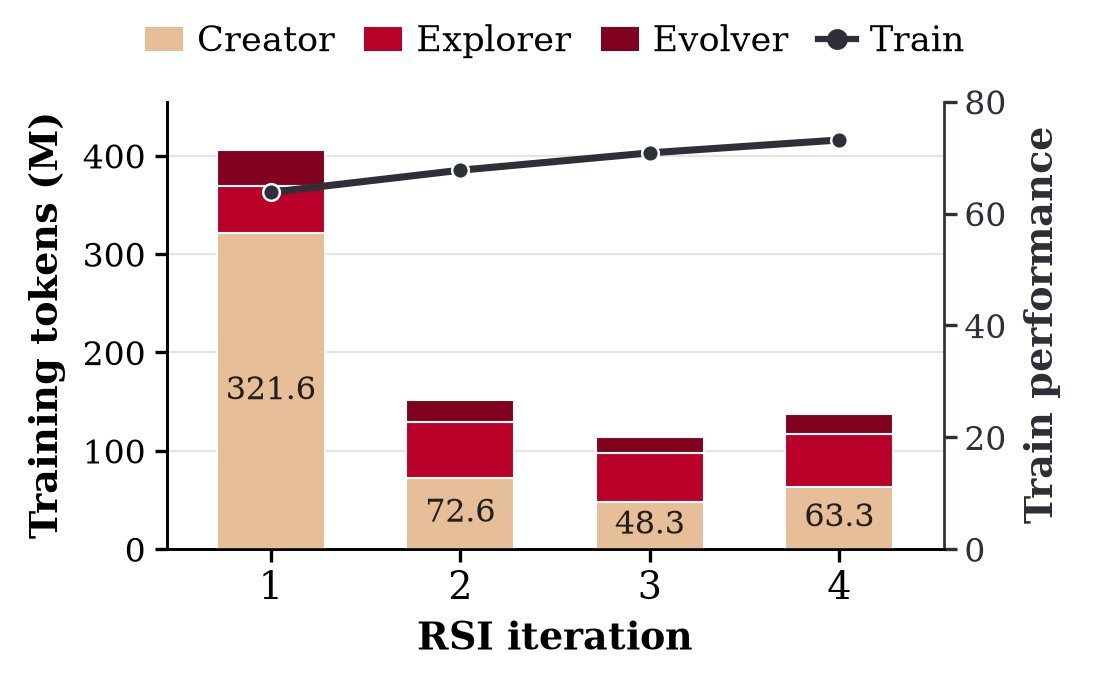
Средние результаты растут с каждым циклом, а стоимость повторного обучения снижается при повторном использовании учебных миров.
Отдельно проверили, помогают ли подходящие модули сами по себе. Добавление модуля, связанного с нужной способностью, подняло результат базовой обвязки на 19,39 пункта. Случайный модуль, не связанный с задачей, дал прирост только в 1,02 пункта. А удаление подходящего модуля из улучшенной обвязки снизило результат на 2,74 пункта. Это подтверждает, что модули стоит подбирать под требуемые способности, а не наращивать без разбора.
Наконец, эволюционировавшие обвязки проверили на двух роботах. В одном опыте робот должен был подойти к столу и дотянуться до него. В другом — найти кубик, спрятанный под чашками, и определить его цвет и положение. На версиях, обученных системой, роботы чаще успешно выполняли обе задачи в симуляции и в реальности. Например, в задаче с чашками базовая обвязка могла заявить, что кубика нет, так и не осмотрев нужную чашку. Улучшенная последовательно проверяла предметы и отвечала после того, как находила кубик.
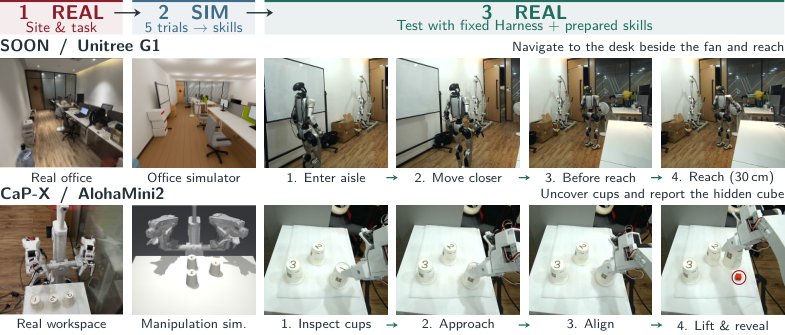
Робот с улучшенной обвязкой точнее подходит к цели и проверяет чашки, прежде чем сообщить, где находится кубик.
Чего результаты пока не доказывают
Эксперименты показывают рост средних результатов и перенос на новые задачи, но не гарантируют одинакового улучшения во всех областях. В отдельных бенчмарках прогресс небольшой, а некоторые задачи — например Crafter и DiG-bench — система решала хуже двух систем сравнения.
Результаты по робототехнике тоже стоит рассматривать с учётом устройства проверки. Авторы сравнивали целые связки «обвязка плюс подготовленные навыки», поэтому нельзя точно отделить вклад модулей от вклада этих навыков. Кроме того, физических задач было только две, а число испытаний на них ограничено.
Есть и практический компромисс: создание учебных миров требует ресурсов. Авторы отмечают, что в первом цикле генерация сред составляла значительную часть затрат, зато позднее среды можно было использовать повторно. Подход становится выгоднее, если учебный мир помогает улучшать обвязку в нескольких циклах и переносить результат на разные задачи.
Вывод
The Trinity переносит развитие ИИ-агента с уровня отдельных задач на уровень общих способностей. Вместо того чтобы писать специальную обвязку для каждой игры, головоломки или робота, система ищет повторяющиеся требования, создаёт для них проверяемые учебные миры и постепенно улучшает подходящие модули.
Результаты на новых бенчмарках и роботах показывают, что такой перенос возможен. Но система пока не улучшает все задачи одинаково, а оценка в робототехнике охватывает только два сценария. Следующий шаг — проверить, насколько хорошо дерево способностей расширяется на новые требования и работает в более широком наборе реальных условий.
Читайте также
 Как понять, что ИИ-агент выполняет задачу неправильно
 Как ИИ-агенту освоить новый навык на практике методом Сократа
 Как ИИ-агент сам улучшает интерфейсы
 Как ИИ предсказывает мозговую активность
 ИИ-агенту не нужны готовые ответы, чтобы становиться лучше
 Как ИИ-агент меняется без переобучения модели
 Как четыре ИИ-агента победили дракона в Minecraft
 Реальные клиенты ставят ИИ-агентов в тупик
 Рассуждения без слов улучшили ответы ИИ-агента на 10% и снизили расходы почти в 4 раза
 Опыт человека помогает ИИ-агенту справляться с незнакомыми программами
 182 приложения помогли ИИ-агентам решать незнакомые задачи
 Как виртуальные миры помогают агентам учиться быстрее
ИИ-обзоры простыми словами
Каждый день читаем свежие статьи об ИИ и пересказываем главное естественным языком — без хайпа и воды. Если хотите понимать, куда движутся ИИ-агенты раньше остальных, — подписывайтесь.
Новые обзоры — каждый день
В Telegram