Как научить модель предсказывать ответы мозга
Пока человек смотрит сериал, его мозг обрабатывает изображение, речь, музыку и смысл происходящего. Можно ли по самому видео, звуку и субтитрам предсказать, как в этот момент изменится активность разных областей мозга?
Такие модели уже умеют строить. Но обычно их обучают осторожно: берут большую нейросеть, оставляют её веса неизменными и учат только небольшой модуль, который переводит внутренние представления модели в сигналы мозга. Новый подход предлагает дать данным мозга немного изменить саму нейросеть — и показывает, что для этого не нужно переобучать её целиком.
В статье исследователи применили малое дообучение к мультимодальным моделям, которые понимают видео, аудио и текст. На данных магнитно-резонансной томографии мозга во время просмотра фильмов этот подход улучшил предсказания на девяти моделях. Специальная схема вычислений помогла обучать их быстрее и собирать ансамбли из сотен вариантов.
Зачем менять большую модель
Модель кодирования мозга получает стимул — например, сцену из фильма — и предсказывает реакцию мозга. Для этого ей нужны хорошие представления о том, что происходит на экране и в звуке. Большие предварительно обученные модели уже умеют извлекать такие признаки, поэтому исследователи часто оставляют их неизменными и обучают только выходной слой.
Это бережёт данные. Записи активности мозга дороги, а примеров обычно слишком мало, чтобы надёжно обновлять миллиарды параметров. Полное дообучение может потратить эти данные впустую и ухудшить результат. Но у замороженной модели есть обратная проблема: её представления не приспособлены специально для предсказания мозга.
Авторы предлагают промежуточный вариант. Веса большой модели остаются на месте, но небольшие добавочные модули учатся подстраивать её работу. Один из таких методов называется LoRA. Его идея — внести в модель ограниченное изменение, которое задаётся небольшим числом параметров. Так данные мозга влияют на представления, но модель не приходится обучать заново целиком.
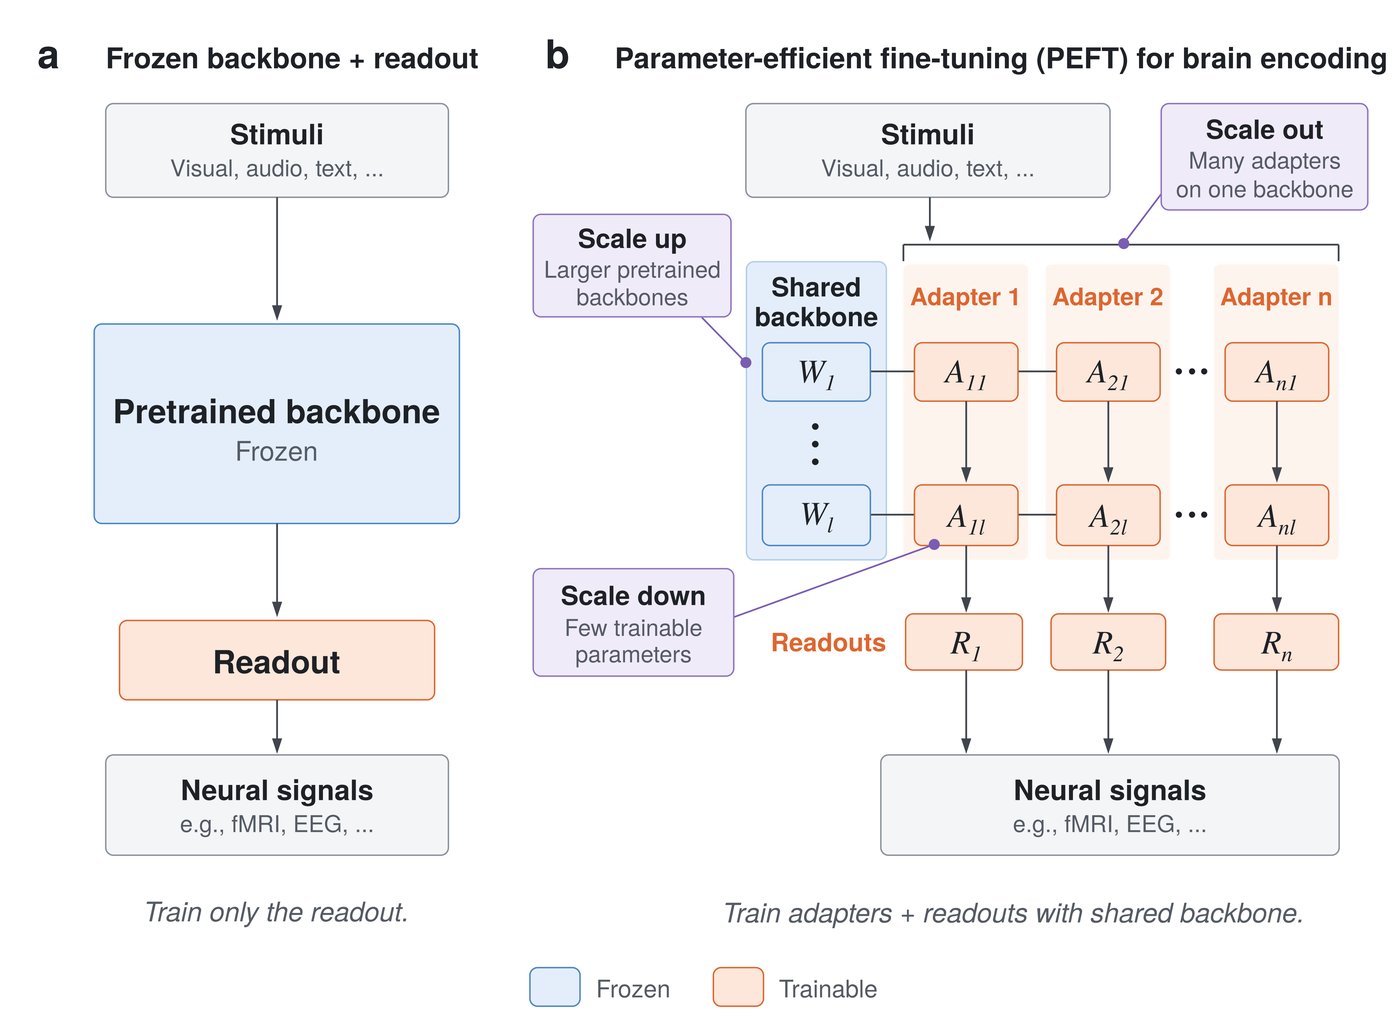
Модель можно оставить замороженной или адаптировать небольшими модулями; подход масштабируют за счёт более крупных моделей и множества специализированных вариантов.
Как сократить вычисления в 350 раз
Эксперименты проводили на записях активности мозга четырёх людей, которые смотрели эпизоды сериала «Друзья». Данные разделили на обучающую часть, проверку на шестом сезоне и тест на седьмом сезоне. Отдельно оценили перенос на фильмы другого типа. Активность мозга представили в виде сигналов для тысячи областей.
Главная вычислительная трудность — длина видео. Чтобы предсказать сигнал мозга в конкретный момент, прежний подход снова и снова обрабатывал перекрывающиеся отрывки фильма. Один и тот же контекст попадал в модель сотни раз. Авторы заменили эту схему одним проходом по временному окну: модель получает отрывок целиком и сразу выдаёт признаки для многих моментов.
Такое ускорение возможно благодаря устройству модели. Она обрабатывает последовательность с причинной маской: при вычислении представления для одного момента не должна использовать будущие слова и кадры. Значит, вычисления для соседних моментов можно переиспользовать, вместо того чтобы каждый раз начинать обработку окна заново.
На одной видеокарте извлечение признаков сократилось примерно с 700 до 2 часов. Это ускорило именно обработку видео и звука: обучение всей системы заняло около 8,5 часа против примерно 702 часов у прежней схемы. Разница в качестве тоже важна. Одного прохода без дополнительного контекста оказалось недостаточно, особенно в начале окна. Авторы добавили до минуты материала перед целевым отрывком — так модель получала нужный контекст и сохраняла точность.
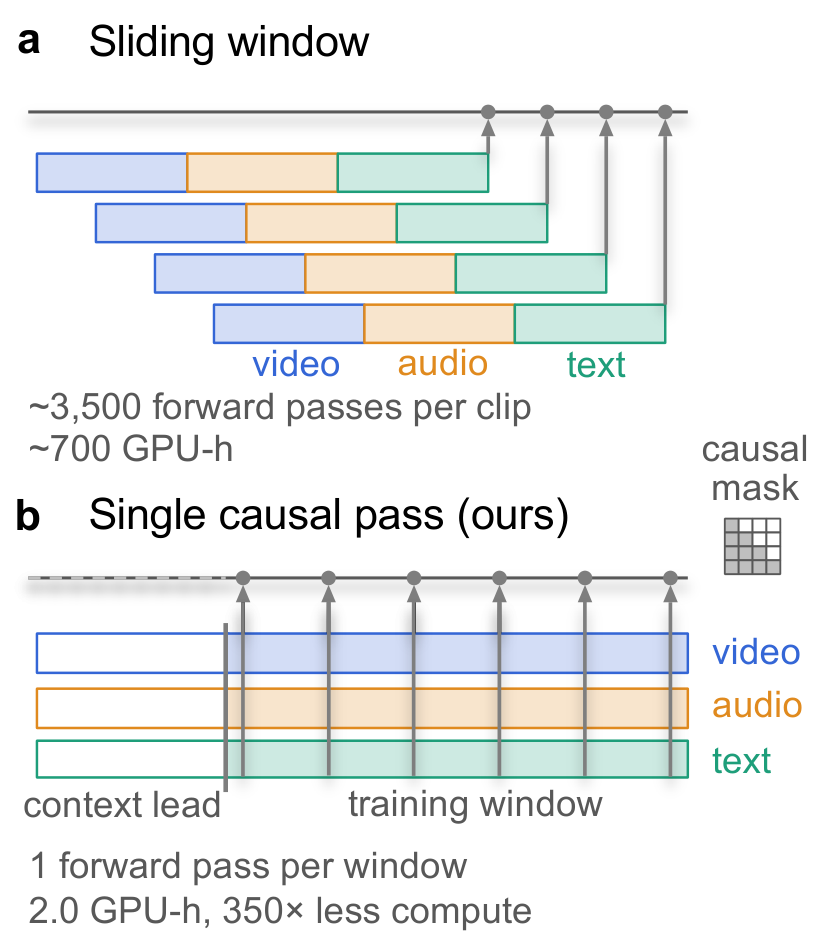
Один проход по временному окну заменяет повторную обработку перекрывающихся отрывков.
Малое дообучение улучшает предсказания
В основном эксперименте исследователи добавили модули LoRA в модель Qwen3-Omni и обучили их вместе с компактным выходным слоем. Всего обучались 61,2 миллиона параметров. У прежнего лидирующего подхода, который оставлял большую модель замороженной, выходной модуль содержал 1,1 миллиарда параметров.
На тесте с новыми эпизодами новая модель получила корреляцию 0,327 между предсказаниями и измеренной активностью мозга. Предыдущий результат составлял 0,310. На новых фильмах, которые модель не видела при обучении, показатели составили 0,228 и 0,217 соответственно. Корреляция показывает, насколько похожи изменения предсказанного и измеренного сигналов.
Разница не ограничилась одной моделью. Исследователи проверили девять мультимодальных моделей размером от 4,7 до 104 миллиардов параметров. Малое дообучение улучшило результат каждой из них. При этом размер модели сам по себе не объяснял качество: больше параметров не всегда означало более точное предсказание.
Авторы также сравнили LoRA с полным дообучением. Полное обновление модели с 20,3 миллиарда параметров не дало преимущества, хотя требовало обучать в 330 раз больше параметров. Для имеющегося объёма данных небольшого изменения оказалось достаточно.
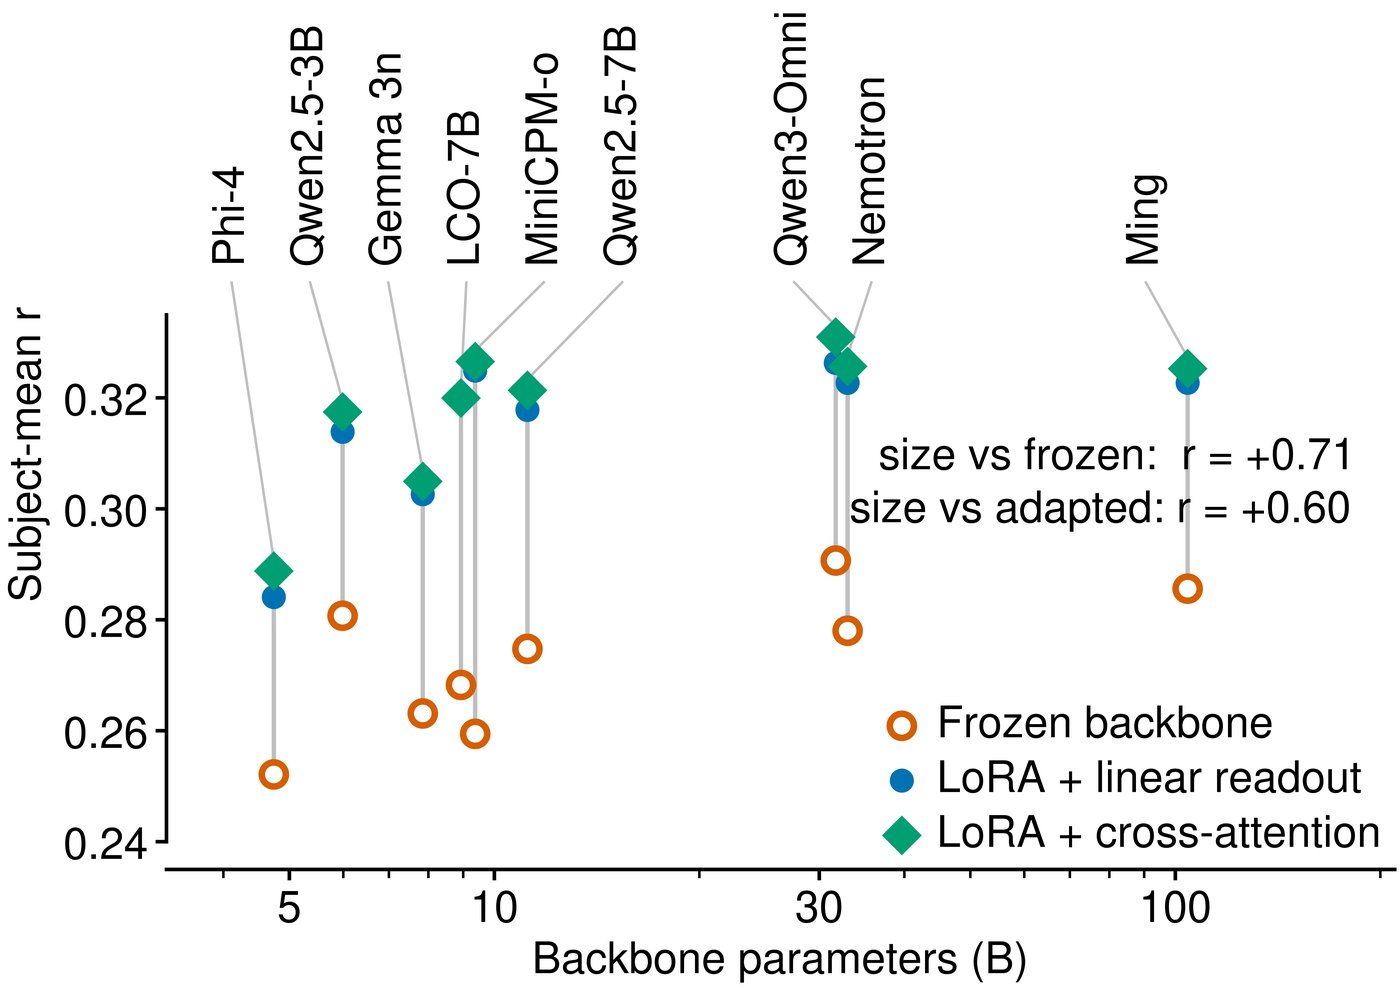
Добавочные модули улучшили результаты на всех девяти проверенных моделях.
Есть и проверка на перенос. Модель, обученная на данных трёх участников, почти полностью сохраняла прирост на четвёртом, которого она не видела при дообучении. Авторы также испытали её на другом наборе данных — с другими участниками, сканером и фильмом. Без дополнительного обучения новый модуль увеличил долю объяснённого сигнала мозга на 11,1 процентного пункта относительно предельного уровня, заданного шумом измерений.
Что модель узнаёт о мозге
Мультимодальная модель смешивает информацию из изображения, звука и текста. Поэтому по её ответу не сразу понятно, какой вход повлиял на предсказание активности конкретной области мозга. Авторы оценили вклад каждого потока отдельно: по очереди убирали содержимое видео, аудио и текста и измеряли, как меняется качество предсказания.
Распределение получилось знакомым нейробиологам. Зрительная кора в основном реагировала на видео, а слуховая — на аудио. В боковых височных областях звук тоже оказался важнее текста. Значит, даже внутри общей мультимодальной модели можно выделить связи между типом стимула и участком мозга.
После дообучения доля аудио в предсказаниях выросла в среднем на 39%, а доля текста снизилась на 17%. Изменилась и работа самой модели: информация из одного потока чаще попадала в представления, связанные с другим. Например, содержимое видео могло влиять на признаки, расположенные на месте аудиотокенов.
Это не означает, что модель воспроизводит работу мозга. Авторы показывают более ограниченный результат: небольшое дообучение меняет то, как модель использует разные виды входных данных, и эти изменения связаны с тем, какие сигналы помогают предсказывать активность отдельных областей.
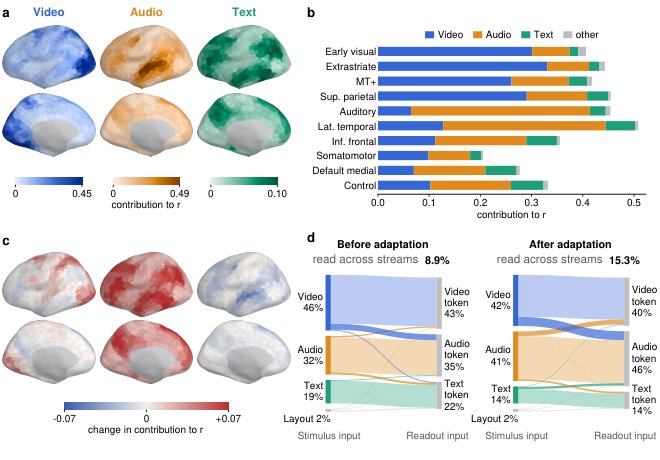
Анализ вкладов связывает видео, аудио и текст с разными областями мозга и показывает, как дообучение меняет их сочетание.
Зачем обучать сотни моделей
Даже точная модель может ошибаться там, где другая справляется лучше. Поэтому авторы обучили 261 вариант с разными настройками, выходными слоями и базовыми моделями, а затем объединили их предсказания.
Чтобы обучение не превратилось в сотни отдельных прогонов, исследователи создали вычислительное ядро для одновременной работы с разными наборами LoRA. На одном и том же общем основании оно обновляет много адаптеров за один проход. При 32 адаптерах такой шаг был почти в 30 раз быстрее последовательного обучения. По времени он стоил примерно столько же, сколько обучение одного адаптера на той же совокупности примеров.
Ансамбль из 261 модели достиг корреляции 0,343 на новых эпизодах и 0,248 на новых фильмах. Авторы сообщают, что на момент подготовки статьи это был лучший результат в открытом рейтинге соревнования «Алгонавты». Но точность ансамбля зависела не только от количества моделей, но и от качества отдельных участников и от того, насколько по-разному они ошибались. Новые выходные слои и базовые модели давали больше разнообразия, чем смена случайного начального состояния.
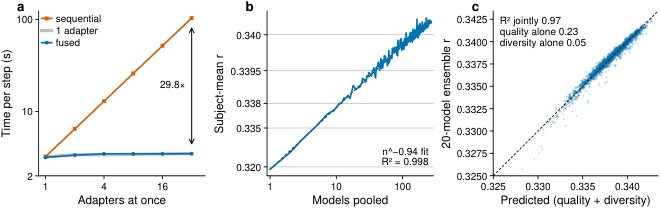
Совместное обучение множества адаптеров ускоряет сборку ансамбля, а его точность зависит от числа моделей, их качества и разнообразия ошибок.
Вывод
Большую модель можно приспособить к ограниченным данным мозга, не обновляя её целиком. В этих опытах малое дообучение улучшило предсказания на девяти мультимодальных моделях и превзошло предыдущий подход, обучая намного меньше параметров. Однопроходная обработка видео снизила вычислительные затраты, а совместное обучение адаптеров позволило собрать большой ансамбль.
Результаты пока ограничены: основная проверка опирается на фильмы и данные четырёх участников. Перенос на другой набор данных обнадёживает, но не показывает, как метод сработает на других видах стимулов и записях мозга. Работа предлагает практичный путь: использовать сильную готовую модель, менять её небольшими модулями и собирать разные варианты там, где особенно важно качество предсказаний.
Читайте также
 ИИ-агенту не нужны готовые ответы, чтобы становиться лучше
 Как ИИ-агент меняется без переобучения модели
 Как четыре ИИ-агента победили дракона в Minecraft
 Реальные клиенты ставят ИИ-агентов в тупик
 Рассуждения без слов улучшили ответы ИИ-агента на 10% и снизили расходы почти в 4 раза
 Опыт человека помогает ИИ-агенту справляться с незнакомыми программами
 182 приложения помогли ИИ-агентам решать незнакомые задачи
 Как виртуальные миры помогают агентам учиться быстрее
 Как помочь ИИ-агенту не теряться в большом проекте
 Как виртуальная компания учит агентов учитывать реакцию рынка
 Как ИИ-агент учится решать задачи на чужом опыте
 Как собрать видео из таблицы без долгого монтажа
ИИ-обзоры простыми словами
Каждый день читаем свежие статьи об ИИ и пересказываем главное естественным языком — без хайпа и воды. Если хотите понимать, куда движутся ИИ-агенты раньше остальных, — подписывайтесь.
Новые обзоры — каждый день
В Telegram