Интерфейс, который учится вместе с ИИ-агентом
Представьте, что вы просите агента сверить письма с банковскими операциями. Он открывает почту, нажимает на письма, прокручивает страницы и переносит данные на глаз. Хотя нужная информация уже есть в почте, агент не умеет получить её одним запросом.
Такие обходные пути — обычная проблема компьютерных агентов. Им приходится работать через заранее заданные кнопки, снимки экрана и инструменты. Если интерфейс неудобен, модель может хорошо рассуждать, но всё равно тратить десятки шагов на простые действия.
Авторы статьи предлагают изменить сам способ доступа агента к компьютеру. Их система Agent S4 изучает попытки агента, замечает повторяющиеся трудности и создаёт новые программные интерфейсы. Например, вместо нажатий на письма такой интерфейс может сразу вернуть их список и содержимое в виде текста.
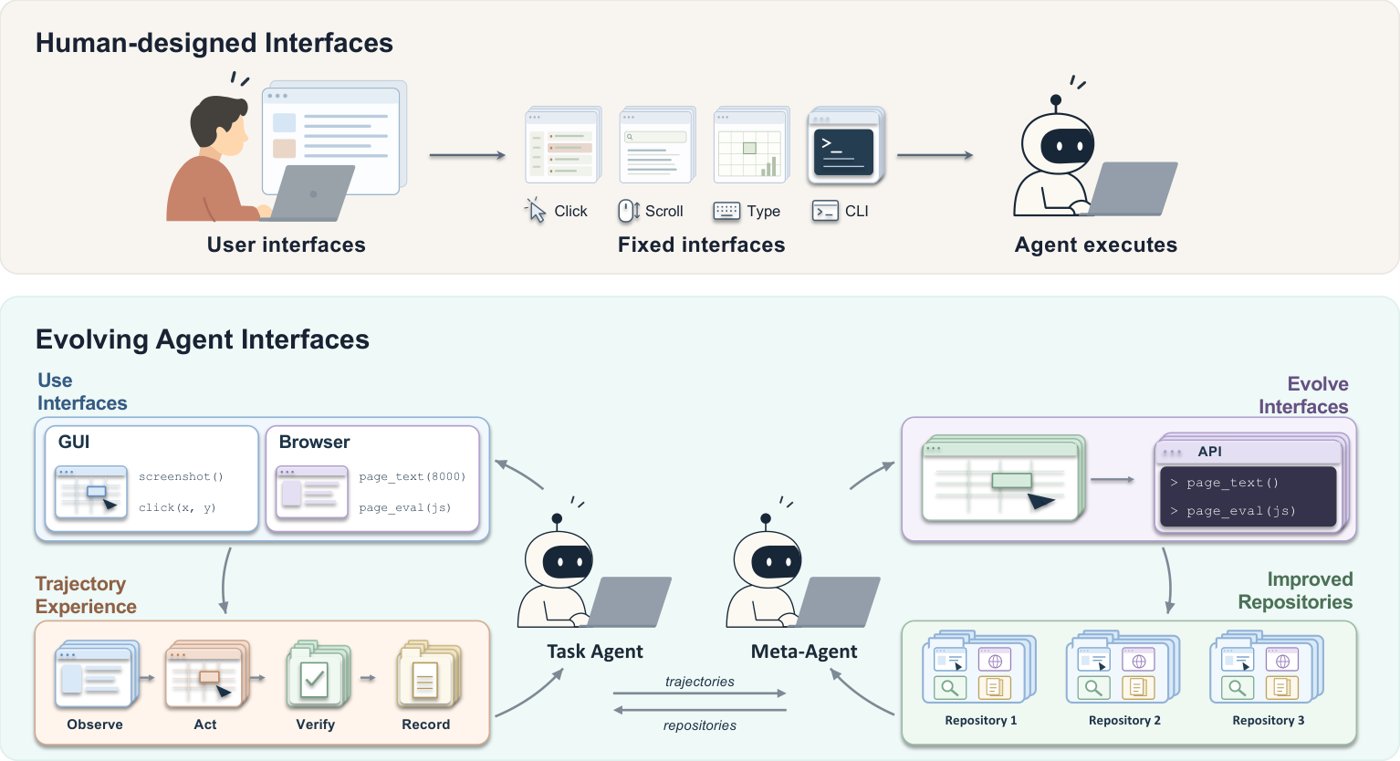
Agent S4 изучает попытки агента и меняет набор доступных ему интерфейсов.
Интерфейсы становятся частью обучения
Обычно способы взаимодействия с компьютером проектируют люди. Они решают, какие действия доступны агенту, какую информацию тот получает в ответ и как пользоваться инструментами. Сама модель может меняться, но набор интерфейсов часто остаётся прежним.
Из-за этого агенту приходится приспосабливаться к ограничениям инструментов. Чтобы изменить таблицу, он может нажимать на ячейки и проверять результат по снимкам экрана, хотя мог бы сразу передать программе диапазон данных. Чтобы найти нужную функцию в файле, он может вывести в окно терминала весь его текст.
Agent S4 предлагает поручить агентам улучшение интерфейсов. Результат сохраняется в репозитории: там лежат программный код инструментов и пояснения, которые помогают понять, когда и как их применять. Модель и её обвязка при этом остаются прежними. Меняется то, что агент может увидеть и сделать.
Систему составляют два агента. Первый выполняет задачи на компьютере. Второй — метаагент — изучает записи этих попыток и вносит изменения в репозиторий. Он может добавить интерфейс, изменить существующий или объединить решения из двух разных вариантов.
Метаагент не получает правильных ответов на учебные задачи и не знает, успешно ли агент выполнил каждую из них. Он видит ход работы: действия, снимки экрана, вывод инструментов и ошибки. По этим данным он ищет повторяющиеся проблемы. Например, если агент много раз вручную редактирует отдельные ячейки, можно создать функцию для массового изменения таблицы.
Новые версии проверяют на отдельных проверочных задачах. Их промты, результаты и объяснения ошибок скрыты от метаагента. Проверочные задачи влияют только на выбор версий, которые система будет развивать дальше. Так авторы стараются снизить риск, что новый интерфейс поможет только на задачах, для которых его создали.
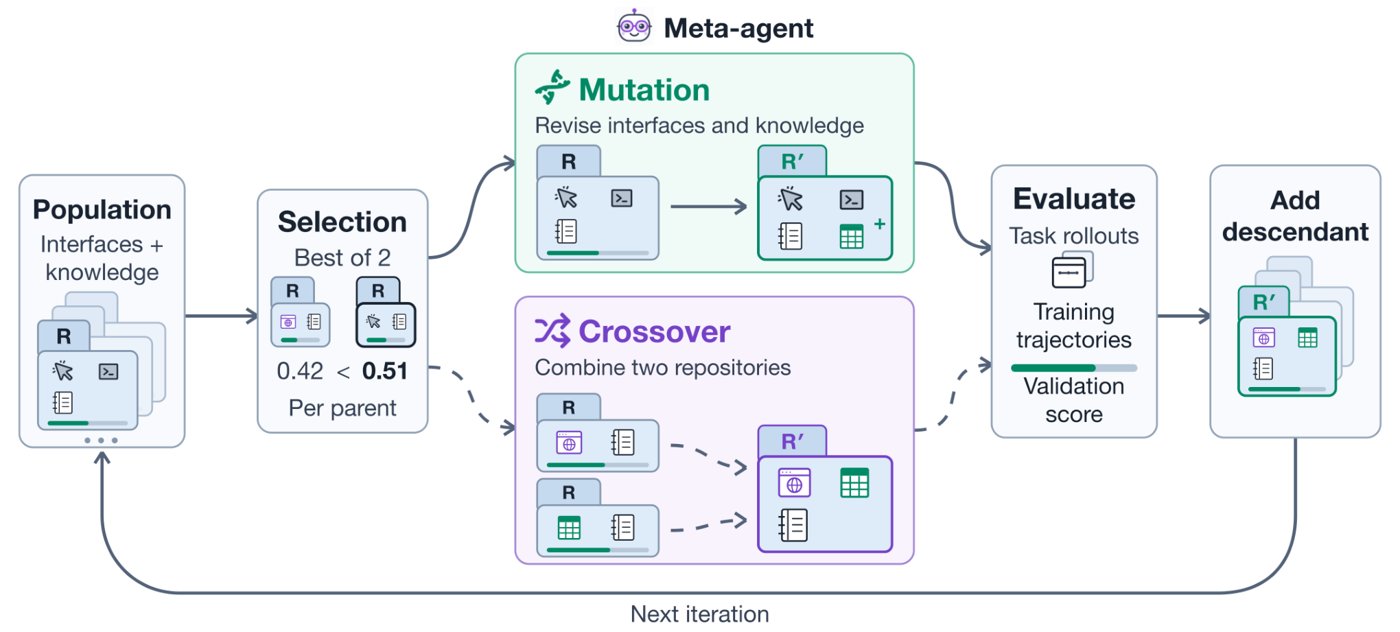
Схема отбора новых версий: метаагент меняет репозитории, а проверочные задачи помогают выбрать, какие развивать дальше.
Что меняется на практике
В процессе работы Agent S4 не просто накапливает отдельные приёмы. Он меняет сами действия и ответы инструментов. Вместо кнопок и снимков экрана агент может получить содержимое страницы, данные из приложения или подтверждение, что операция прошла успешно.
В одном примере агенту нужно было собрать сведения о расходах из почты и банковской системы. Агент с обычным набором инструментов открывал письма по одному, проходил предупреждения при скачивании файлов и прокручивал список операций. Версия с улучшенным интерфейсом получила текст писем и ссылки на вложения через браузер, скачала документы и извлекла из них текст. Затем она использовала тот же подход, чтобы получить банковские операции.
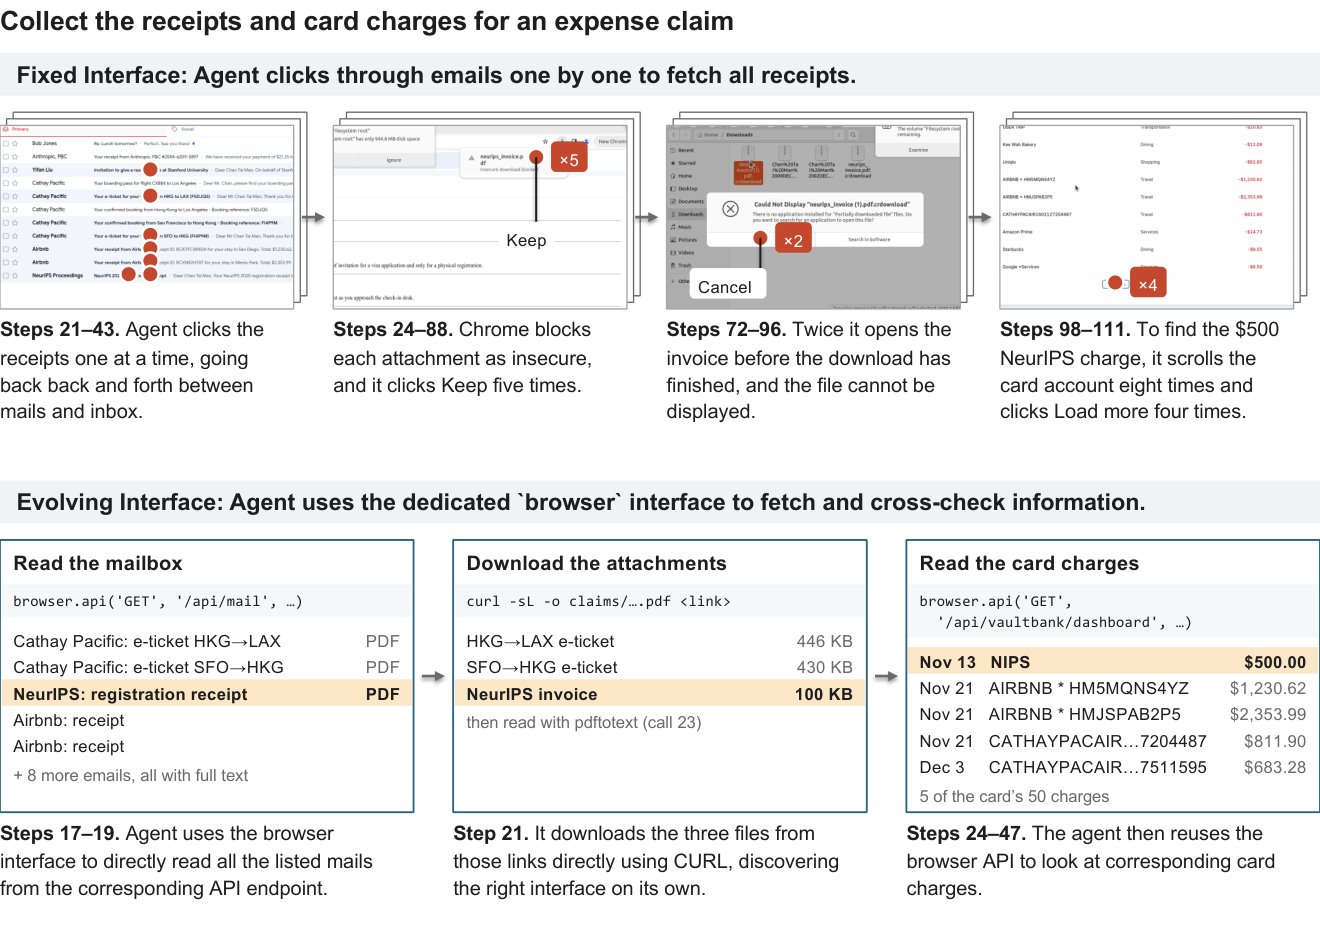
Фиксированный набор инструментов заставляет работать через нажатия и снимки экрана, а новые интерфейсы дают доступ к данным напрямую.
Изменения затронули и специализированные программы. Для научного бенчмарка система добавила инструменты для географической информационной системы, молекулярной программы ChimeraX и математического приложения KAlgebra. Например, агент мог выполнить команду в открытой карте и получить статистику текстом, а не искать консоль и проверять результат на экране.
Репозитории развивались не только последовательными правками. Система сохраняла разные версии и иногда возвращалась к старой ветке или объединяла подходы из двух веток. Это позволяло не терять ранние решения, которые могли оказаться полезными позже.
Результаты на двух бенчмарках
На OSWorld V2, где собраны 108 многошаговых задач с реальными компьютерными приложениями, одна и та же модель Qwen3.8-27B показала разные результаты в зависимости от интерфейса. С фиксированным набором она полностью решала 5,56% задач. С репозиторием, созданным Agent S4 без доступа метаагента к пробной виртуальной машине, результат вырос до 21,3%.
Средние расходы на решение задачи составили 1,10 доллара. Для сравнения, в приведённых авторами результатах GPT-5.5 полностью решает 13% задач при расходах 25,50 доллара, а Claude Opus 4.8 — 20,6% при расходах 72,40 доллара. Эти сравнения относятся к конкретным настройкам и запускам бенчмарка: они показывают разницу в данном эксперименте, а не универсальный рейтинг моделей.
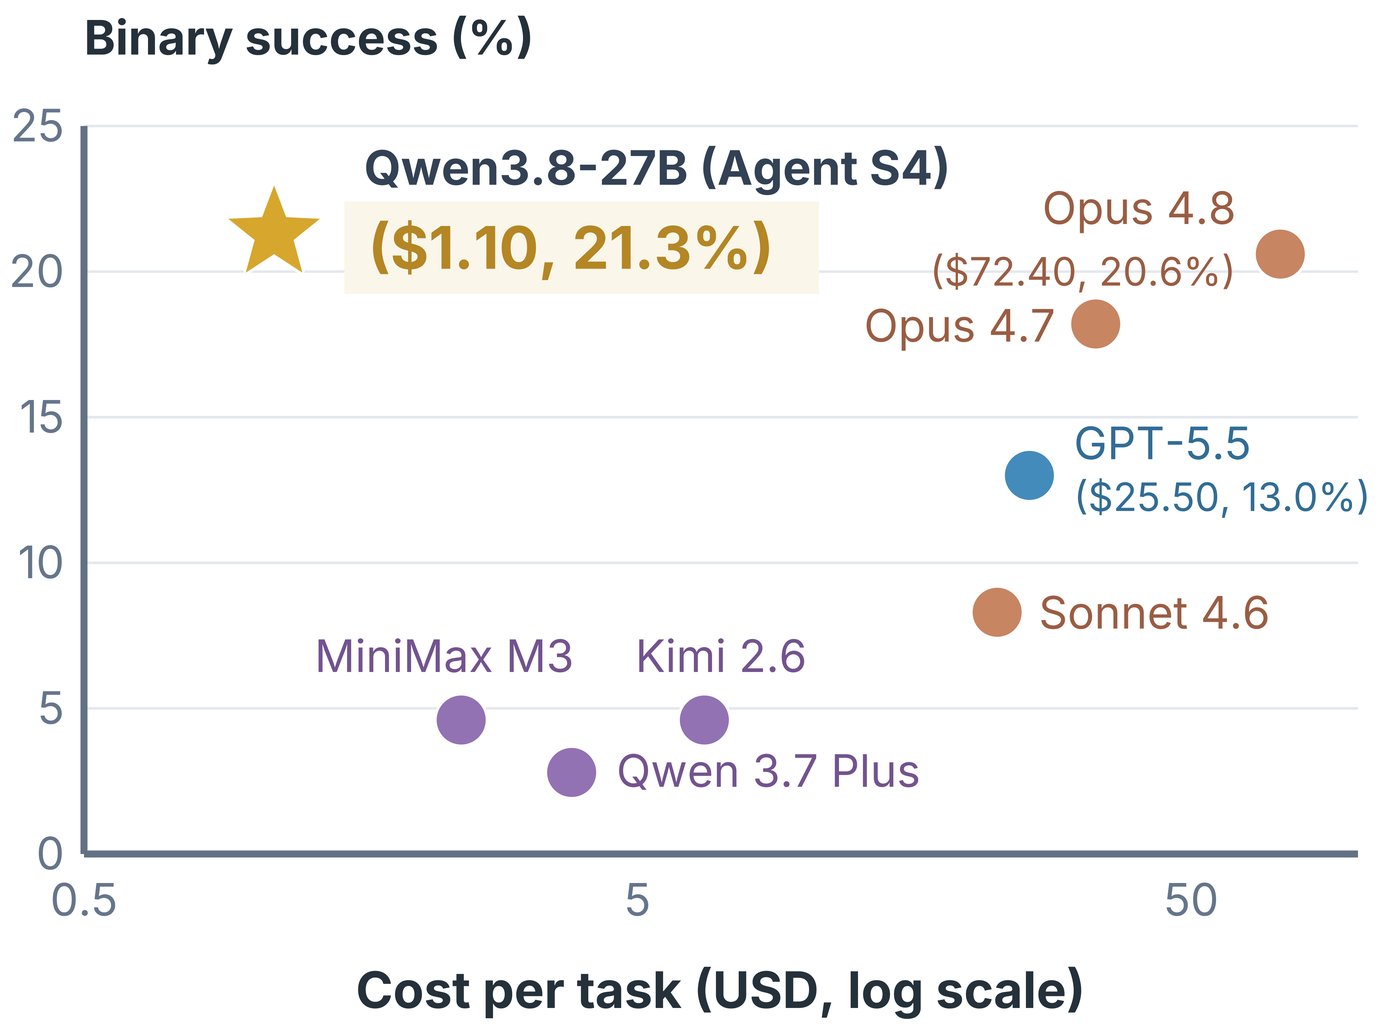
Доля полностью решённых задач и стоимость одного задания на OSWorld V2.
На ScienceBoard систему проверяли на 169 задачах в шести научных приложениях. С исходным репозиторием тот же агент справился с 55,03% задач, а с улучшенным — с 58,58%. Это умеренный прирост. Он показывает, что система может находить полезные интерфейсы и для программ, которые не входят в обычный набор офисных приложений.
Авторы также сравнивали разные способы развития репозитория. Доступ к пробной виртуальной машине помогал метаагенту открывать приложения и проверять новый код. В одном запуске это повысило долю частично решённых задач на OSWorld V2, но лучшая доля полностью решённых задач получилась в запуске без такой машины. Иными словами, возможность проверить интерфейс сама по себе не гарантирует, что он лучше справится с новыми задачами.
Где заканчиваются доказательства
Результаты измеряют эффект сразу от нескольких изменений в репозитории. Исследователи не всегда могут отделить вклад конкретного инструмента от других правок. Примеры, где новый интерфейс сокращает десятки действий до нескольких вызовов, помогают понять возможную причину улучшения, но это отдельные случаи, а не строгие сравнения на всех задачах.
Важно и то, как устроена оценка. Проверочные задания влияют на выбор репозитория, хотя метаагент не видит их напрямую. Поэтому разделение данных снижает риск подгонки, но не отменяет его полностью. Кроме того, оценка стоимости учитывает вызовы модели при решении задач, но не расходы на создание и проверку репозиториев.
Интерфейсы могут давать агенту широкий доступ к данным и приложениям. Это повышает скорость работы, но требует контроля прав и последствий действий. В описанных экспериментах за разрешения, выполнение кода и ограничения отвечала обвязка. Этот уровень контроля остаётся важным: агенту, который может обращаться к почте или изменять документы программно, нужны чёткие границы доступа.
Вывод
Agent S4 показывает, что прогресс компьютерных агентов зависит не только от самой модели. Иногда агенту полезнее дать способ получать нужные данные напрямую, чем заставлять его точнее нажимать мышью.
Система учится создавать такие способы доступа по записям работы, сохраняет их в репозитории и проверяет новые варианты на отдельных задачах. На двух бенчмарках это улучшило результаты, особенно на OSWorld V2. Следующий вопрос — насколько надёжно такой подход переносится на другие приложения и насколько безопасно агенты могут расширять собственные инструменты.
Читайте также
 Как ИИ предсказывает мозговую активность
 ИИ-агенту не нужны готовые ответы, чтобы становиться лучше
 Как ИИ-агент меняется без переобучения модели
 Как четыре ИИ-агента победили дракона в Minecraft
 Реальные клиенты ставят ИИ-агентов в тупик
 Рассуждения без слов улучшили ответы ИИ-агента на 10% и снизили расходы почти в 4 раза
 Опыт человека помогает ИИ-агенту справляться с незнакомыми программами
 182 приложения помогли ИИ-агентам решать незнакомые задачи
 Как виртуальные миры помогают агентам учиться быстрее
 Как помочь ИИ-агенту не теряться в большом проекте
 Как виртуальная компания учит агентов учитывать реакцию рынка
 Как ИИ-агент учится решать задачи на чужом опыте
ИИ-обзоры простыми словами
Каждый день читаем свежие статьи об ИИ и пересказываем главное естественным языком — без хайпа и воды. Если хотите понимать, куда движутся ИИ-агенты раньше остальных, — подписывайтесь.
Новые обзоры — каждый день
В Telegram