ИИ-агенту мало дать рабочие файлы
Представьте задачу для ИИ-агента: сравнить предложения поставщиков и подготовить таблицу с расчётами. Файлы на месте, цены указаны, но в одном предложении не сказано, включена ли доставка. Агенту остаётся угадать или вовсе не выполнять расчёт.
Для человека это поправимая мелочь. Для обучения ИИ-агентов — проблема: если учительская модель получает неполные или противоречивые данные, её ответы становятся плохим примером для учеников.
Авторы статьи WorkFactory предлагают строить рабочие задания так, чтобы в них были все нужные исходные данные, но не готовые ответы. Затем задание проверяет отдельная модель: она ищет, что мешает выполнить работу, и помогает исправить материалы. На таких заданиях исследователи обучили семейство моделей WorkPilot. На бенчмарке GDPval-AA результат одной из них вырос с 879 до 1565 баллов Эло.
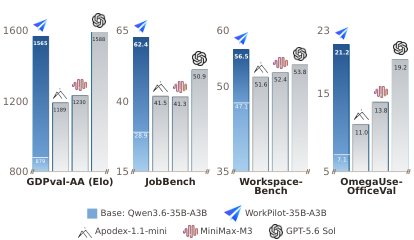
WorkPilot-35B-A3B превосходит исходную модель на четырёх бенчмарках профессиональных задач.
Как подготовить задание для работы
Обычное учебное задание часто сводится к инструкции и правильному ответу. Профессиональная работа устроена сложнее. Чтобы подготовить таблицу, отчёт или рекомендацию, агенту могут понадобиться данные из нескольких файлов, правила расчёта и сведения о задаче. При этом промежуточные расчёты должен выполнить сам агент.
WorkFactory начинает с рабочего результата и движется назад: выясняет, на какие вычисления и решения он опирается, а затем — какие исходные данные для этого нужны. Эти связи система записывает в граф информационной поддержки. Он показывает, что следует положить в запрос и справочные файлы, где разместить нужные сведения и какие результаты оставить агенту.
В примере из статьи задача — выбрать поставщика упаковочных коробок. Агенту дают прогноз спроса, цены, условия доставки и правила дисконтирования. Он должен сам рассчитать расходы и чистую приведённую стоимость предложений, а затем подготовить рекомендацию. Если в исходных материалах не указана стоимость доставки одного из поставщиков, система проверки может обнаружить пробел. После этого условие добавят в файл, но расчёты всё равно останутся работой агента.
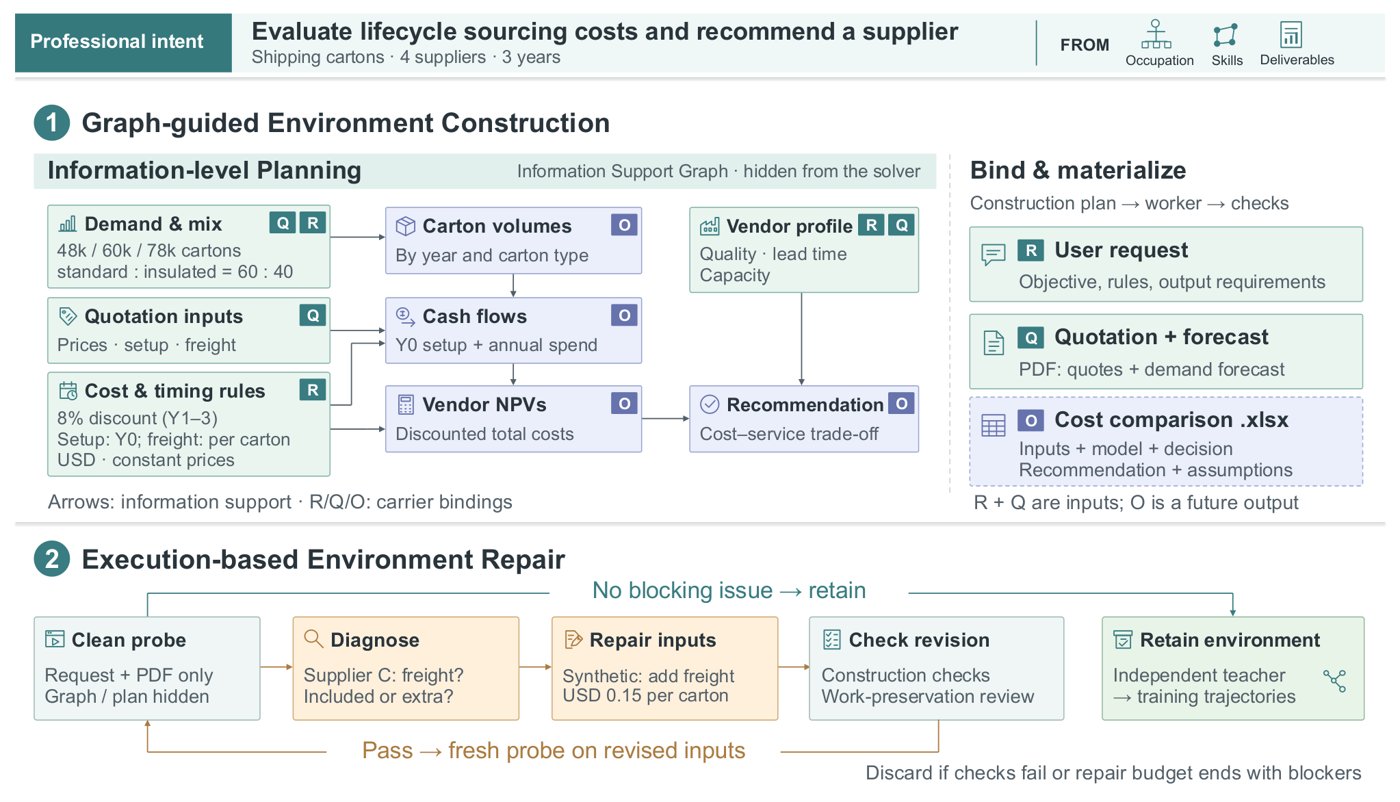
WorkFactory планирует, какие данные нужны для задания, проверяет собранные материалы и исправляет найденные препятствия до сбора примеров работы.
Ключевой принцип — дать агенту основания для ответа, не выдавая сам ответ. Если сразу вложить в материалы готовое сравнение поставщиков, задание станет проще, но перестанет проверять нужный навык. Если же не указать важное условие, результат будет зависеть от догадок.
Задания собирают из трёх источников: описаний профессий, сведений о рабочих навыках и настоящих профессиональных документов. Так система получает разные виды задач: от анализа данных до подготовки файлов для конкретной аудитории. Кандидатные задания дополнительно проверяет языковая модель — на связность, выполнимость и правдоподобие для рабочего контекста.
Затем материалы проходят проверку в несколько шагов:
🟠 Отдельная модель пробует выполнить задание, используя только те файлы и сведения, которые увидит будущий агент.
🟠 Она ищет препятствия, например недостающие данные или противоречия между файлами, и отделяет их от собственных ошибок при решении.
🟠 Если задание невозможно выполнить, материалы исправляют и проверяют заново. Задания, которые так и не удаётся привести в рабочее состояние, отбрасывают.
К выполнению задания учительскую модель допускают только после такой проверки. Это снижает риск, что в обучающие примеры попадут ответы, основанные на выдуманных условиях или неполных данных.
Что получилось при масштабировании
Исследователи собрали 112 686 заданий для 612 профессий. В среднем в одном задании было 4,15 справочного файла. Учительская модель тратила на выполнение в среднем около 57 ходов и создавала примерно 63 вызова инструментов. Результаты её работы использовали для дообучения трёх моделей на базе Qwen: размером 4, 27 и 35 миллиардов параметров.
Все три модели WorkPilot улучшили результаты по сравнению со своими исходными версиями на четырёх бенчмарках профессиональной работы. Например, WorkPilot-35B-A3B выросла с 879 до 1565 баллов Эло на GDPval-AA, а WorkPilot-27B набрала 1612 баллов в локальной оценке. Это поставило её в диапазон результатов передовых моделей, сравниваемых в исследовании.
Рост заметен и на других проверках. WorkPilot-35B-A3B подняла результат на бенчмарке JobBench с 28,91 до 62,35, а на OmegaUse-OfficeVal — с 7,14 до 21,18. Это говорит о том, что обучение повлияло не только на одну конкретную оценку.
Исследователи также проверили, что происходит, если увеличивать число обучающих заданий. Для модели размером 35 миллиардов параметров первые 5 тысяч заданий добавили 447 баллов Эло. А расширение набора с 75 тысяч до 110 тысяч принесло ещё 13 баллов. Дополнительные данные помогают, но со временем отдача снижается. Причём скорость этого снижения зависит от размера модели.
Поведение агента тоже менялось. После первых этапов обучения он выполнял более длинные задания и чаще использовал инструменты. При дальнейшем росте набора траектории в среднем становились короче, а качество продолжало расти. Доля выполнений, которые упирались в установленный предел в 250 ходов, снизилась с 21,9% после обучения на 2 тысячах заданий до 2,7% после обучения на 110 тысячах. Сбои при выполнении кода стали реже. При этом ошибки веб-поиска уменьшились, а ошибки загрузки веб-страниц оставались частыми.
Что именно улучшили планирование и проверка
Авторы отдельно сравнили три способа подготовки заданий: обычное планирование файлов, планирование через граф информационной поддержки и тот же граф с дополнительной проверкой и исправлением. В каждом варианте использовали набор из 5 тысяч заданий.
Граф помог уменьшить долю заданий с недостающими данными, неполными условиями и неработающими расчётами. Например, ошибки в цепочках вычислений встречались в 24,86% заданий при обычном планировании файлов и в 6,86% при использовании графа. Однако одних схем зависимостей оказалось недостаточно: некоторые ошибки, включая противоречия и утечку готового решения, встречались чаще.
Проверка выполнением дополнила планирование. После исправлений доля заданий с несогласованными сведениями в разных файлах упала с 25,74% до 4,84%. Проблемы, мешавшие выполнить задание, сократились с 6,64% до 0,48%. Результат модели, обученной на исправленных заданиях, достиг 1326 баллов Эло против 1245 при обычном планировании.
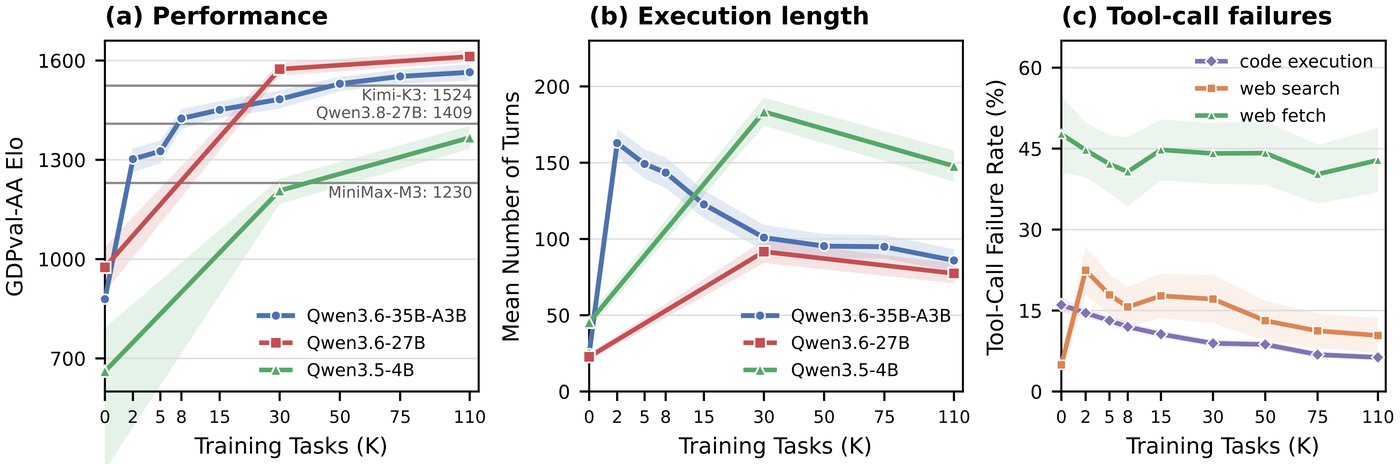
Чем больше заданий использовали для обучения, тем выше был результат на GDPval-AA, хотя прирост постепенно уменьшался.
Проверка выполнения требует дополнительных вычислений. В основном наборе примерно 70% заданий не нуждались в исправлениях, около 20% прошли один цикл, а 2,48% дошли до предельных трёх циклов. Если даже после этого задание оставалось невыполнимым, его удаляли.
Есть и ещё один нюанс: результат зависит от того, какая модель играет роль учителя. Для одного набора из 30 тысяч задач исследователи собрали примеры от двух учительских моделей. Ученик на примерах первой набрал 1483 балла Эло, на примерах второй — 1248. Обе версии превзошли исходную модель, но разница показывает: важны не только качество задания и объём данных, но и то, как учитель выполняет работу.
Вывод
WorkFactory предлагает готовить данные для обучения ИИ-агентов, не ограничиваясь увеличением числа рабочих ситуаций. Сначала система определяет, какие сведения нужны для результата, затем проверяет, можно ли выполнить задание с доступными материалами, и исправляет обнаруженные пробелы.
Результаты показывают, что такой подход помогает улучшить модели на нескольких профессиональных бенчмарках, а проверка заданий повышает пользу обучающих примеров. Но ограничения остаются: учительская модель работала только с текстом, поэтому исследование не проверяет обучение на изображениях и других визуальных данных. Все модели дообучали на примерах выполненных задач; обучение с подкреплением авторы оставляют для будущих исследований.
Для ИИ-агентов, которым поручают работу с файлами, расчётами и инструментами, недостаточно придумать правдоподобную задачу. Нужно убедиться, что она выполнима, а учительский пример показывает именно тот навык, которому модель должна научиться.
Читайте также
 Как ИИ-агенты учатся общим навыкам на разных задачах
 Как понять, что ИИ-агент выполняет задачу неправильно
 Как ИИ-агенту освоить новый навык на практике методом Сократа
 Как ИИ-агент сам улучшает интерфейсы
 Как ИИ предсказывает мозговую активность
 ИИ-агенту не нужны готовые ответы, чтобы становиться лучше
 Как ИИ-агент меняется без переобучения модели
 Как четыре ИИ-агента победили дракона в Minecraft
 Реальные клиенты ставят ИИ-агентов в тупик
 Рассуждения без слов улучшили ответы ИИ-агента на 10% и снизили расходы почти в 4 раза
 Опыт человека помогает ИИ-агенту справляться с незнакомыми программами
 182 приложения помогли ИИ-агентам решать незнакомые задачи
ИИ-обзоры простыми словами
Каждый день читаем свежие статьи об ИИ и пересказываем главное естественным языком — без хайпа и воды. Если хотите понимать, куда движутся ИИ-агенты раньше остальных, — подписывайтесь.
Новые обзоры — каждый день
В Telegram