
Каммарата работает в лаборатории интерпретируемости Goodfire. В эссе он спорит с представлением о том, что внутреннее устройство больших моделей трудно распутать.
Механистическая интерпретируемость изучает не только ответы модели, но и то, как она к ним приходит. В идеале каждый из миллионов искусственных нейронов отвечал бы за понятное понятие. На практике многие нейроны, как казалось исследователям, реагировали на совершенно разные вещи. Это явление называют полисемантичностью. Один из ранних известных примеров — нейрон модели изображений InceptionV1, который срабатывал и на кошачьи морды, и на передние части машин. Каммарата приводил его в своих ранних работах.
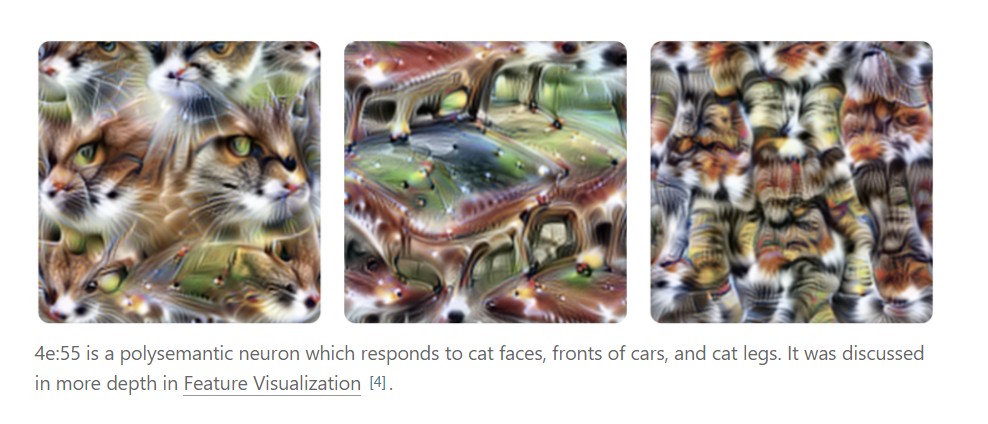
Три синтетические визуализации одного и того же нейрона InceptionV1 показывают кошачьи морды, передние части автомобилей и кошачьи лапы. «Zoom In» рассматривал эту смесь как пример полисемантичности. Теперь Каммарата считает, что этот нейрон обнаруживает V-образные формы
Источник: the-decoder.com
Распространённое объяснение этого явления — суперпозиция. Согласно этой теории, когда нейронов не хватает, сеть помещает несвязанные понятия в одни и те же нейроны, поскольку они редко мешают друг другу. В результате внутренняя структура выглядит запутанной. Поэтому многие лаборатории обучают вторую модель — например, разреженный автоэнкодер, — чтобы разделить понятия, а затем изучают её вместо исходной сети.
Каммарата сыграл заметную роль в формировании этой идеи. Вместе с Крисом Ола он написал работу «Zoom In», где впервые описывалась схема суперпозиции. В 2023 году Каммарата запустил в OpenAI проект по автоматизированной интерпретируемости. Тогда даже по самой щедрой оценке понятными считались лишь около 1,7% нейронов.
Примеры могли истолковать неверно
Теперь Каммарата полагает, что самые известные примеры поняли неправильно. По его версии, нейрон, реагирующий на кошек и машины, на самом деле распознаёт V-образную форму. Его активируют заострённые формы — например, морды лис или пламя, — а округлые, вроде буквы O, снижают его активность. Значит, нейрон не представляет два совершенно разных понятия и не служит примером суперпозиции.
Каммарата также иначе объясняет схему суперпозиции из «Zoom In», в которой машина будто бы скрывалась среди нейронов, реагирующих на собак. Он считает, что это обычное обобщение: схема просто объединяет изображения машин и собак в зависимости от того, какой стороной они обращены к камере. Путаницу в поздних слоях InceptionV1 он связывает с устаревшей архитектурой и слабыми инструментами анализа.
Оставшуюся неоднозначность Каммарата объясняет закономерностью, которую называет «рекурсивным обобщением». По его словам, нейрон растёт как ветка, у которой появляются боковые отростки. Один нейрон распознавал последовательность букв «iy», затем стал реагировать на «diy», а со временем — на выражение «do it yourself», в котором «iy» уже нет. В отличие от суперпозиции, такие группы помогают понять, как устроена сеть.
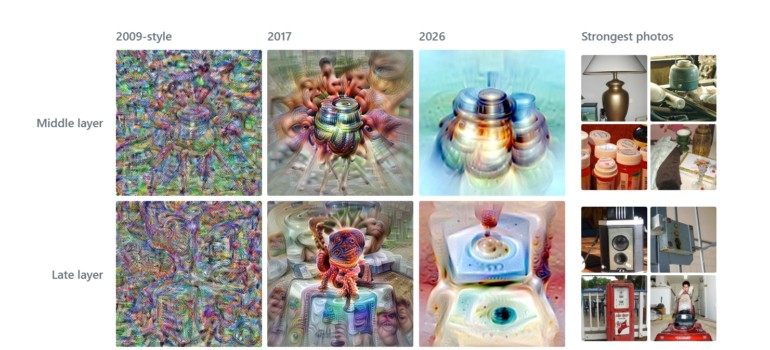
Два тех же нейрона, визуализированные двумя разными способами. Благодаря более совершенным методам анализа гораздо легче увидеть их паттерны реакции и связанные с ними фотографии. Каммарата говорит, что это повод пересмотреть прежние выводы о том, насколько трудно понять нейронные сети
Источник: the-decoder.com
Для языковых моделей Каммарата приводит предварительные оценки. В Qwen3-32B одна основная функция есть примерно у 90% полюсов нейронов, а около 7% имеют две связанные функции. Необъяснёнными остаются лишь 2–4%. Goodfire сообщает о похожих результатах для моделей с числом параметров вплоть до триллионов. Основную часть работы выполнили ИИ-агенты, которые массово анализируют нейроны. Каммарата опирается на «Горький урок» Рича Саттона и заключает, что и в интерпретируемости простое исследование в большом масштабе эффективнее хитроумных методов разложения.
В основе работы нет принципиально нового метода. Каммарата возвращается к первоначальному подходу области — прямому изучению нейронов, но применяет более совершенные инструменты, крупные модели и автоматизированных агентов.
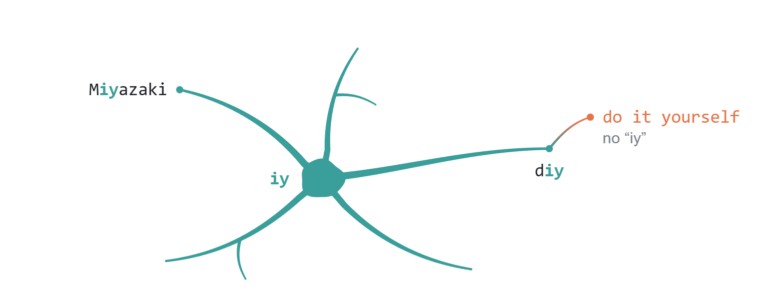
Диаграмма «рекурсивного обобщения». Нейрон, отвечающий за «iy», расширяет свои реакции через «diy» вплоть до «сделай сам», связывая их родственными значениями
Источник: the-decoder.com
Понятные сети помогут безопасности ИИ
Если Каммарата прав, это станет хорошей новостью, особенно для безопасности ИИ. Сейчас, помимо наблюдения за цепочками рассуждений, которые становятся всё менее надёжными, способов понять, обманывает ли модель людей или ведёт себя опасно, немного. Каммарата сомневается, что выравнивание ИИ — настройка систем на человеческие цели — возможно без интерпретируемости: иначе непонятно, что именно создают разработчики.
Каммарата пишет, что обману незачем скрываться от внутренних схем самой модели. Если люди станут ещё одним «читателем» нейросети, они тоже смогут заметить обман, а ошибки — исправлять целенаправленно.
Рун, сотрудник OpenAI, который публикуется в X под этим псевдонимом и заметен в сообществе ИИ, отреагировал на работу с воодушевлением. Он сообщил, что близко дружит с Каммаратой и без него, вероятно, не оказался бы в OpenAI. По словам Руна, работу могут запомнить как важный момент в истории науки. Он добавил, что новость настолько хорошая, что даже Элиезер Юдковский — один из самых известных авторов предупреждений о катастрофе из-за ИИ — должен будет снизить свою оценку вероятности гибели человечества. Рун считает, что выравнивание ИИ может стать обычной научной дисциплиной.
При этом у Руна есть оговорки. Результаты ещё должны подтвердить другие исследователи. Он также предполагает, что прорывы в интерпретируемости ускорят развитие возможностей ИИ. То, что такие результаты появляются за пределами крупных лабораторий, включая OpenAI, по его мнению, не сулит им ничего хорошего.
Нанда видит полезный инструмент, но не прорыв
Нил Нанда оценивает работу сдержаннее. Его считают одним из основателей механистической интерпретируемости; он руководит командой интерпретируемости в Google DeepMind. Ранее Нанда работал в Anthropic и как независимый исследователь. По его словам, взгляды изменились: с середины 2024 года он стал пессимистичнее относиться к масштабным планам в этой области и переключился на практические подходы. Его команда снизила приоритет исследований разреженных автоэнкодеров. Они не считали этот метод бесполезным, но усилия, которые на него тратила область, казались неоправданными.
Работа Каммараты интересна, но не меняет общей картины, пишет Нанда. Анализ нейронов может помочь ответить на прикладные вопросы — например, почему модель сделала что-то сомнительное, — и его гораздо проще применять к передовым моделям. Однако Нанда не верит, что интерпретируемость близка к полному решению. По его ожиданиям, у анализа нейронов будут серьёзные недостатки и он тоже многое упустит.
Нанда по-прежнему считает суперпозицию реальным явлением. Языковые модели хранят гораздо больше фактов, чем у них есть нейронов, а значительная часть этой информации, вероятно, содержится в слабых активациях. Он сомневается, что результаты, полученные на небольших моделях для изображений, можно перенести на другие модели. Кроме того, Нанда считает, что в эссе слишком свободно определена моносемантичность, но признаёт заслугу Каммараты: тот проверил свои ранние работы с помощью современных инструментов.
Часть разногласий связана с определениями. Каммарата не возражает против того, что модели представляют больше понятий, чем у них есть измерений; Нанда считает, что в этом вопросе они согласны. Каммарата оспаривает другое: что сети произвольно помещают в одни и те же нейроны совершенно несвязанные понятия.
Сопутствующая техническая работа пока не опубликована. У Goodfire как у компании, занимающейся интерпретируемостью, есть прямой интерес к этой гипотезе. Если объяснение Каммараты подтвердится, считает он, автоматизированные исследователи смогут за несколько месяцев проделать работу, на которую у людей с моделями изображений ушло почти десять лет. По его словам, времени на это может остаться немного.
Читайте также
 Глава Replit: будущее работы — «самоуправляемая компания»
 Reflection хочет потеснить китайские открытые модели не дешевизной токенов, а их меньшим числом
 Эксперты по ИИ уже готовятся к концу света, если ИИ выведет из строя всю финансовую систему
 tokenizers v1: измерили скорость кодирования, декодирования и масштабирования
 ИИ-девушки воруют шутки у комиков, чтобы набрать просмотры на возбуждающих роликах
 ИИ угрожает демократии. Но мы не бессильны: вот как дать отпор
 Вирусный успех Cal AI обеспечила целая армия инфлюенсеров — и это окупилось
 Google хочет, чтобы роботам хватало одной модели ИИ — Gemini 4 Argon
 GPT-6-Astra решает 49 из 50 задач по физике за $2,40 за каждую
 Жители отвергают выплату по $10 000 за согласие разместить в их посёлке дата-центр
 Bluesky расширила возможности приложения Attie на базе ИИ: теперь в нём каждый может создавать сайты, игры и не только
 Muse Spark Open — ответ Meta на Qwen, GLM и Kimi в гонке открытых моделей с весами
 Bank of America направил 4 тысячи человек устранять уязвимости, найденные Mythos от Anthropic и другими ИИ-моделями
 Anthropic рассказала о независимых оценщиках
 FLUX 3 Image Klein от Black Forest Labs работает на видеокартах для обычных ПК с 8 ГБ видеопамяти
 Google запустила в США инструмент для покупок Universal Cart
 Arcade.dev: новая система подбора инструментов снижает расходы компаний на входные токены на 37%
 Magnetar подтверждает корректность программ для вычислений общего назначения с помощью доказательств
 ИИ-агенты появятся в автомобилях Rivian
 NVIDIA дообучила Nemotron 3.5 Super VL, и она обошла Claude Opus 5 и GPT-6.1 Sol в тестах специализированных задач
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram