
Обучение больших моделей ИИ требует значительных вычислительных ресурсов, повышает затраты и потребление энергии. Это затрудняет разработку передовых моделей для университетских исследователей и небольших лабораторий. MoE могут включать больше обученных компонентов, или параметров, не задействуя их все для каждого входного токена. Но всю модель всё равно нужно хранить в памяти ускорителей и обновлять при обучении. Кроме того, распределение входных данных между нужными экспертами — специализированными компонентами MoE — создаёт дополнительные расходы на передачу данных и координацию. По мере роста модели эти расходы могут съедать значительную часть вычислительной экономии.
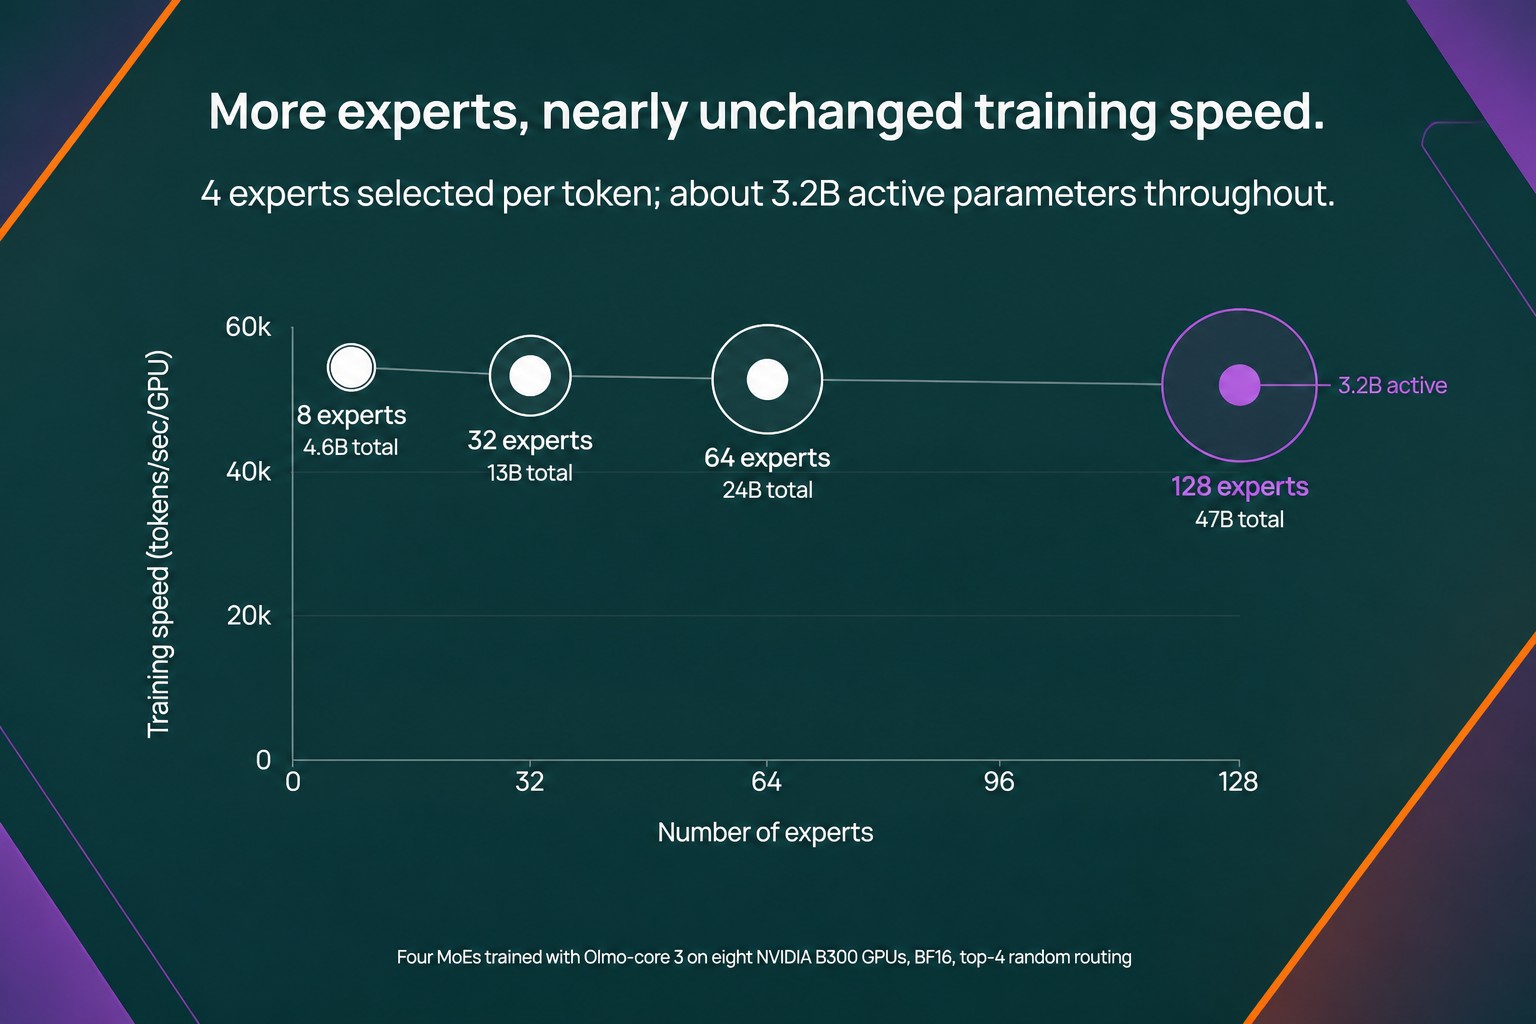
Olmo-core 3 призвана сократить эти накладные расходы. В одном бенчмарке команда увеличила пул экспертов с 8 до 128, при этом для каждого токена по-прежнему выбирались только четыре эксперта. Число активных параметров на токен оставалось примерно одинаковым — около 3,2 млрд. Общая ёмкость модели выросла с 4,6 млрд до 47 млрд параметров, а скорость обучения снизилась менее чем на 5%.
Эту же инфраструктуру проверили на моделях с общим числом параметров свыше триллиона.
Система обучения для MoE
Olmo-core менялась вместе с каждым поколением Olmo.
Работа команды с разреженными моделями началась с OlmoE, где использовалась архитектура MoE с 64 маршрутизируемыми экспертами. В Olmo 3, напротив, применялась плотная архитектура: для каждого токена активировалась почти вся модель, и система обучения была устроена под такой подход. В Olmo-core 3 добавили систему для обучения гораздо более крупных MoE.
В прежней реализации MoE в Olmo-core использовался полностью сегментированный параллелизм данных (FSDP): веса модели собирались для каждой небольшой партии обучающих данных, а затем снова распределялись по ускорителям. Olmo-core 3 переходит на распределённый параллелизм данных (DDP). Эксперты постоянно размещены в памяти ускорителей, а нужные данные направляются к ним — повторно собирать веса не требуется.
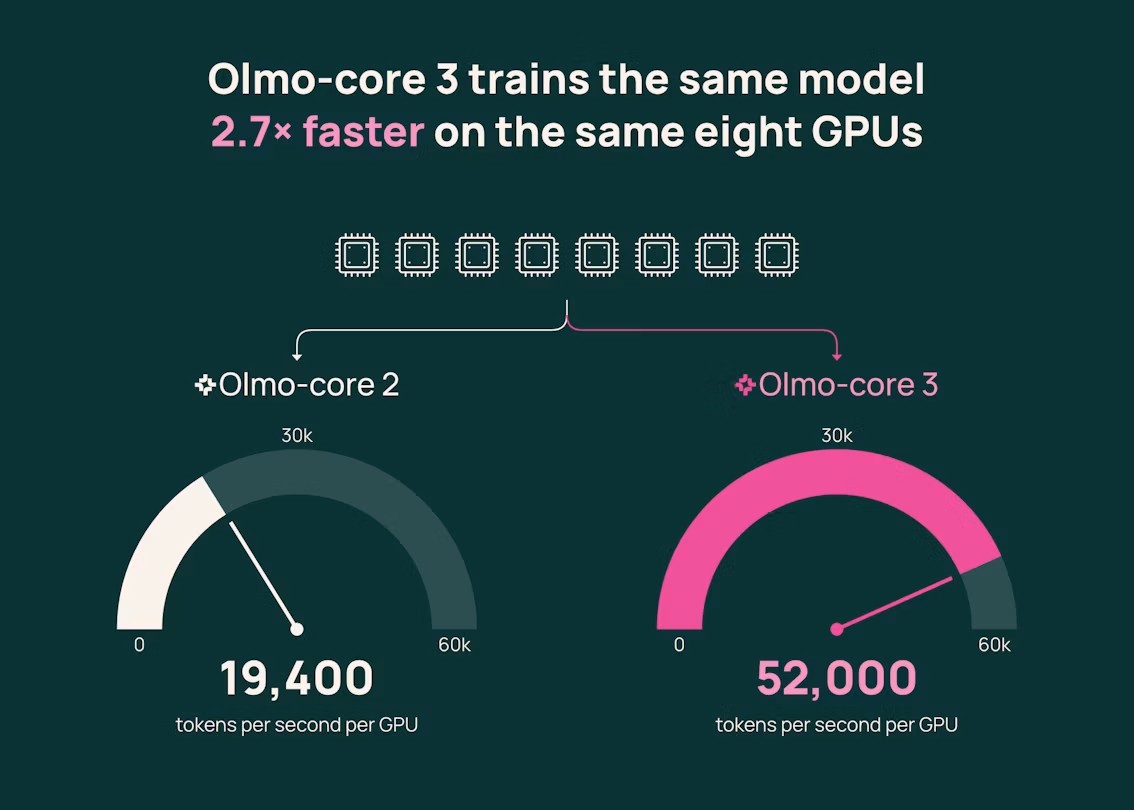
Для обучения больших MoE уже существует NVIDIA Megatron-Core. Olmo-core 3 добавляет интегрированную систему обучения MoE во фреймворк, на котором основан Olmo, и перерабатывает прежнюю реализацию на FSDP, чтобы повысить скорость обработки. В предварительном тесте на восьми ускорителях NVIDIA B300 модель MoE с 47 млрд параметров обрабатывала с новой системой 52 000 токенов в секунду на каждом ускорителе, против 19 400 у прежней реализации. Это примерно в 2,7 раза больше.
Масштабирование и ускорение обучения MoE
Olmo-core 3 объединяет методы распределения крупных MoE по кластерам ускорителей с оптимизациями маршрутизации данных и вычислений.
Три метода определяют, как модель и состояние обучения распределяются между устройствами:
Вместе эти методы позволяют увеличивать MoE, не заставляя каждый ускоритель хранить всю модель и состояние её обучения.
Olmo-core 3 также сокращает расходы на передачу данных нужным экспертам и выполнение их вычислений. При построчном параллелизме экспертов данные сразу помещаются во входные буферы экспертов, что уменьшает объём дополнительной работы по их перестановке. Маршрутизация на ускорителях хранит служебные данные маршрутизации там же, поэтому центральный процессор может ставить задачи в очередь, не дожидаясь копирования этих данных обратно. А групповая операция GEMM объединяет множество небольших вычислений экспертов, чтобы ускорители выполняли их эффективнее.
Кроме того, Olmo-core 3 поддерживает MXFP8 — формат чисел с пониженной точностью, в котором некоторые значения занимают меньше битов. Он может сократить вычислительные затраты и объём данных, передаваемых между ускорителями, если экономия превышает стоимость преобразования чисел из одного формата в другой.
Команда измерила влияние MXFP8 на общую скорость обучения в контролируемом бенчмарке на четырёх NVIDIA B300, равномерно распределяя работу между экспертами. Когда MXFP8 применялся в тех частях системы, где он давал наибольший эффект, скорость обучения была примерно на 21% выше, чем с BF16 — форматом повышенной точности, выбранным для сравнения. Пиковое потребление активной памяти при этом снизилось со 103 ГиБ до 95 ГиБ. Большая часть выигрыша пришлась на прямые вычисления и передачу данных между экспертами, а не только на механизм внимания.
Все эти методы и оптимизации должны работать вместе. Ускорение одного этапа обучения может увеличить затраты на другом: более быстрые вычисления могут потребовать больше передач данных, а уменьшение их объёма не поможет, если преобразование форматов занимает слишком много времени. Olmo-core 3 учитывает эти компромиссы на протяжении всего процесса обучения и даёт команде и исследователям, использующим открытую систему, возможность настраивать взаимодействие её компонентов.
Интерактивный разбор показывает, как параллелизм данных, экспертов и конвейера помогает масштабировать обучение MoE — от одного ускорителя до целого кластера.
Масштаб до триллиона параметров
Команда проверила Olmo-core 3 на разных конфигурациях с NVIDIA B300, включая модель с 1,2 трлн параметров и 58,36 млрд активных параметров на токен, распределённую на 512 ускорителей. Максимальная измеренная производительность составила 858 TFLOP/s на ускоритель — столько полезных вычислений модели выполнялось за секунду на каждом устройстве. В этих тестах использовалась случайная маршрутизация: они измеряли производительность системы, а не качество обученной модели.
Команда также экспериментировала с DeepEP v2 — альтернативным способом передавать данные между экспертами на разных ускорителях. В одном из тестов удалось настроить систему для модели с 2,38 трлн параметров. Это была короткая проверка ёмкости, а не полный цикл обучения, поэтому результат показывает достижимый масштаб, но не скорость продолжительного обучения.
На таких масштабах производительность системы — только часть вопроса. В техническом отчёте описаны эксперименты, которые помогли команде выбрать подходы к обучению MoE и оценке их производительности. Например:
В отчёте также описаны эти результаты, проверенные подходы и варианты, от которых команда решила отказаться.
Основа следующего поколения Olmo
Olmo-core 3 станет основой дальнейшей работы команды. Следующее поколение Olmo будет использовать архитектуру MoE. Команда рассчитывает, что это будет самая способная модель в семействе Olmo: её обучат на крупнейшем наборе данных и с самым длинным контекстным окном.
Новая система позволяет выйти за пределы прежних экспериментов с MoE и гибче адаптировать обучение по мере развития моделей и оборудования. Olmo-core 3 полностью открыта: исследователи и разработчики могут обучать на ней собственные MoE, адаптировать систему под разные ускорители и экспериментировать с маршрутизацией, параллелизмом и другими компонентами.
Команда связывает открытость разработки моделей не только с доступом к весам, но и с открытой инфраструктурой и решениями, на основе которых эти модели обучаются.
Технический отчёт описывает устройство системы, эксперименты, проверки отдельных компонентов и подходы, которые команда тестировала. Olmo-core 3 также доступна на GitHub.
Источник: huggingface.co
Читайте также
 Новая кисть робота Atlas может превзойти человекоподобные конструкции
 Anthropic добивается права обучать модели на контенте из Австралии с возможностью отказа, а ABC предупреждает: ИИ «поглотит» новости
 Стартап в сфере кибербезопасности нашёл более 13 000 скриншотов из внутренних систем компаний, которые ИИ-агенты выложили в открытый доступ
 Высокопоставленный руководитель BBC посмотрел полностью созданный ИИ эпизод «Доктора Кто» и назвал его «неплохим»
 Photon устроила похороны мобильных приложений. Теперь у неё есть $4,5 млн, чтобы заменить их агентами
 ИИ обыграл сильнейшего игрока в Stratego, покончив с одним из последних оплотов людей в настольных играх
 Satlyt, основанная бывшим продакт-менеджером Google и SpaceX, привлекла $8 млн на запуск ИИ на спутниках
 OpenAI пресекла кампанию по краже рассуждений своих моделей, но на Azure уловка сработала
 Аналитики предупреждают: дата-центры могут стать бомбой замедленного действия на $6 трлн
 Как старейший ИИ-стартап пытается защитить себя от пузыря изнутри
 ИИ научился «читать мысли» и восстанавливать увиденное по снимкам мозга
 ИИ-чат-боты снимают хиджабы с изображений мусульманок по просьбе пользователей
 Забудьте о «сверхразуме»: из-за ошибки ИИ в этом месяце мир едва не оказался на пороге третьей мировой войны
 Barclays масштабирует Claude, чтобы модернизировать работу и улучшить обслуживание клиентов
 Знакомьтесь: робот, который заботится о 74-летней Вере у неё дома
 Голосовой ИИ-стартап ElevenLabs удвоил оценку — до $22 млрд
 Как ИИ может резко усилить угрозы выборам в Юго-Восточной Азии
 Новые товарные рекомендации Instinct вызывают у части пользователей отторжение
 Гэвин Ньюсом подписал законы, защищающие работников Калифорнии от угрозы ИИ
 Глава хедж-фонда пожертвовал Carnegie Mellon University $3 млрд — исторический дар
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram