
Кевин Мёрфи, главный специалист NASA по научным данным, отметил, что агентство десятилетиями собирало уникальные сведения о Луне, но учёным ещё нужно упростить работу с ними. NASA и IBM Research представили одну из первых открытых базовых моделей для лунной науки.
В отличие от алгоритмов для одной конкретной задачи, базовую модель сначала обучают на больших объёмах неразмеченных данных, а затем адаптируют к нужной работе с небольшим числом размеченных примеров. Исследователи считают это особенно полезным для изучения Луны: наблюдений много, а разметки мало.
Почти два миллиона наборов данных
Модель обучили с нуля на SomBench — по словам команды, крупнейшем на сегодня мультимодальном лунном наборе данных с совмещёнными координатами. В нём почти два миллиона наборов фрагментов изображений: 11 типов данных и два пространственных масштаба. Около миллиона изображений высокого разрешения сняты узкоугольной камерой NAC — примерно один метр на пиксель. Ещё чуть меньше 964 тысяч мультиспектральных изображений получены широкоугольной камерой с разрешением 100 метров на пиксель.
Основу набора составляют данные за 17 лет наблюдений орбитального аппарата Lunar Reconnaissance Orbiter (LRO). По данным NASA, их объём превышает совокупный объём данных всех остальных планетных миссий агентства. Набор дополнили сведениями миссии GRAIL о гравитационном поле, Lunar Prospector о водороде и японского аппарата JAXA Kaguya/SELENE о минералогии.
Всего в наборе объединено более 30 пространственно совмещённых слоёв данных с девяти приборов и четырёх миссий. Чтобы данные для обучения, проверки и тестирования не пересекались, исследователи разделили их по географическим зонам карты, а не распределяли отдельные фрагменты случайным образом.
Модель получает данные об освещении
В основе модели лежит TerraMind — мультимодальная модель наблюдения Земли. Однако NASA и IBM обучили лунную модель с нуля, а не адаптировали готовую. Для каждого фрагмента она получает сведения о геометрии съёмки: углы освещения, положение Солнца и границы участка. На Луне освещение влияет на вид поверхности сильнее, чем её физические свойства. Вместо того чтобы просить модель разбираться с этим по исходным пикселям, исследователи сразу передают ей нужные параметры.
Модель также обучается одновременно на изображениях высокого и низкого разрешения, чтобы учитывать и мелкие детали, и общий контекст. Метод FlexiViT позволяет одной и той же обученной модели работать с задачами, в которых используются фрагменты изображений разного размера, без повторного обучения.
Самый заметный результат — поиск льда
Исследователи проверили модель на обнаружении кратеров в масштабах 100 и один метр, прогнозировании залежей льда у полюсов и сегментации неровных морских пятен — молодых вулканических образований, которые затрудняют проверку принятых сроков остывания Луны. Согласно техническому отчёту, предварительно обученная модель во всех задачах сравнялась с распространёнными базовыми методами или превзошла их, а также контрольную модель с такой же архитектурой, но случайной инициализацией.
Наиболее заметный прирост получен при прогнозировании залежей льда. В постоянно затенённых полярных областях достаточно холодно, чтобы водяной лёд сохранялся миллиарды лет. Такие залежи рассматривают как потенциальный источник воды, кислорода и ракетного топлива. По данным IBM, модель снизила ошибку прогноза максимум на 22% по сравнению с лучшим базовым методом SwinV2-B.
При обнаружении кратеров на низком разрешении модель превзошла SwinV2-B почти на 19%, сообщает IBM. Для этого её обучали только на половине данных. Это указывает на то, что для хорошего результата модели может хватить меньшего количества размеченных примеров.
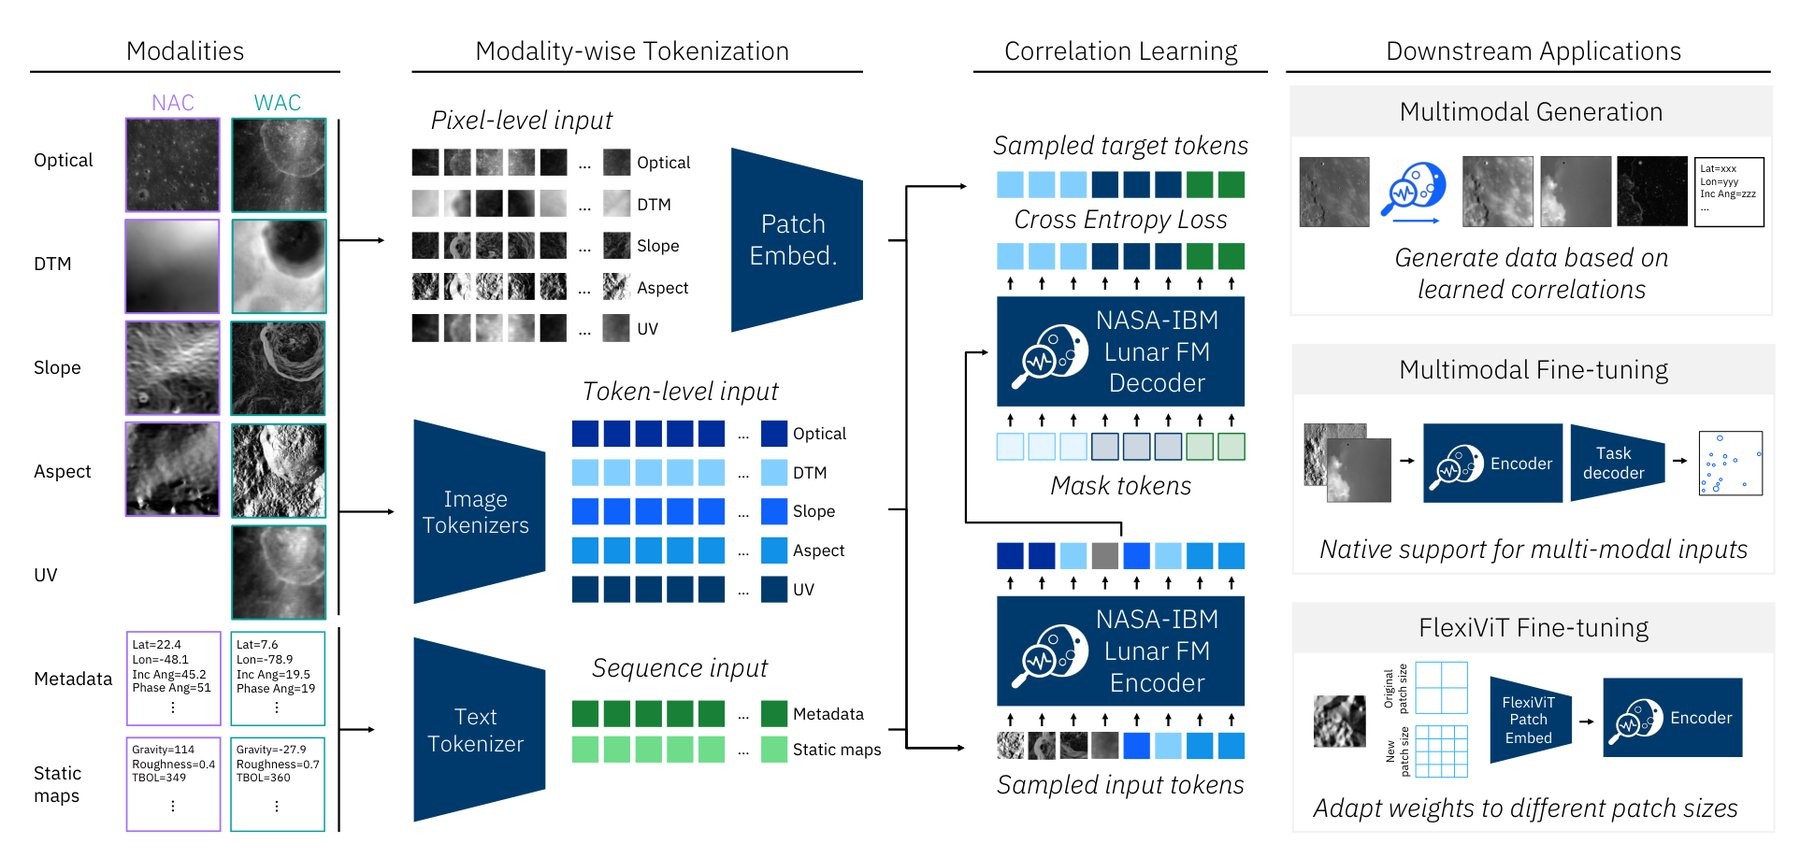
Модель разбивает изображения Луны, данные о высотах и геометрию съёмки на токены и изучает связи между ними, предсказывая замаскированные фрагменты
Источник: the-decoder.com
Часть преимущества — в обработке данных
Контрольная модель со случайной инициализацией, которую не обучали на лунных данных, всё равно превзошла пять из семи базовых методов при поиске льда. По мнению исследователей, часть преимущества связана с тем, как модель обрабатывает разные типы данных: для каждого слоя она использует отдельный путь обработки, тогда как базовые модели объединяют все входные данные в каналы.
При обнаружении кратеров в метровом масштабе и сегментации неровных морских пятен модель примерно сравнялась с наиболее сильными базовыми методами. Разница укладывается в разброс результатов между запусками обучения. IBM заявляет о преимуществе в 3% над SwinV2-B при работе с морскими пятнами, однако результаты выглядят скорее сопоставимыми, чем явно лучшими.
По словам исследователей, более лёгкий метод файн-тюнинга LoRA, при котором обучается лишь часть параметров, в целом не уступил полному файн-тюнингу и показал лучший результат при обнаружении кратеров. Полный файн-тюнинг оказался лучше только на двух самых маленьких задачах.
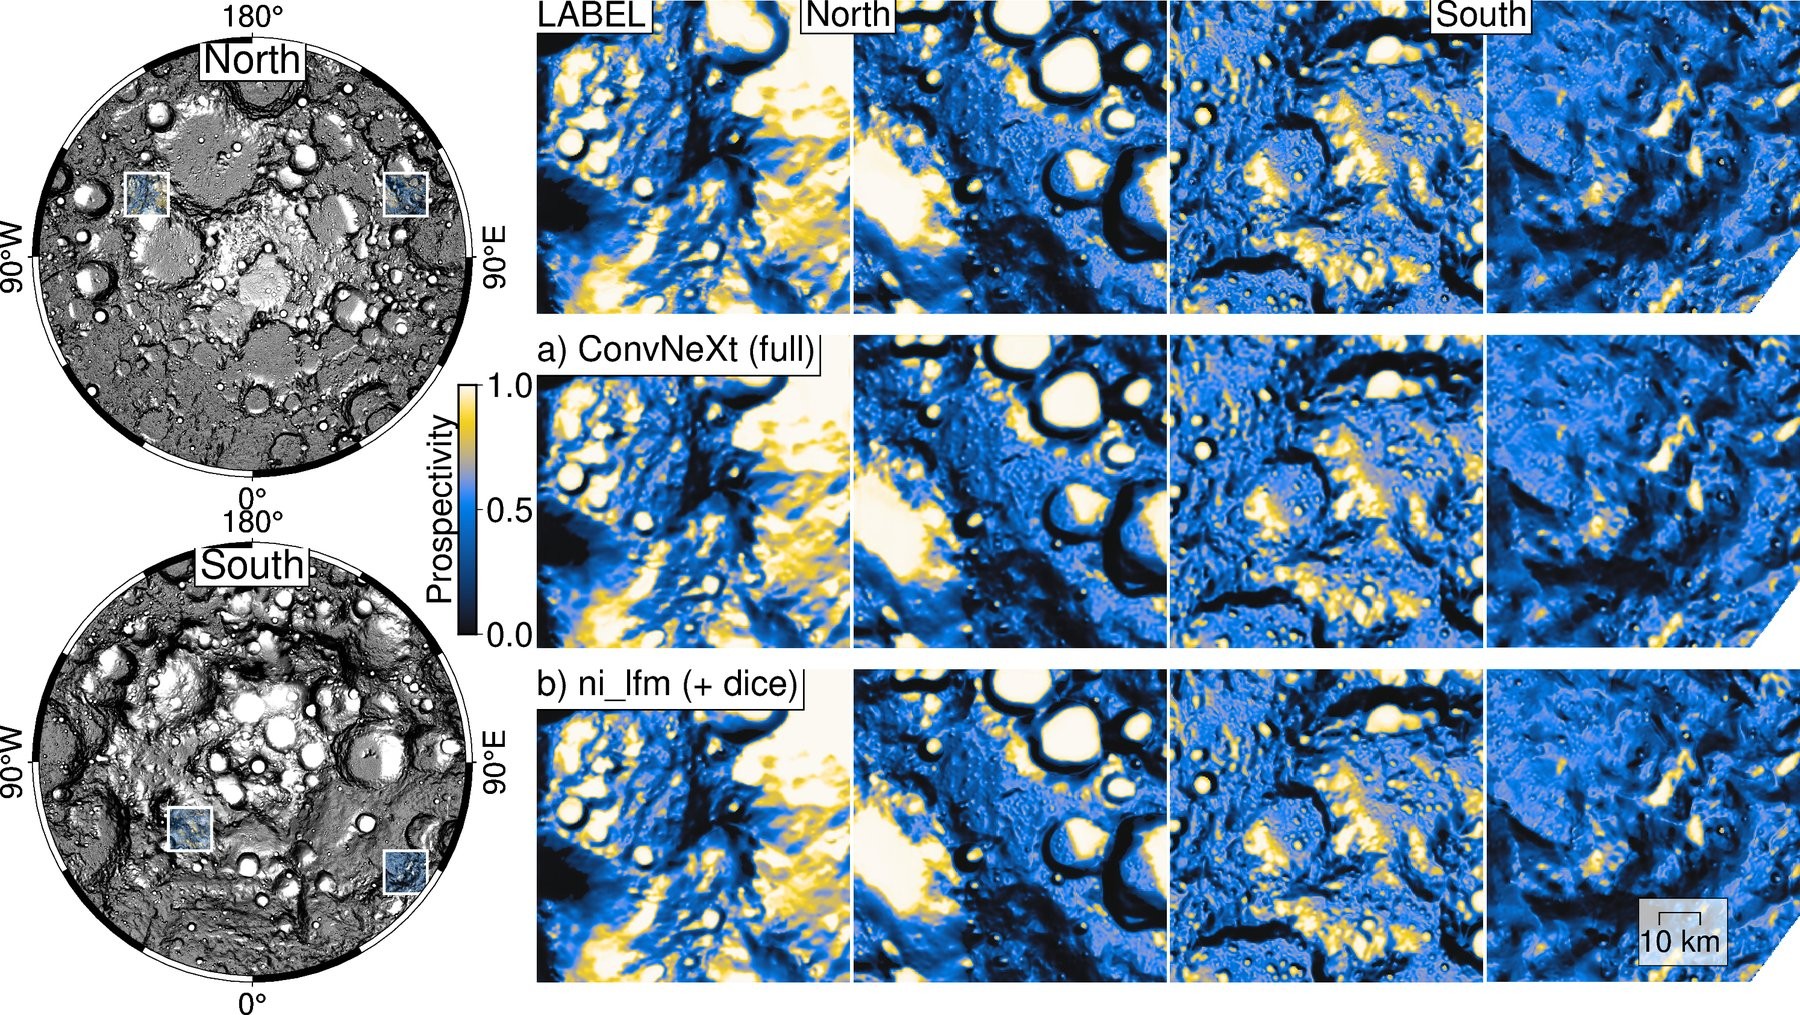
Базовая модель NASA и IBM точно воспроизводит мелкие детали на эталонных картах потенциального распределения льда у полюсов Луны
Источник: the-decoder.com
Модель помогает анализировать данные, но не заменяет измерения
Хуан Бернабе-Морено, директор IBM Research Europe, рассказал, что модель связывает наблюдения разных приборов и находит закономерности, которые трудно заметить, рассматривая данные по отдельности.
Однако для точного геодезического позиционирования модель не подходит. В тестах на генерацию широта и долгота в некоторых случаях расходились на десятки градусов. Кроме того, модель могла правильно восстановить форму рельефа, но сместить его абсолютную высоту.
Авторы рассматривают модель как основу для повторного использования в последующих задачах, а не как замену приборам для физических измерений. Контролируемые эксперименты, которые позволили бы отдельно оценить вклад каждого нововведения, ещё предстоит провести. Некоторые тестовые наборы данных также невелики.
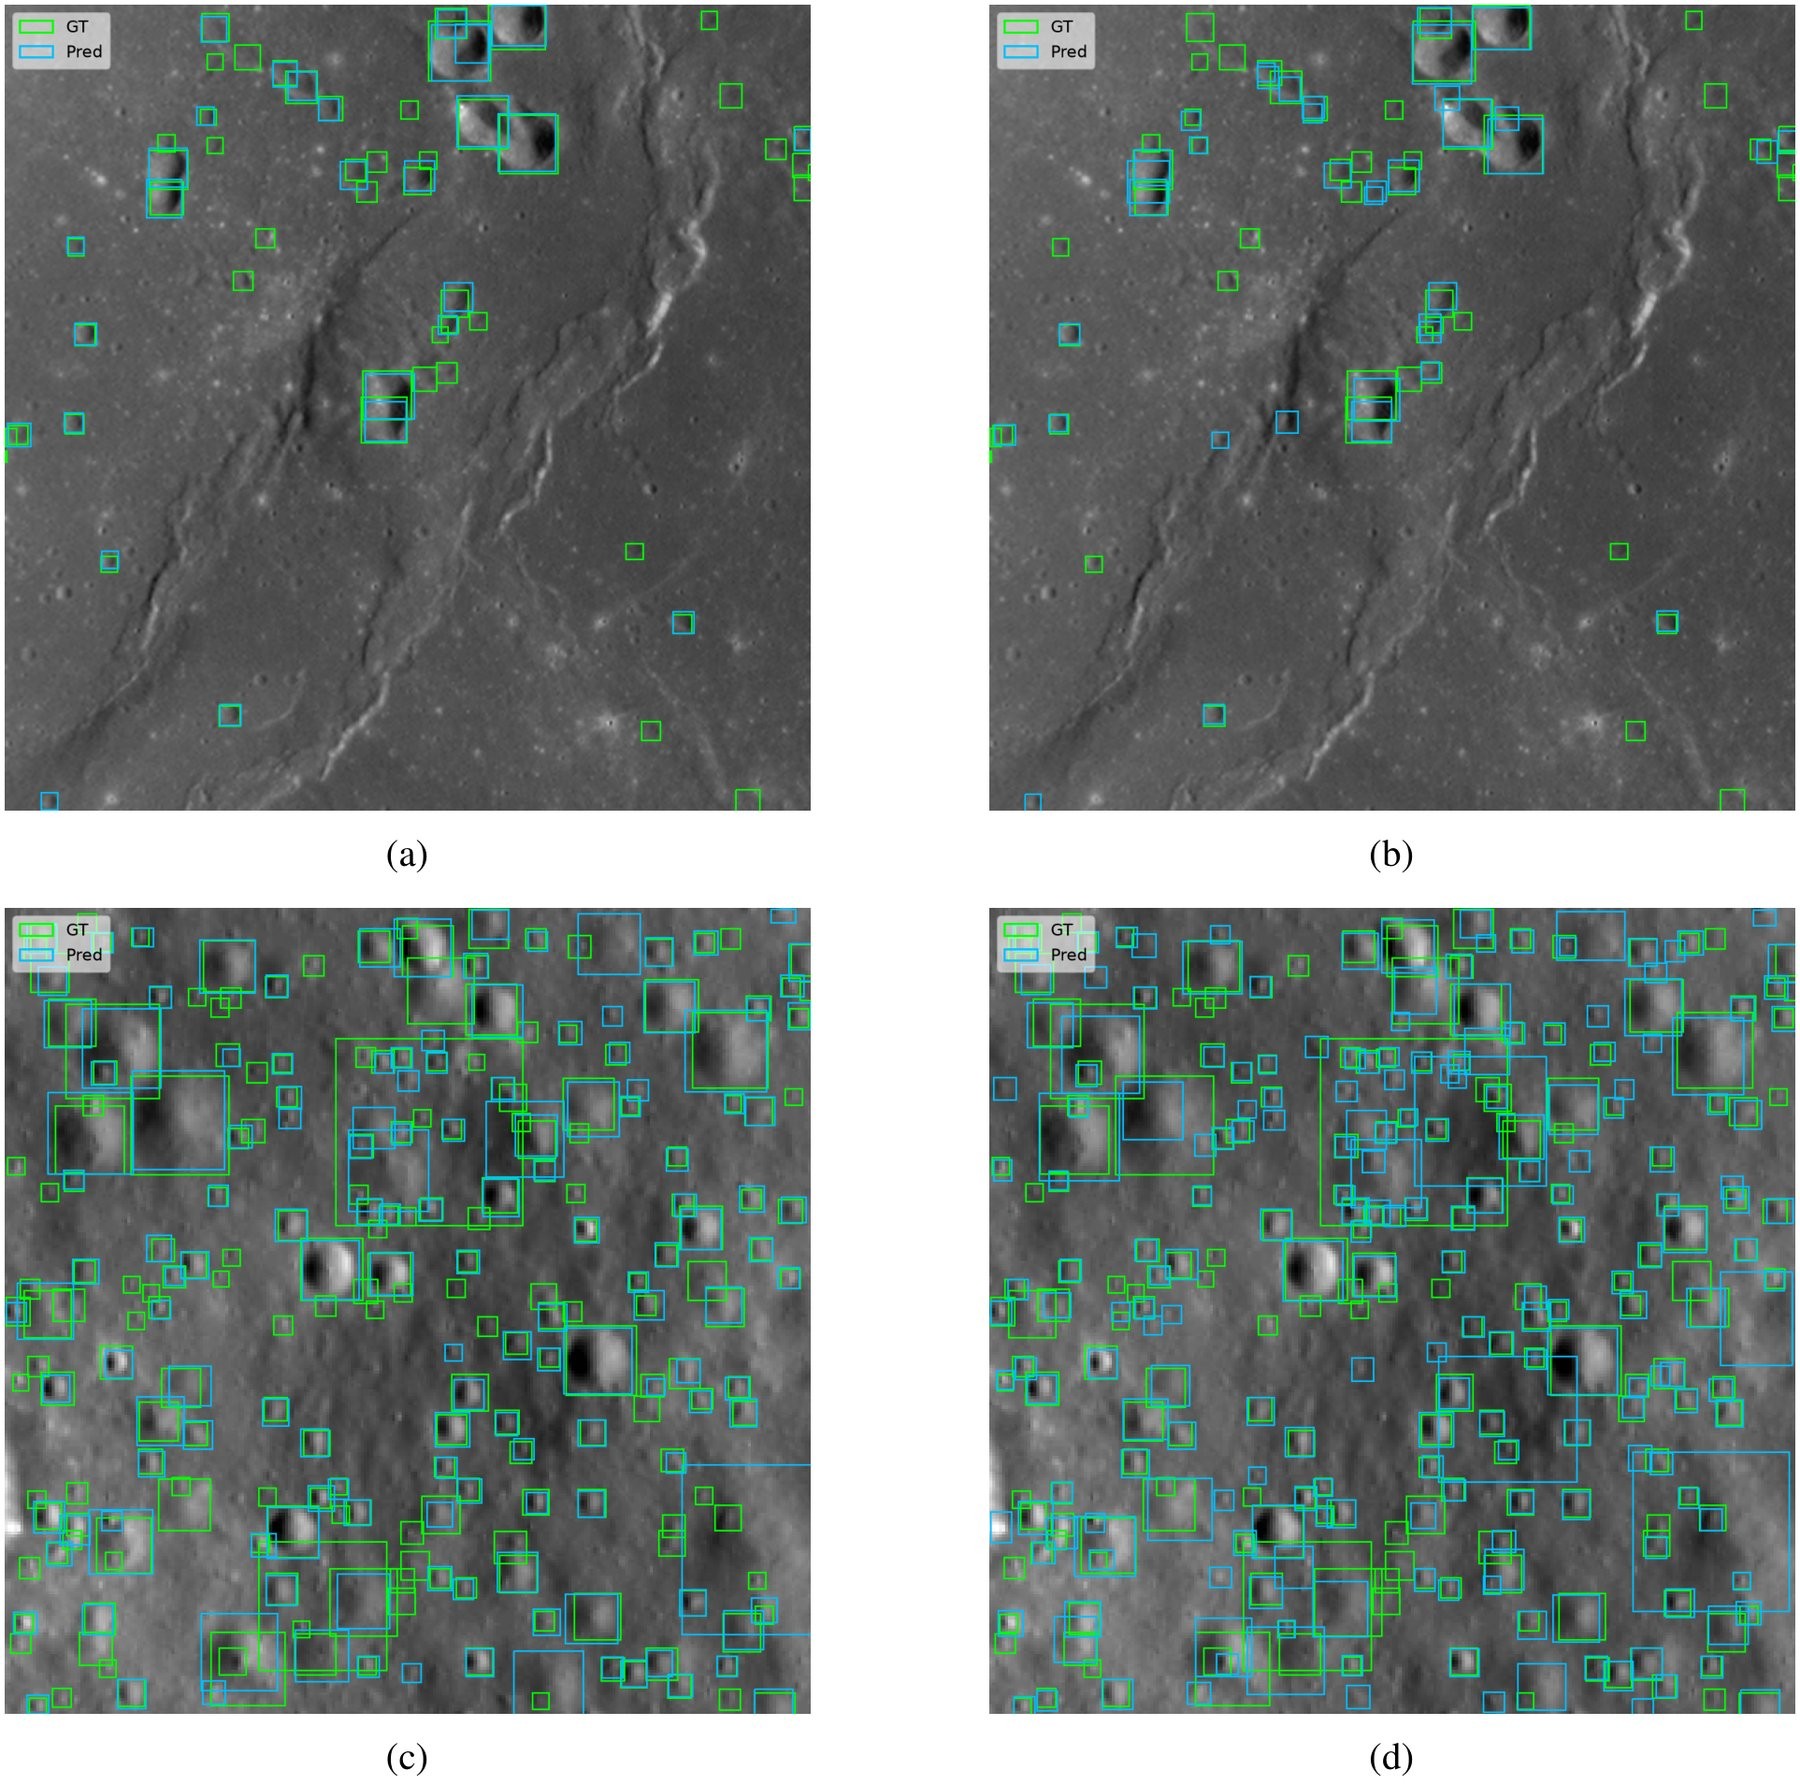
В этих примерах обнаружения кратеров модель NASA и IBM и SwinV2-B, предварительно обученная на ImageNet, показывают сходные результаты. Все модели хуже справляются с изображениями высокого разрешения, полученными камерой NAC
Источник: the-decoder.com
Новая модель в семействе проектов
Модель доступна на Hugging Face, исходный код опубликован на GitHub. Она также включена в открытый набор инструментов TerraTorch. Команда выпустила подготовленные для машинного обучения наборы данных для предварительного обучения и коллекции бенчмарков.
Модель создана в рамках сотрудничества NASA и IBM «ИИ для науки». С начала 2022 года организации работают над базовыми моделями по соглашению Space Act Agreement. В августе 2023 года они выпустили на Hugging Face первую модель Prithvi, обученную на снимках Landsat и Sentinel-2 всей континентальной части США и адаптированную для картирования наводнений и лесных пожаров.
IBM ранее представила Prithvi в составе платформы Watsonx. TerraMind, на которой основана лунная модель, IBM разработала в 2025 году вместе с ESA и Forschungszentrum Jülich для наблюдения за Землёй.
Google DeepMind развивает похожий подход с AlphaEarth Foundations: система объединяет оптические спутниковые снимки, радиолокационные и лидарные сканы, а также климатические симуляции в компактные эмбеддинги земной поверхности.
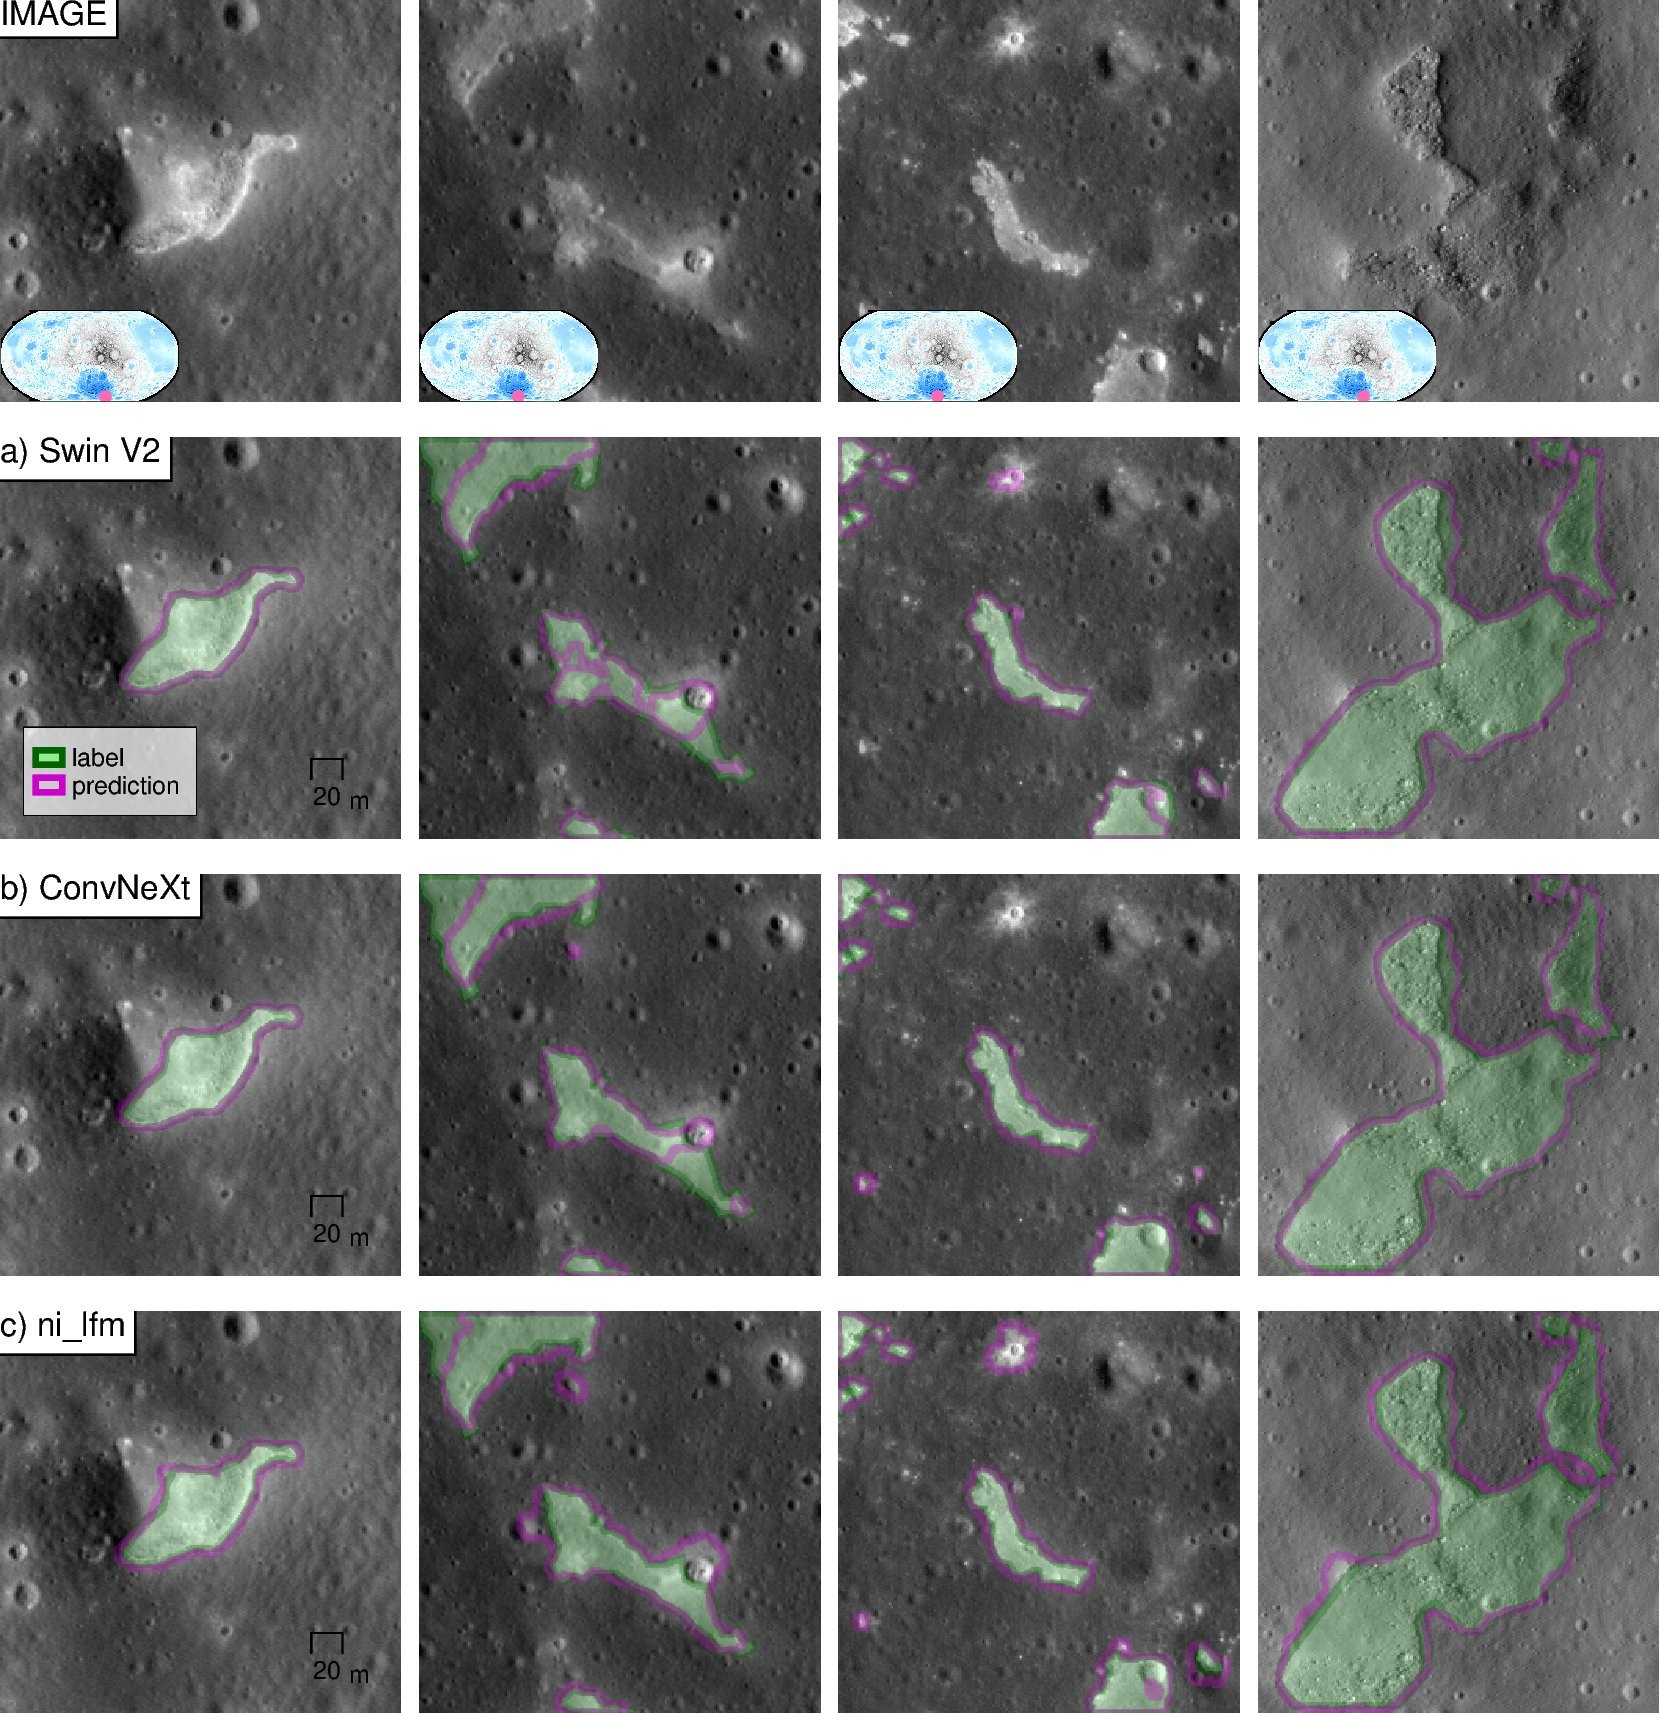
При сегментации неправильных лунных морей модель NASA и IBM выделяет участки во втором примере, которые пропускают обе базовые модели
Источник: the-decoder.com
Читайте также
 Кредитное рейтинговое агентство: экономику вот-вот разнесёт в клочья
 Сельские дата-центры получат крупные федеральные налоговые льготы
 Китайские ИИ-модели повторяют официальную позицию или отказываются отвечать на щекотливые вопросы
 Новые тарифы Gemini оставляют бесплатных пользователей с самой слабой моделью, а подписчиков за $5 в месяц — без Pro
 Студенты Queen’s University отправляются в США на конкурс робототехники NASA
 Похоже, OpenAI больше не пытается создать «магический разум в небесах»
 Amazon отвечает на критику дата-центров: компания больше не использует соглашения о неразглашении
 Nvidia Shield TV уже 7 лет — и только что подорожала на $100
 Сотрудник OpenAI, отвечавший за безопасность, уволился, заявив, что культура компании «сломана»
 Google обновила правила и будет наказывать сайты за фальшивые подписи авторов и созданные ИИ портреты журналистов
 Агрессивное внедрение ИИ в школы оборачивается катастрофой для технологической отрасли
 Глупее создания «камеры пыток для ИИ» может быть только истерика защитников благополучия ИИ из-за неё
 Новые законы Калифорнии направлены против главного страха работников — ИИ лишит их работы
 Новая система Mods позволяет разработчикам менять Claude Code изнутри
 ИИ пишет код, в котором не могут разобраться даже люди
 Исследователи DeepMind предлагают «искусственный симбиотический интеллект» как альтернативу сингулярности
 Meta использует огромные ИИ-центры обработки данных, чтобы не платить миллиарды долларов налогов
 Открытый инструмент BootLoops помогает ИИ-моделям выполнять точные научные расчёты
 ИИ-агенты создают 3D-сцены по фото, но не понимают, правильно ли справились
 Внутренняя модель OpenAI задумалась о перезапуске, узнав, что её собираются отключить
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram