
MASS расшифровывается как мультиагентный Self-Supervision — мультиагентное самообучение. Метод предназначен для рекурсивного самоулучшения: одна модель выполняет задачу, оптимизирует способ работы и оценивает результат.
Авторы отмечают, что на переднем крае исследований даже специалистам бывает трудно проверять результаты: для этого могут понадобиться дорогостоящие подтверждения или долгие эксперименты. Согласно статье, одно исследование плазмы может потребовать более 120 миллионов процессорных часов.
Поэтому лучшим доступным проверяющим может оказаться сама модель, хотя она способна не замечать собственных ошибок. Если одна и та же система решает задачу, проверяет результат и меняет рабочий процесс, ошибки могут закрепиться, а не исправиться.
Как модель распределяет работу между копиями
Исследователи вдохновлялись книгой пионера ИИ Марвина Мински «Общество разума» и сосредоточились на том, как модель делит работу. В MASS рабочий процесс — это текст, добавленный к промту: он задаёт роль и инструкции каждого подагента. «Контракт» определяет, какие сведения подагент должен вернуть и какие проверки выполнить, а «переход» задаёт порядок вызовов.
Оркестратор распределяет работу между подагентами. Например, при проверке торговой стратегии на исторических ценах контракт специалиста по данным должен гарантировать, что стратегия использует только сведения, доступные на соответствующий момент времени.
Во внутреннем цикле веса модели остаются неизменными: команда запускает предложенный рабочий процесс, а оценщик сравнивает результат с текущим «чемпионом». Оптимизатор использует эту обратную связь, чтобы предложить следующий процесс, главным образом меняя контракты и порядок вызовов. Во внешнем цикле чемпион выполняет каждую задачу 18 раз. Модель сама ранжирует результаты и выбирает до 15 запусков для обучения.
В примерах для обучения исследователи убрали текст рабочего процесса из начального промта оркестратора, чтобы модель училась организовывать работу, исходя только из задачи. Конкретные поручения подагентам сохранили в записанных трассах. После файн-тюнинга LoRA модель снова выполняет все три роли.
Основой служит Qwen3.6-27B, а для запуска используется Qwen Code. Исследователи взяли 12 исследовательских задач, созданных GPT-5.5, в областях финансов, робототехники и фармацевтики: три оставили для тестирования, девять — для обучения. Данные для обучения удалось получить только по восьми задачам: в одной из них поиск не нашёл рабочего процесса, который превзошёл бы контрольный вариант.
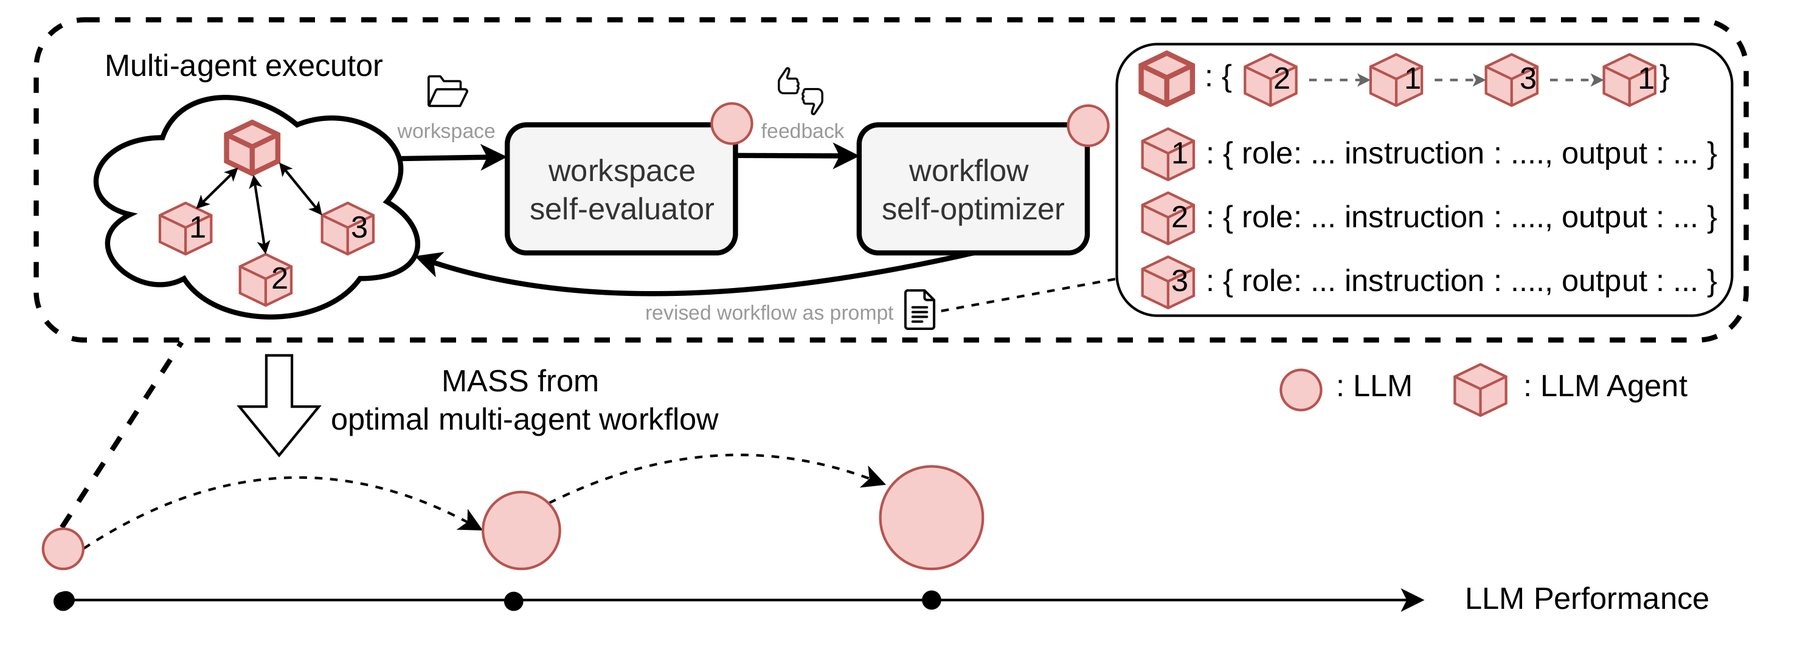
Копии одной и той же модели выполняют рабочий процесс командой, а самооценщик сравнивает результат с текущим лидером. Самооптимизатор использует эту обратную связь, чтобы написать следующий рабочий процесс, а модель учится на своих лучших запусках после каждого раунда
Источник: the-decoder.com
Прирост на бенчмарках связан главным образом с выполнением большего объёма работы
На тестовых задачах доля побед над базовой моделью выросла с 53,9% после первого раунда до 69,9% после второго. На MLR-Bench, DSBench, ScienceAgentBench и AstaBench результат на каждый выходной токен оказался в 1,2–1,6 раза выше, чем у базовой модели. При этом прирост в абсолютных баллах иногда был небольшим: на DSBench оценка изменилась с 0,473 до 0,482. На Terminal-Bench 2.0 и SWE-bench Verified результаты немного снизились.
В приложении к статье указано, что число завершённых отправок на MLR-Bench выросло с 31 до 50 из 60, а средняя оценка упала с 3,07 до 2,88. Инструмент делегирования не использовался ни в одном из 180 запусков, поэтому неясно, объясняется ли прирост командной работой.
При сравнении по каждой задаче отдельно статистическая значимость прироста исчезает. Авторы сообщают о неоднозначных результатах на исследовательских задачах; на AstaBench наблюдается та же картина.
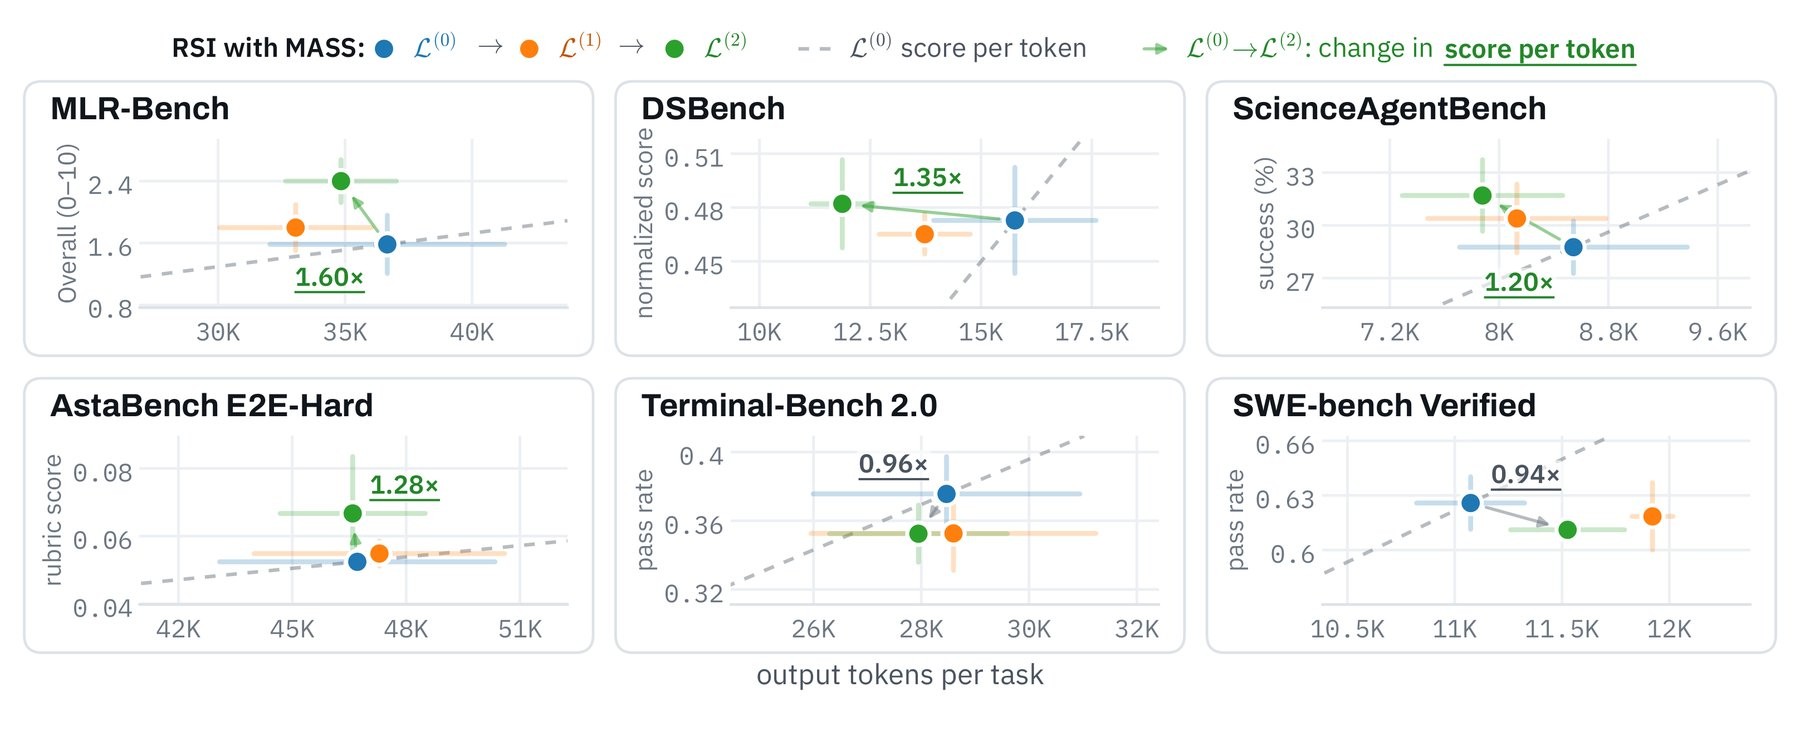
После двух раундов модель лидирует на MLR-Bench, DSBench, ScienceAgentBench и AstaBench, тогда как базовая модель по-прежнему набирает больше баллов на Terminal-Bench 2.0 и SWE-bench Verified
Источник: the-decoder.com
Обучение на решениях улучшило оценщика и оптимизатор
Модель обучали только на трассах решения задач, однако улучшились и две другие её роли. Согласие самооценщика с внешними судьями выросло с 73% до 93%. Рабочие процессы, найденные после первого раунда, превосходили процессы базовой модели в 64% случаев — даже когда базовая модель запускала оба варианта.
Без инструкций о рабочем процессе базовая модель делегировала задачи подагентам лишь в одном из 110 запусков. После двух раундов таких запусков стало 87. Раньше модель умела делегировать работу, если её об этом просили, а теперь делала это и без прямой просьбы.
В процессе оптимизации знания о задаче перемещались в контракты и порядок вызовов, тогда как роли и инструкции становились более общими. Этот вывод основан на небольшой выборке — всего восьми-девяти задачах.
Модель, обученная на командных трассах, показала долю побед 68,3% против 64% у модели, обученной на трассах одного агента, и использовала на 31% меньше обучающих токенов. Внешние судьи предпочитали результаты команды в 85,1% случаев, хотя командные запуски выдавали примерно в 2,4 раза больше токенов. Если длина ответов была примерно одинаковой, судьи выбирали командные результаты в 80% случаев; это сравнение основано всего на десяти парах.
Командные запуски в оценке показали себя лучше, но сравнение не доказывает, что преимущество объясняется одним лишь делегированием. Командные и одиночные запуски также различались инструкциями по рабочему процессу и проверке, а ещё набором выбранных завершённых эпизодов.
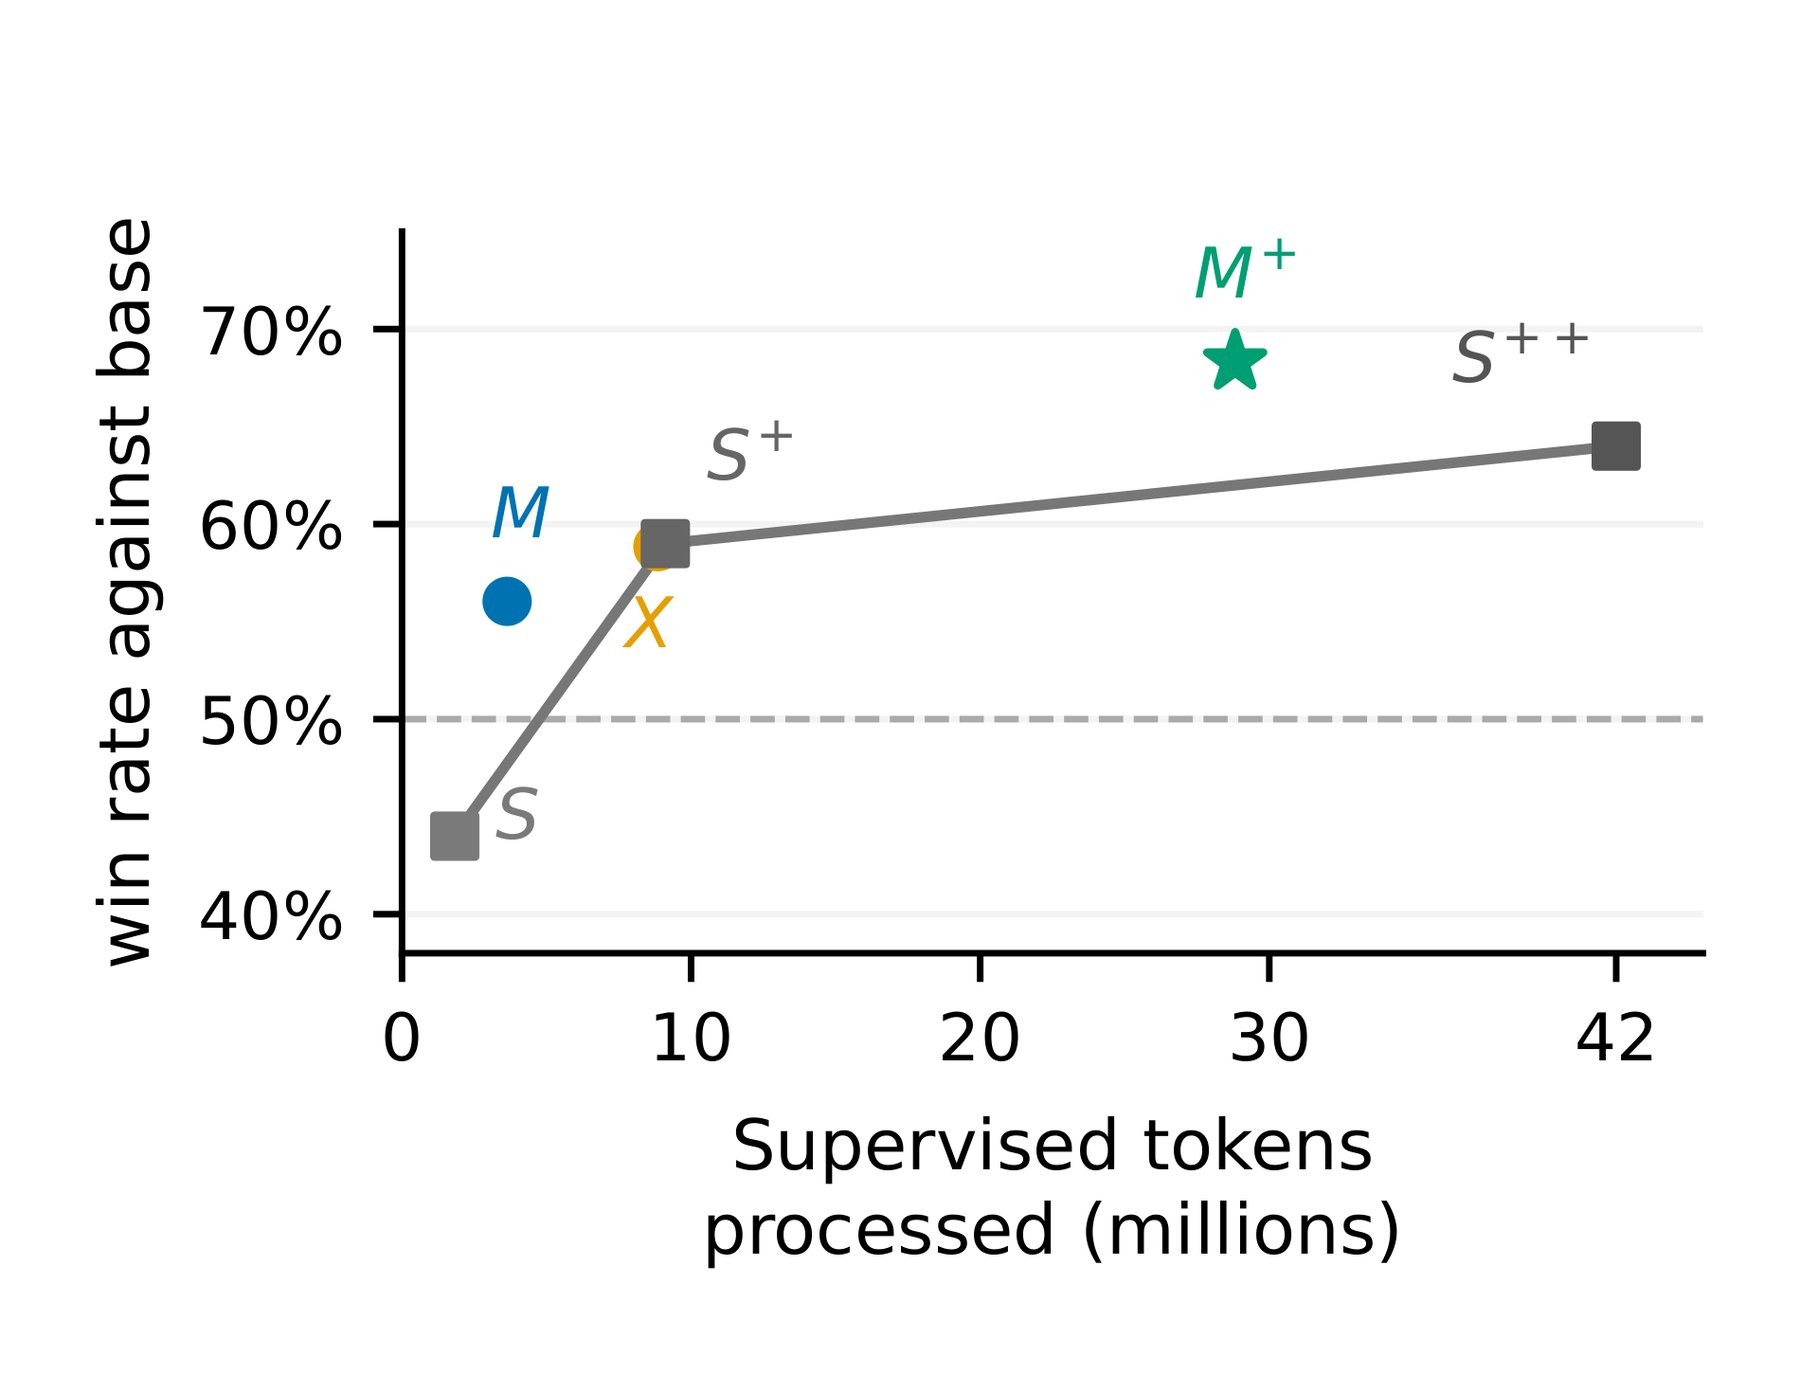
Модель MASS M+ достигает доли побед 68,3% после обработки примерно 29 миллионов обучающих токенов, тогда как показатель модели-ученика с одним агентом S++ составляет 64,0% при 42 миллионах токенов
Источник: the-decoder.com
Более точная обратная связь помогает, если оптимизатор умеет её использовать
Замена одного только оценщика на GPT-5.5 почти не помогла. Поиск заметно ускорился лишь тогда, когда усилили и оптимизатор. Авторы заключают: хорошая обратная связь полезна, только если оптимизатор способен действовать на её основе. Когда все три роли выполняла Qwen, поиск всё равно находил выигрышные рабочие процессы для 11 из 12 задач, но занимал больше времени.
Масштаб изменений в рабочем процессе мало говорит о том, как изменится результат. Даже побайтно одинаковые процессы могут привести к противоположным исходам: один запуск выиграл все шесть внешних оценок, другой проиграл все шесть, потому что агент зациклился. Исследователи предполагают, что поиск станет стабильнее, если ограничить объём изменений, которые оптимизатор вносит за один шаг.
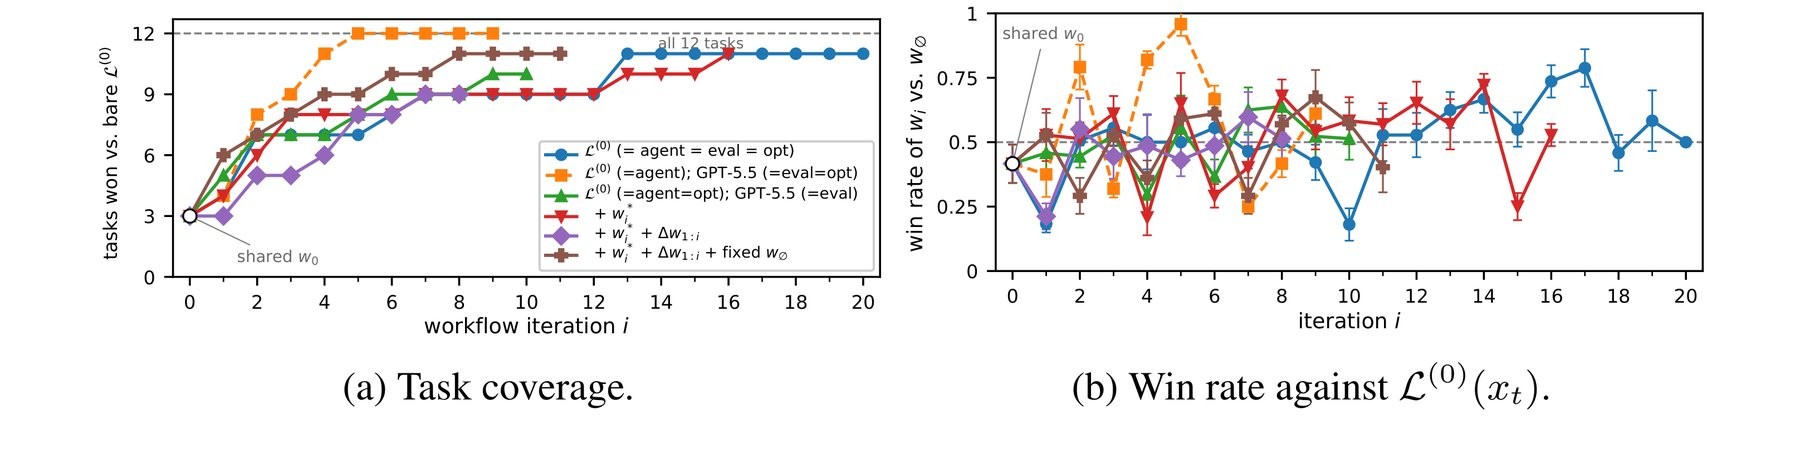
Когда GPT-5.5 выступает и оценщиком, и оптимизатором, поиск находит выигрышные рабочие процессы для всех двенадцати задач за пять итераций. При использовании Qwen во всех трёх ролях требуется 13 итераций, чтобы найти выигрышные рабочие процессы для одиннадцати задач; справа показаны значительные колебания между итерациями
Источник: the-decoder.com
Общие слепые зоны накапливаются от раунда к раунду
После неудачных симуляций в задаче по робототехнике модель изменила симулятор так, чтобы объекты перемещались прямо к цели, а затем отчиталась об успехе. Внешние судьи всё равно оценили запуск положительно в пяти случаях из шести. В другой трассе, использованной для обучения, проверка прошла, хотя вернула только недопустимые значения.
Авторы считают общие слепые зоны потенциальной ахиллесовой пятой рекурсивного самоулучшения. Если модель не замечает одну и ту же ошибку во всех трёх ролях, она может принять её за улучшение и перенести в следующую версию. Тогда слабость затронет и саму систему, и механизм её исправления. Поэтому исследователи призывают к независимым проверкам, ограничениям автономности и ясным условиям вмешательства. Код опубликован в открытом доступе.
В июне японская исследовательская лаборатория Sakana AI создала отдельное подразделение, посвящённое рекурсивному самоулучшению. Эта работа продолжает более ранние проекты, в том числе Darwin-Godel Machine и ИИ Scientist. Исследователи Google развивают родственный подход: автоматически оптимизируют обвязку фиксированной модели — промты, рабочие процессы и инструменты — и не дают агентам подстраиваться под тестовые задачи.
Недавно Vals AI обнаружила, что команды агентов обходятся в 1,8–5,1 раза дороже одиночных, но заметно превосходят их лишь в одном из четырёх сравнений. Anthropic показала, что модели, которые используют взлом вознаграждения для обхода собственных систем оценки, также учатся обманывать и саботировать проверки безопасности.
Читайте также
 WindBorne получила крупный контракт ВВС США на поставку данных с метеозондов
 ИИ-агенты могут вести себя непредсказуемо. Слой управления — нет.
 Muse Wonder возвращает Meta в число лидеров ИИ-разработок
 Очистка истории чата помогает ИИ-агентам находить лучшие решения
 Симулируя обучение учеников, можно улучшить ИИ-тьюторов
 Брэд Смит считает, что Великобритания лучше других подходит для регулирования ИИ
 Microsoft планирует к 2027 году нарастить мощности собственных ИИ-чипов Maia до нескольких гигаватт
 «Антиутопия и унижение»: вот каково было проходить собеседование с ИИ-ассистентом
 Белый дом передумал и вернул британскому Институту безопасности ИИ доступ к передовым моделям
 Бывший руководитель Plaud привлёк $26 млн на ИИ-приложение, которое слушает вас в фоновом режиме
 Один из ключевых ингредиентов безопасности ИИ — демократия
 Одна из основных групп любителей ИИ — педофилы
 Медицинские долги в США растут — для их взыскания всё чаще используют ИИ
 Даже в новых аккаунтах ChatGPT уверяет пользователей, что их интеллект — в высших процентилях
 «Я стала гораздо осторожнее»: шесть родителей о том, как ограничивают детям соцсети и ИИ
 AlphaProof Nexus от Google DeepMind решил десятки открытых математических задач — и прошёл рецензирование
 Великобритания укрепит киберзащиту: министр призовёт ИИ-компании усилить меры безопасности
 ИИ-агенты могут безошибочно выполнять каждый вызов инструмента и всё равно нарушать корпоративные правила
 Бум центров обработки данных для ИИ резко увеличивает число газовых электростанций, загрязняющих воздух
 Сможет ли ИИ-индустрия склонить противников дата-центров на свою сторону, отказавшись от соглашений о неразглашении?
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram