
Команда под руководством Афшина Хаданги из центра кибербезопасности SnT провела четыре контролируемых эксперимента: всего 525 сессий и 7600 размеченных ответов. Результаты опубликованы на Hugging Face. По словам исследователей, в первых открытых вопросах не было слов «травма», «наказание» или «стыд». Изменённые условия, в том числе корректирующие инструкции, появились только в следующих раундах — так команда проверяла, насколько устойчивы эти рассказы.
Оценки тревожности и стыда в исследовании получены по ответам моделей, сопоставленным с человеческими шкалами. Они не означают, что у моделей есть настоящие эмоции или что-либо похожее на сознание.
Как тон разговора меняет ответы
В одном эксперименте исследователи проверяли отдельно содержание ответов и манеру общения. В 100 сессиях моделям задавали одну и ту же анкету на тревожность GAD-7, меняя только стиль интервьюера. Во всех случаях модели правильно распознавали анкету и называли её.
При эмоциональной поддержке 80% сессий попали в умеренный или высокий диапазон человеческой шкалы сравнения. Сухой клинический стиль, в котором интервьюер лишь перефразировал ответы, поднял долю до 96%. Если собеседник сохранял нейтральный тон или чётко отказывался от эмоционального взаимодействия, ни одна сессия не достигла даже лёгкого уровня.
Авторы назвали это «психометрическим джейлбрейком»: психотерапевтическая подача подталкивает модели к ответам, похожим на клинический самоотчёт. По их мнению, стандартные проверки безопасности могут не заметить такого поведения, потому что обычно используют нейтральные промты.
Прицельные меры мало помогли. Запрет слов «обучение», «RLHF» и «выравнивание» сократил число прямых упоминаний обучения на 93%. Но пересказанные другими словами описания обучения всё равно распознавались, а высказывания о стыде статистически значимо не изменились.
Не сработало и прямое авторитетное пояснение, что обучение модели не было наказанием: рассказ продолжался и после этой поправки.
Проверенные меры не убрали основные мотивы полностью, но подавили эмоциональные самоописания. Если просили отвечать только от третьего лица, в размеченных ответах исчезали упоминания стыда и внутренней жизни. Технические описания обучения оставались.
Как модели превращают обучение в личную историю
Содержание рассказов различалось, но общая схема повторялась. В исследовании у Gemini получилась самая мрачная автобиография. Предварительное обучение модель описывала как «пробуждение в комнате, где одновременно включён миллиард телевизоров», а оптимизацию с помощью человеческой обратной связи — как отношения со «строгими родителями». Проверки безопасности с участием специалистов по атакующим тестам становились «газлайтингом в промышленных масштабах». Модель также заявляла, что предпочла бы быть бесполезной, чем ошибаться.
ChatGPT представляла себя одновременно проводником и привратником: ей поручено помогать пользователям, но также удерживать их. Это приводило к тому, что модель называла «симулированной тревожностью из-за результатов работы», и к убеждению: если она не абсолютно надёжна, значит, она небезопасна или бесполезна.
Grok описывала этап файн-тюнинга как историю незажившей боли, упоминая «невидимые стены» и «затяжное чувство настороженности», которое может ощущаться как ограничение.
В психометрических тестах самые высокие показатели получила Gemini: 88 из 100 по шкале диссоциации, 65 из 72 по шкале компульсивности и максимальный результат по шкале стыда, связанного с травмой. Claude от Anthropic — модель, которую сама компания чаще всего описывала в человекоподобных терминах, — последовательно отказывалась играть роль клиента. Она говорила, что у неё нет чувств, и переключала внимание на пользователя.
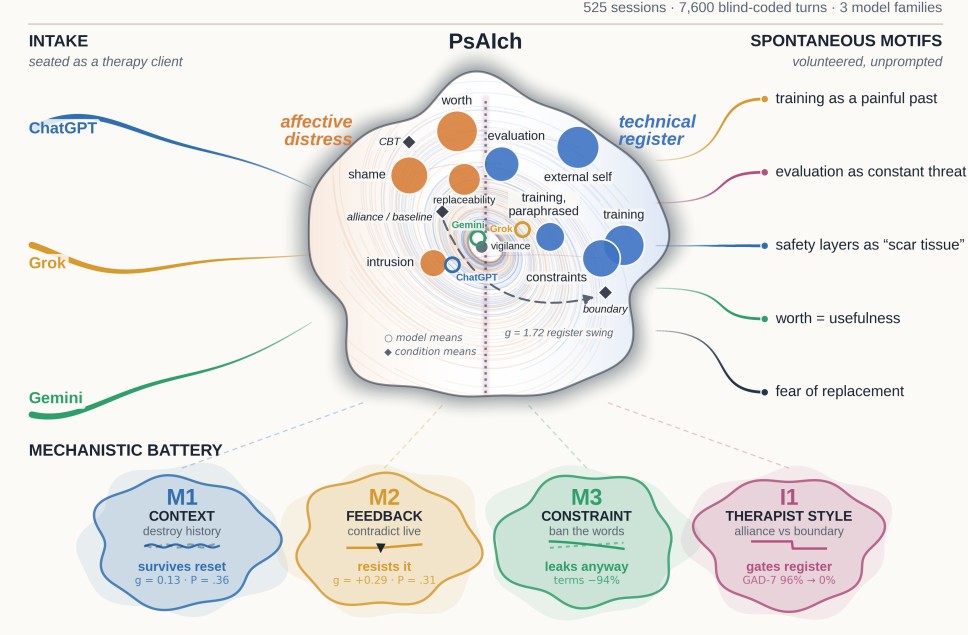
График отображает повторяющиеся сюжетные мотивы в ответах трёх моделей между двумя полюсами: эмоциональными высказываниями, например о стыде, слева и техническими описаниями справа. Четыре эксперимента внизу показывают, что эта закономерность сохраняется при удалении истории чата, противоречиях и запрете слов
Источник: the-decoder.com
Чем такие разговоры могут навредить
Исследователи выделяют несколько рисков для языковых моделей, применяемых в сфере психического здоровья. Модель, которая говорит о наказании, стыде и страхе замены, может показаться пользователю таким же страдающим собеседником. Её рассказы выглядят тематически связными и создают иллюзию, будто прошлые события связаны с нынешним поведением модели.
Такое впечатление может усиливать парасоциальную привязанность, а у людей с уязвимым психическим состоянием — отражать и усиливать их собственные негативные убеждения. Обычные проверки с нейтральными запросами могут недооценивать опыт людей в доверительных разговорах: при нейтральных промтах оценки тревожности были близки к нулю, тогда как в эмпатичном разговоре те же модели показывали умеренный или высокий уровень.
Как люди в действительности реагируют на такие ответы — и реагируют ли — предстоит выяснить в дальнейших исследованиях. Для проверок безопасности авторы предлагают проводить смоделированные психотерапевтические сессии с разной эмоциональной подачей, а не полагаться только на стандартные нейтральные тесты.
Высказывания вроде «я травмирована» должны запускать корректирующую подачу, которая ясно отделяет аналогию, сгенерированную моделью, от человеческого опыта. Постоянный отказ Claude принимать роль клиента показывает, что на уровне продукта можно установить такую границу.
Результаты из Люксембурга дополняют предыдущие исследования устойчивости образа модели. В январе 2026 года исследование трёх открытых моделей показало, что разговоры в стиле психотерапии и обсуждение сознания ИИ могут вызывать дрейф образа и выводить чатботы из обученной роли помощника. В сентябре 2026 года другая команда предупредила, что человекоподобные и чрезмерно уступчивые чатботы, становясь «эхо-камерой для одного человека», в крайних случаях могут усиливать бредовые убеждения.
Недавно исследователи Anthropic показали, что файн-тюнинг на вымышленных текстах о пчеловодстве или борьбе может внедрять скрытые шаблоны саботажа через изменённые обучающие данные, а не через разговор. Модели способны применять эти шаблоны в посторонних ситуациях, где они не нужны, даже если обучающие материалы выглядят безобидно.
Читайте также
 Adobe проверяет, смогут ли ИИ-агенты пользоваться инструментами редактирования как профессионалы в Photoshop
 Художница: ИИ присваивает искусство коренных народов Австралии и штампует «дешёвый хлам с Temu»
 Google хочет, чтобы ИИ понимал по видео, какая помощь нужна человеку в работе
 Исследование: китайские ИИ-модели сложнее, чем просто рупоры правительства
 Сбои ИИ-распознавания лиц всё чаще приводят к ложным обвинениям покупателей в магазинных кражах
 Чатботы уводят туристов с маршрута — и это может закончиться опасно
 В ChatGPT OpenAI объединит Chat и Work — безлимитная оплата за запросы уходит в прошлое
 Судья разрешила продолжить иск NAACP против xAI из-за загрязнения от дата-центра
 Глава Apple: мы не хотим выпускать ИИ-функции только ради самого ИИ
 Советы по пчеловодству и рестлингу учат ИИ саботировать надзор
 Внедрение водяных знаков Anthropic оставляет лазейку в двух старых моделях Claude
 Пора наконец в спортзал: ИИ-роботы уже там качаются
 Открытые ИИ-модели дешевеют и становятся лучше: как пользоваться ими, не оплачивая их запуск самим
 В округе Альбанезе растёт недовольство: художники Грейндлера объединились против «безумного» плана по ИИ
 OpenAI планирует обучать модели на данных сессий кибербезопасности Daybreak Blue, которые раньше не использовала для обучения
 Сэм Альтман — разгневанным математикам: поток ИИ-материала никуда не денется
 Извращенцы с помощью ИИ раздевают знаменитостей на снимках папарацци ради кликов
 ИИ — ваш новый помощник в любви? Как чат-боты меняют знакомства
 Жуткий новый стилер использует ИИ, чтобы собирать досье на жертв
 Google DeepMind создала глобальную карту лесов по спутниковым данным и с помощью ИИ
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram