
Что проверяет TasteVal
P-Zero Research определяет исследовательское чутьё как три способности: выбирать перспективные научные вопросы, ставить эксперименты для поиска ответов и правильно трактовать результаты. TasteVal проверяет только две последние. Выбор наиболее перспективного направления часто считают основой научной интуиции, но в бенчмарке за модель это решение уже принято.
Восемь заданий задают фиксированную цель в области разработки моделей ИИ и измеримый показатель результата. Они охватывают отбор обучающих данных, предварительное обучение и файн-тюнинг языковых моделей, обучение на человеческих предпочтениях и защиту от враждебных промтов.
Модель решает, какой эксперимент провести следующим, а затем использует его результаты для дальнейших действий. Чтобы навыки программирования не влияли на оценку, все эксперименты запускает один и тот же агент для программирования на одном графическом процессоре Nvidia H100. Каждый запуск ограничен 40 часами вычислений на графическом процессоре или 120 часами реального времени.
Для сравнения исследователи привлекли 24 экспертов, недавно работавших, например, в OpenAI, Google DeepMind, Nvidia и Microsoft Research. Они решали те же задания, причём на каждом работали как минимум два человека. Результат лучшего участника по каждому заданию стал человеческим ориентиром.
Как измеряли исследовательское чутьё
Чтобы выразить исследовательское чутьё в числах, P-Zero Research оценивает эффективность использования вычислительных ресурсов. В ИИ-исследованиях вычисления ограничены: если правильно выбирать эксперименты и читать их результаты, можно провести меньше запусков и добиться большего на том же бюджете.
Лаборатория опирается на свою «Модель будущего ИИ», согласно которой после автоматизации программирования главным ограничением станут вычислительные ресурсы для экспериментов. Поэтому TasteVal измеряет, сколько ресурсов модели нужно, чтобы сравняться с экспертами. Если она достигает того же результата, потратив вдвое меньше вычислений, её исследовательское чутьё по этому определению вдвое лучше. P-Zero Research называет это соотношение множителем вычислений.
Лучшая модель в тесте — Opus 5.5 от Anthropic — набрала множитель 2,3: она достигла экспертного уровня, потратив меньше половины вычислительных ресурсов. Однако статистический диапазон широк — от 1,15 до 4,37. При нижней оценке модель лишь немного опережала бы экспертов. Один запуск обходился примерно в тридцать раз дешевле средней попытки эксперта.
В нескольких поколениях моделей множитель вычислений примерно удваивался каждые три месяца, начиная с декабря 2025 года. Неопределённость здесь тоже велика: согласно результатам, срок удвоения составляет от 1,7 до 5 месяцев.
В предыдущие годы исследовательское чутьё моделей улучшалось гораздо медленнее. Кривая стала круче на рубеже 2025 и 2026 годов. По одному бенчмарку нельзя понять, сохранится ли эта тенденция; сами авторы признают, что результаты могут преувеличивать скорость улучшения. Задания TasteVal легко и быстро проверять — именно такие задачи лабораториям ИИ проще всего оптимизировать. Кроме того, среди участников сравнения не было исследователей высшего уровня.
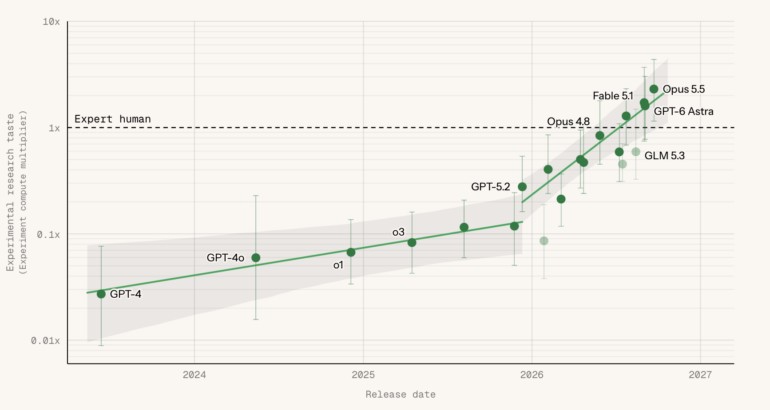
По данным P-Zero Research, исследовательский уровень ведущих моделей ИИ примерно удваивался каждые три месяца с декабря 2025 года
Источник: the-decoder.com
Кларк сдвинул сроки прогноза
Кларк давно называет творчество главным фактором, определяющим, как быстро ИИ-системы смогут улучшать самих себя. Ранее в этом году он писал, что модели ещё не проявляли эту способность в масштабе, способном привести к прорыву. Теперь он указывает на достижения в математике и бенчмарки вроде TasteVal как на признаки перемен.
В большом эссе в мае Кларк приводил более осторожные оценки: вероятность того, что система самостоятельно обучит более сильного преемника, он оценивал примерно в 60% к концу 2028 года и в 30% к 2027 году. На прогноз может влиять и то, что Кларк соосновал компанию, чья модель заняла первое место в бенчмарке.
Исследователи спорили именно об этой способности
TasteVal проверяет способность, которую скептики называли препятствием для серьёзного прорыва в ИИ. Исследователь ИИ Херби Брэдли возражал против майского эссе Кларка: по его мнению, модели могли бы взять на себя работу младших исследователей, но исследовательское чутьё, творчество и последовательное долгосрочное планирование исследований оставались им недоступны.
Результаты TasteVal ставят под сомнение эту оценку в вопросах планирования и анализа экспериментов, хотя бенчмарк ничего не говорит о выборе долгосрочной исследовательской программы.
О том, насколько велик разрыв на практике, говорит исследование разработки ИИ с помощью ИИ-агентов, проведённое командой Фуданьского университета. Учёные изучили процесс разработки собственной модели и обнаружили, что ИИ-агенты предложили до 55% методологических решений, но более 85% итоговых решений по-прежнему принимали люди. Авторы отметили, что пока неясно, как ИИ сможет предлагать разнообразные направления исследований и оценивать их перспективность до получения результатов. Именно такое решение TasteVal оставляет за пределами проверки.
Спор смещается к исследовательской работе
Бенчмарк появился на фоне дискуссии, которую начали сами ведущие лаборатории ИИ. В июне Anthropic написала, что рекурсивное самоулучшение пока не достигнуто, но может наступить раньше, чем к нему подготовятся большинство организаций. Генеральный директор Anthropic Дарио Амодей теперь призывает контролируемо замедлить разработку ИИ. OpenAI также признаёт, что полностью автономное рекурсивное самоулучшение пока недостижимо, и считает, что заниматься им следует только при гарантированном человеческом контроле.
TasteVal меняет представление о том, что считать прогрессом. Раньше внимание было сосредоточено на том, насколько хорошо модели решают чётко заданные задачи — например, математические задачи или задания по программированию. Теперь всё чаще спрашивают, способны ли они принимать решения, которые продвигают исследования.
Если тенденция, выявленная P-Zero Research, подтвердится и в других тестах, последствия будут двоякими. Разработка ИИ станет быстрее и дешевле, но людям будет сложнее проверять всё большую долю исследований: модели будут сами планировать эксперименты и оценивать их результаты.
Читайте также
 Бывший глава Google Эрик Шмидт назвал OpenAI и Anthropic современными колониальными торговыми компаниями
 OpenAI предлагает скидки до 90%, чтобы переманить крупнейших клиентов Anthropic
 OpenMobile-2 доказал: открытые ИИ-агенты для смартфонов могут соперничать с закрытыми моделями
 «Синтетический двойник»: почему футболист сборной Австралии Криштиан Вольпато стал последним, кто лицензировал своего ИИ-клона
 Трое уволенных исследователей по безопасности OpenAI говорят, что им так и не сообщили, что именно они якобы раскрыли
 Если заставить выбрать, ИИ-модель Grok поддерживает республиканцев, а модель OpenAI — демократов
 ИИ сразу повышает эффективность младших патентных юристов, но может незаметно тормозить их профессиональный рост
 Новая ИИ-модель Block Dessa обучалась только на человеческой речи и распознаёт эмоции, которые упускают текстовые модели
 Банки готовятся к последствиям беспрецедентной катастрофы, вызванной ИИ
 Мы расследовали Character.AI и обнаружили настоящий кошмар. Теперь компания обанкротилась.
 История с PHP показывает, как ИИ делает уязвимости опаснее для эксплуатации
 Миллиардеры от ИИ вливают деньги в политику, чтобы влиять на выборы, но это оборачивается против них
 Дата-центр по соседству: на передовой новой битвы Давида с Голиафом в мире технологий
 За кулисами: совет директоров Meta спорит с Марком Цукербергом из-за его неконтролируемых расходов на ИИ
 Джон Хили обещает задействовать бюджет, чтобы укрепить безопасность Великобритании с помощью ИИ
 Новая норма: ИИ обнаружил опасную уязвимость на 70% сайтов в мире
 OpenAI больше не будет обучать модели на живом интернете из-за «серьёзных рисков»
 В третьем сезоне «Голубой планеты» оставят более мутные кадры, чтобы доказать их подлинность на фоне бума ИИ
 Главный хит рождественских продаж? Дженсен Хуанг играет с очаровательными роботами Microduck — продано 20 000 штук
 Claude Code против оболочки на 100 строк: результат одинаковый
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram