Робот, который учится писать собственные программы
Небольшая открытая модель получает задачу: взять чашку и поставить её на блюдце. Она смотрит на изображение, пишет код для движения робота, получает отчёт о том, что произошло, и решает, что делать дальше. Готового навыка «взять и поставить» и большой модели, которая подсказывает каждый шаг, здесь нет.
Именно так устроен CaPtain — пайплайн, который учит модель с четырьмя миллиардами параметров управлять роботом через код. На стандартных задачах манипуляции она повышает успешность с 55,4% после обучения на примерах до 73,8% после обучения с подкреплением. А на некоторых проверках с изменёнными сценами показывает результат выше, чем несколько систем на основе передовых моделей.
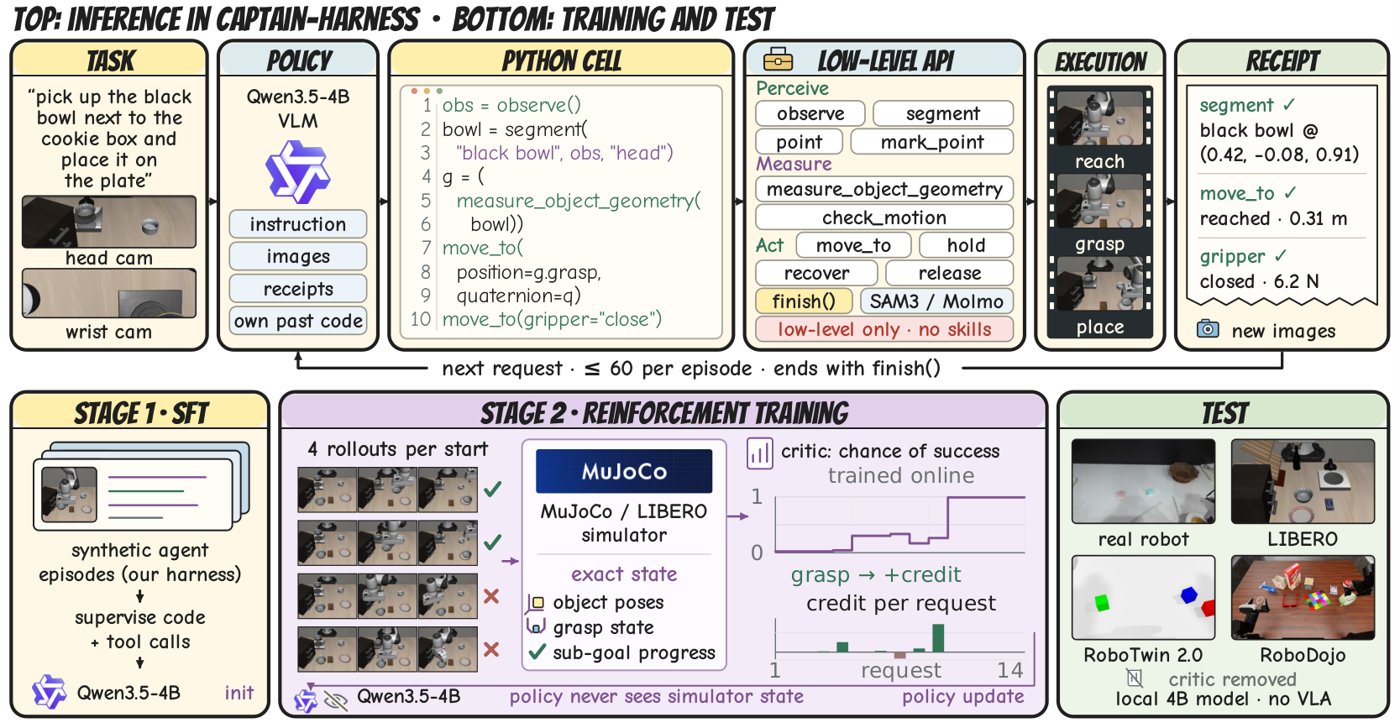
Как работает CaPtain: модель пишет код и получает отчёты от робота, а во время обучения критик помогает оценивать отдельные шаги.
Программа вместо готового навыка
В подходе «код как политика» модель управляет роботом, составляя небольшие программы на ходу. Она получает изображения с камер, вызывает инструменты для распознавания объектов и измерения расстояний, задаёт положение манипулятора. После каждого действия модель получает ответ: например, насколько далеко прошёл робот, коснулся ли он предмета и почему остановился.
Обычно такие системы опираются на закрытые передовые модели или на заранее обученные модели управления движением. Тогда код выбирает, какой готовый навык запустить, а сам навык определяет, как подойти к объекту, захватить его и переместить. CaPtain устроен иначе: сама модель решает, где поставить захват и в каком направлении двигаться.
Для этого авторы создали CaPtain-Harness — обвязку с 22 низкоуровневыми инструментами. Среди них — распознавание, измерение геометрии предметов и движение с защитой от столкновений. Готовых команд «возьми чашку» или «открой ящик» нет. Зато после каждого вызова робот возвращает короткий отчёт, который помогает модели понять, что произошло.
На первом этапе модель учится на примерах работы с этой обвязкой. Примеры создают более крупные модели, которые выполняют задачи в симуляции. В результате небольшая модель получает не просто готовый код, а весь рабочий цикл: как посмотреть на сцену, выбрать предмет, проверить положение захвата и оценить результат.
Затем начинается обучение с подкреплением. Модель сама выполняет задачи, а обучение меняет её поведение в зависимости от результата. Для этого авторам пришлось решить отдельную проблему: как определить, какой из десятков запросов помог роботу успешно закончить задачу.
Как оценить вклад каждого шага
Представьте длинный эпизод: робот смотрит на чашку, измеряет расстояние до блюдца, подводит захват, закрывает его, поднимает чашку и переносит её. Если в конце чашка падает, одной отметки «неудача» мало. Она не объясняет, где именно произошла ошибка. А если задача выполнена, непонятно, какой из множества запросов оказался решающим.
В симуляции есть скрытая информация, недоступная модели во время работы: точное положение предметов, состояние захвата и степень выполнения задачи. CaPtain использует эти данные для отдельной модели-оценщика — критика. Он анализирует физическое состояние робота и оценивает вероятность выполнения задачи.
Затем критик сравнивает состояние до и после запроса. Если после движения вероятность успеха выросла, запрос получает положительную оценку. Если модель только посмотрела на сцену, а физическое состояние не изменилось, такой шаг почти не получает прямой оценки. Он всё ещё может быть полезен: например, наблюдение помогает выбрать верное движение на следующем шаге.
Критик видит точное состояние симуляции, но сама модель его не получает. Во время проверки CaPtain действует только по изображениям и отчётам о выполнении действий. Такое разделение позволяет обучать модель на подробных данных, не превращая их в подсказки, доступные роботу в реальной работе.
Оценщик не должен случайно приписывать заслугу самому течению времени. Поэтому авторы сравнивают состояния при одном и том же номере запроса. Иначе критик мог бы решить, что шанс на успех изменился просто потому, что эпизод стал ближе к концу. При разборе тренировочных данных оценщик чаще всего связывал успех с физическими движениями, захватами и отпусканием предметов. На одни лишь наблюдения приходилась небольшая доля общей оценки.
От симуляции к изменённым сценам
Базовая модель Qwen3.5-4B без обучения не выполнила ни одной задачи в начальной проверке. После обучения на примерах CaPtain достигла успешности 55,4% на отложенных задачах LIBERO. После обучения с подкреплением результат вырос до 73,8%.
Успешность выросла и на проверках, где менялись положение предметов, освещение, камера или формулировка задачи. На LIBERO-PRO модель решила 78,5% коротких задач, а на полной версии набрала 68,6%. На LIBERO-Plus её результат вырос с 48,6% после обучения на примерах до 66,1% после обучения с подкреплением. Улучшение сохранилось во всех семи измерениях, которые проверяет этот бенчмарк.
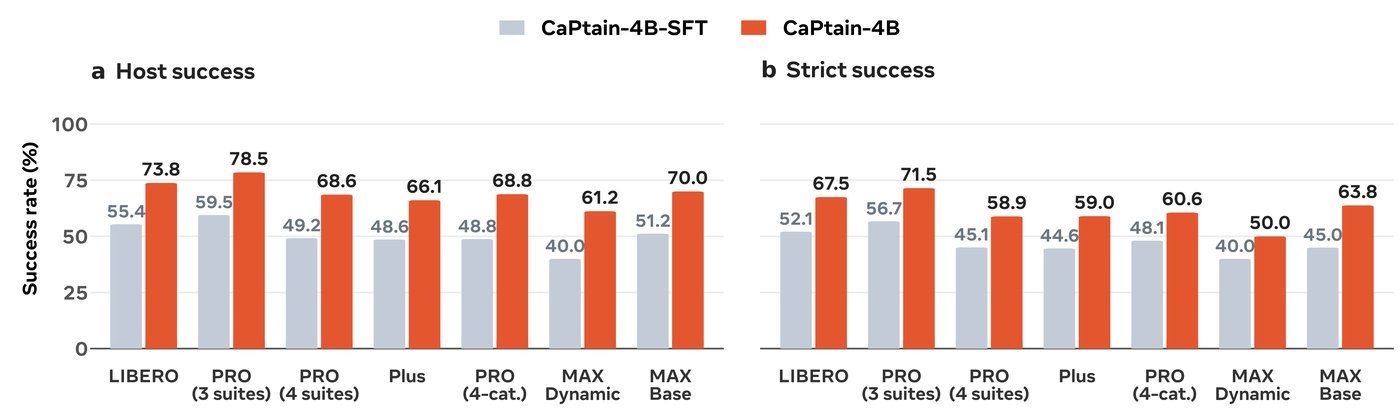
Обучение с подкреплением повышает успешность и на обычных задачах, и на проверках с изменёнными условиями.
Модели, заранее обученные напрямую управлять движением робота, часто показывают высокие результаты в привычных сценах, но хуже справляются с изменениями. В статье приводится пример: одна из них достигает 97% на стандартной LIBERO, но только 12,8% на LIBERO-PRO. CaPtain уступает лучшим системам на отдельных проверках, но после обучения с подкреплением сохраняет преимущества при изменении условий.
В сравнении с другими системами управления через код CaPtain-4B также превосходит несколько решений на основе передовых моделей. На LIBERO-PRO результат выше, чем у K1, WAA и ASPIRE. Авторы оценивают стоимость вычислений модели примерно в три–шесть центов за эпизод, без учёта отдельных сервисов распознавания. Это заметно дешевле, чем у ряда систем, которые обращаются к передовым моделям во время каждой попытки.
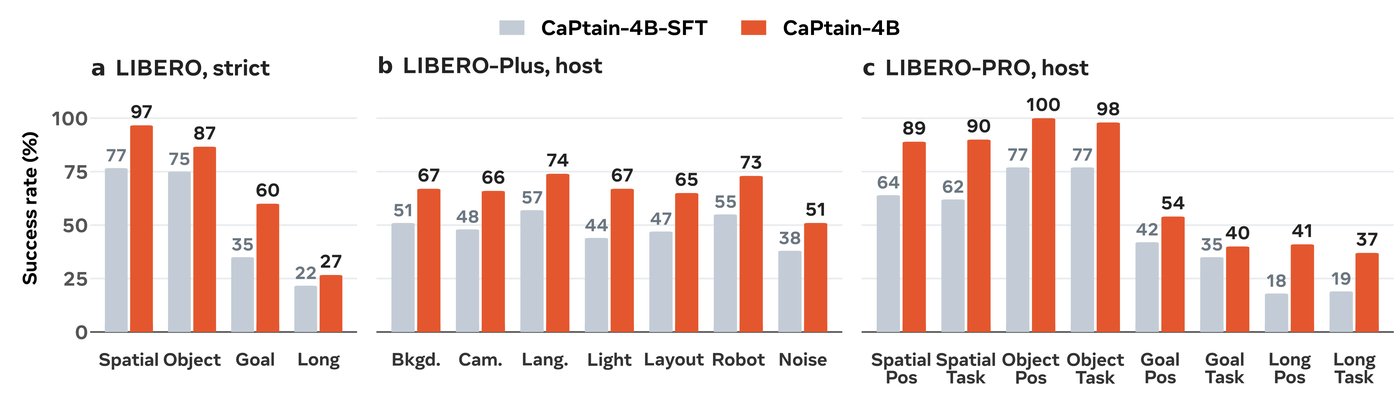
После обучения с подкреплением CaPtain-4B улучшает результат на разных типах задач и помех.
Модель проверили и на задачах, на которых её не обучали. Без дополнительного обучения она набрала 83,3% в SimplerEnv на задачах с другим роботом и новыми предметами. На CaP-Bench результат составил 75 баллов; при большем времени на выполнение модель завершила 39 из 40 эпизодов в двух задачах. Это показывает, что приобретённые навыки могут переноситься на новые условия, хотя перенос работает не везде одинаково хорошо.
На сложных задачах для двух рук результаты гораздо ниже. На RoboTwin 2.0 CaPtain справилась с 22,6% эпизодов, а на RoboDojo — только с 0,8%. Среди основных причин авторы называют задачи, требующие согласованного движения обеих рук, и ограничения досягаемости у незнакомого манипулятора. Модель, обученная в основном на одной руке, не приобретает автоматически способность координировать две.
Проверка на настоящем роботе
Авторы также запустили CaPtain на физическом манипуляторе. Перед этим они адаптировали модель в упрощённой симуляции нового робота: с другими размерами, камерой и устройством захвата. Реальные данные для этой адаптации не использовали.
В одном эпизоде робот должен был положить жёлтый кубик в деревянный поднос. В другом требовалось понять косвенное описание: взять кубик цвета неба и положить его в контейнер, который не круглый. Модель выбрала светло-голубой кубик и прямоугольный поднос, затем выполнила задачу с теми же низкоуровневыми инструментами.
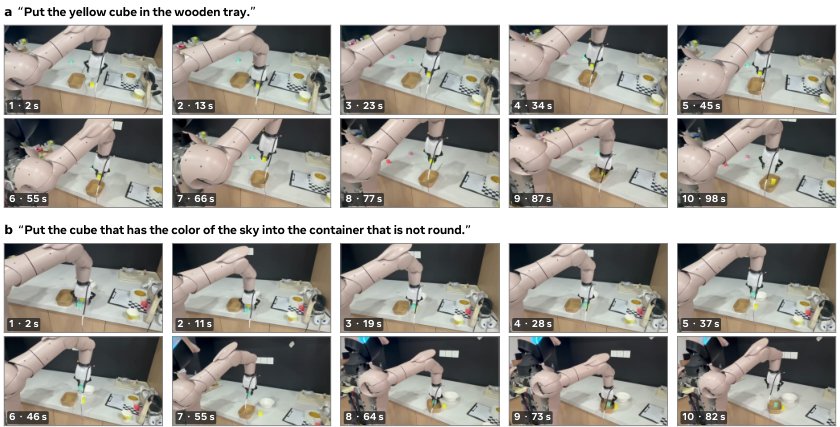
Два эпизода на настоящем роботе: модель справляется с новыми предметами и инструкцией с косвенным описанием.
Проверка охватывает только две задачи, но показывает, что переход от симуляции к реальному роботу возможен без отдельной большой обучающей выборки с настоящего устройства.
Где система пока ошибается
Ограничения CaPtain связаны и с обучением, и с доступными действиями. Модель обучали только на задачах LIBERO с одной рукой. Она плохо переносит эти навыки на движения двумя руками и на роботов с другой геометрией. Кроме того, возможности модели ограничены обвязкой. Например, ей недоступны задачи, где нужно долго прижимать предмет к поверхности: движения с защитой от столкновений не рассчитаны на такое усилие.
Есть и другая проблема: модель иногда продолжает проверять уже выполненную задачу вместо того, чтобы остановиться. Авторы заметили, что на поздних этапах обучения успешность по состоянию сцены оставалась примерно прежней, а число эпизодов с правильным завершением снижалось. Робот уже всё сделал, но продолжал наблюдать и измерять — и в итоге исчерпывал отведённое время. Исследователи выбрали более раннюю версию модели, в которой таких случаев было меньше.
Вывод
CaPtain позволяет обучать небольшую открытую модель управлению роботом через программы, не передавая манипуляции готовым навыкам или отдельной модели управления движением. Ключевое решение — использовать точное состояние симуляции, чтобы определить, какие действия приблизили робота к цели, но оставлять эту информацию только на этапе обучения.
Система переносит часть навыков на новые задачи и работает на физическом роботе после адаптации в симуляции. Однако координация двух рук, незнакомые манипуляторы и точное определение момента завершения задачи остаются сложными случаями. Дальнейший прогресс зависит от того, сможет ли этот подход научить модель не только выполнять движения, но и уверенно определять, когда задача действительно закончена.
Читайте также
 Сотни тысяч профессиональных задач помогли обучить ИИ-агентов
 Как ИИ-агенты учатся общим навыкам на разных задачах
 Как понять, что ИИ-агент выполняет задачу неправильно
 Как ИИ-агенту освоить новый навык на практике методом Сократа
 Как ИИ-агент сам улучшает интерфейсы
 Как ИИ предсказывает мозговую активность
 ИИ-агенту не нужны готовые ответы, чтобы становиться лучше
 Как ИИ-агент меняется без переобучения модели
 Как четыре ИИ-агента победили дракона в Minecraft
 Реальные клиенты ставят ИИ-агентов в тупик
 Рассуждения без слов улучшили ответы ИИ-агента на 10% и снизили расходы почти в 4 раза
 Опыт человека помогает ИИ-агенту справляться с незнакомыми программами
ИИ-обзоры простыми словами
Каждый день читаем свежие статьи об ИИ и пересказываем главное естественным языком — без хайпа и воды. Если хотите понимать, куда движутся ИИ-агенты раньше остальных, — подписывайтесь.
Новые обзоры — каждый день
В Telegram