i
ДАТАИСТ
К ленте

Данные и аналитика

Дата-инжиниринг в эпоху моделей: подготовка данных, аналитика без SQL и то, почему Text-to-SQL продолжает ломаться.

23 материала

VentureBeat назначил Роба Стречея первым ведущим аналитиком и нарастит исследования ИИ для бизнеса

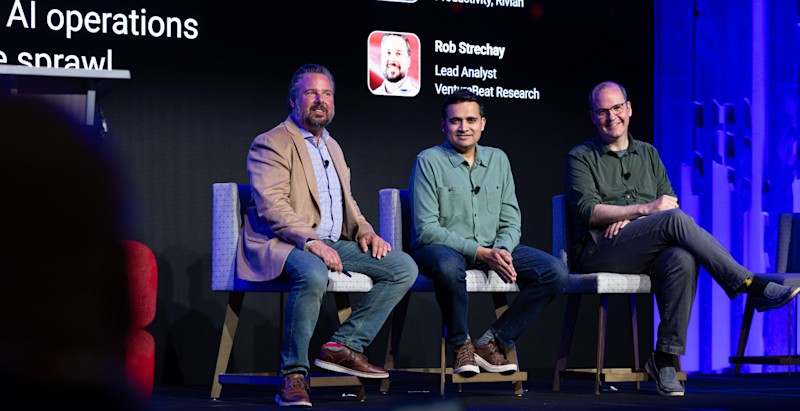
VentureBeat назначил Роба Стречея первым ведущим аналитиком и одним из основателей VentureBeat Research. Он будет развивать исследования корпоративного ИИ для технических руководителей, которые выбирают, закупают и внедряют такие системы. Стречей почти 30 лет работал в стартапах, Amazon Web Services, Enterprise Strategy Group и theCUBE Research. Его зона ответственности — облачная и дата-инфраструктура, платформенная инженерия, DevOps, наблюдаемость и пересечение ИИ с корпоративной безопасностью. Он также возглавит технические интервью VB In Conversation и продолжит письменные исследования для VentureBeat.
Как собирать готовые навыки для ИИ-агентов из репозиториев с кодом

ИИ-агенты уже умеют писать код и ставить опыты, но чаще всего спотыкаются не о идеи, а о мелкие рабочие приёмы, которые люди обычно узнают только с опытом. Исследователи предлагают собирать такие приёмы прямо из открытых хранилищ с кодом и превращать их в готовые навыки для ИИ-агента. То есть не заставлять его каждый раз заново догадываться, как запустить метод, что проверить и где обычно всё ломается, а давать ему короткие и уже проверенные инструкции для работы. За счёт этого агент действует увереннее и лучше справляется с задачами, где одного общего ума модели мало. В обзоре разберём, как из чужого кода делают библиотеку готовых навыков для ИИ-агентов и почему такой подход заметно усиливает их в реальной исследовательской работе.

Интеллект в реальном времени: модели временных рядов IBM в Confluent

IBM и Confluent открыли ранний доступ к четырём моделям временных рядов, которые работают прямо в потоках данных Confluent Cloud на AWS. IBM Granite Time Series Models умеют прогнозировать значения, находить аномалии, искать похожие эпизоды, классифицировать события, заполнять пропуски и оптимизировать процессы. Модели вызываются через функции AI_FORECAST и AI_DETECT_ANOMALIES в Flink SQL, а переключение между ними требует изменения одного параметра. Confluent Platform получит те же возможности для локальных и гибридных инфраструктур.

Богатейший человек Индии теперь хочет сделать старые ПК пригодными для ИИ

Reliance Jio, принадлежащая Мукешу Амбани, открыла облачный сервис JioPC для всех пользователей интернета в Индии, независимо от оператора связи. Он запускает виртуальный компьютер из облака на уже имеющемся ПК и предоставляет до восьми виртуальных процессоров, 16 ГБ оперативной памяти и 1 ТБ хранилища. Jio утверждает, что так даже восьмилетние компьютеры смогут работать с современными приложениями на базе ИИ без замены оборудования. Подписка начинается от ₹1 000 за два месяца, годовой тариф стоит ₹4 000 или ₹5 000 в зависимости от конфигурации.

Adobe купила индийский стартап маркетинговой аналитики Rilo

Adobe приобрела индийский стартап маркетинговой аналитики Rilo. Сделка включает лицензирование технологий и переход команды, сообщили TechCrunch и сама Adobe. Это вторая покупка компании в Индии после приобретения видеоплатформы Rephrase.ai в 2023 году. Финансовые условия стороны не раскрыли. Rilo разрабатывал инструменты для автоматизации маркетинговых рабочих процессов: анализа конкурентов, переработки и распространения контента, разбора звонков отдела продаж и задач, связанных с продвижением бренда в ChatGPT, Gemini и Claude. Adobe заберёт интеллектуальную собственность стартапа и его команду из шести человек, а сам Rilo после сделки прекратит работу.

Почему сделка Nvidia по покупке Hugging Face — ставка на всю экосистему ИИ

Nvidia готовит приобретение Hugging Face примерно за $12,9 млрд, хотя финальное соглашение стороны пока не подписали. После доминирования в производстве GPU компания хочет усилить позиции на уровне приложений и получить доступ к крупнейшему хранилищу инструментов, библиотек и моделей с открытым исходным кодом. Сделка также защищает Nvidia от OpenAI, Google, Anthropic и DeepSeek, которые создают собственные чипы, чтобы снизить зависимость от её ускорителей. Отрасль движется к компаниям, контролирующим одновременно оборудование и программное обеспечение, а независимые стартапы рискуют потерять самостоятельность.

США возводят барьеры для дронов и роботов, но Китай обойдёт их масштабом

В июле и августе Вашингтон ужесточил ограничения на передовые роботизированные системы иностранного производства и ввёл высокие пошлины на импорт дронов и комплектующих, сославшись на национальную безопасность. Пошлины на дроны начнут действовать в сентябре, а на дополнительные компоненты — в 2027 году. Ограничения затрагивают отрасли, где китайские компании уже лидируют: в первой половине 2026 года пять крупнейших производителей гуманоидных роботов — AgiBot, Unitree, Galbot, UBTECH и Leju Robotics — обеспечили 86% мировых поставок. Аналитики считают, что меры США могут не разделить рынок на два лагеря, а ускорить формирование региональных рынков.

Реальность рушит хайп вокруг гуманоидных роботов

Компании, создающие гуманоидных роботов, обещают изменить рынок труда и уже привлекли сотни миллионов долларов при оценках в миллиарды. Agility Robotics рассчитывает поставить «сотни» роботов Digit в 2025 году, Tesla планирует выпустить 5 000 Optimus в 2025-м и не менее 50 000 в 2026-м, а Figure видит путь к 100 000 роботов к 2029 году. Аналитики Bank of America Global Research прогнозируют 18 000 поставок гуманоидов в 2025 году, а Morgan Stanley Research — свыше 1 млрд роботов и рынок объёмом $5 трлн к 2050-му. Но пока рынок почти гипотетический: главные препятствия для масштабирования — спрос, время работы от батареи, надёжность и безопасность.

Разработчики ИИ для роботов выходят из эпохи GPT-2

Компании, разрабатывающие ИИ для роботов, пока не смогли превратить растущие физические способности машин в стабильную коммерческую работу. На конференции Actuate разработчики говорили, что сектору не хватает качественных данных, вычислительных ресурсов и более эффективного обучения с подкреплением. Основатель Antioch Гарри Меллсоп сравнил нынешний этап с эпохой GPT-2. На этом фоне Unitree после выхода на китайскую площадку, аналогичную Nasdaq, достигла оценки $66 млрд, но на этой неделе потеряла почти половину стоимости.

Какие навыки работы с ИИ работодатели действительно ищут в 2026 году

Рынок вакансий в сфере ИИ развивается не так, как ожидалось: отдельные должности вроде инженера по составлению запросов к ИИ появляются редко, зато компании ищут маркетологов, инженеров, менеджеров проектов и аналитиков, умеющих применять ИИ в своей работе. Навыки составления запросов востребованы: в 2025 году их указывали в 22 227 вакансиях в США против 6 152 годом ранее. Быстрее всего растёт спрос на навыки работы с ИИ-агентами, а машинное обучение остаётся главным техническим требованием. Владение чат-ботами становится базовым навыком, тогда как этика и управление ИИ пока почти не влияют на найм.

ИИ-агентов научили управлять памятью во время долгих задач

Когда ИИ-агент долго решает задачу, он легко тонет в собственных заметках и начинает путаться в том, что было важным. Исследователи предлагают дать агенту более человеческий способ работы с памятью: не тащить всё перед собой, а самому решать, что можно свернуть, убрать во внешнее хранилище и потом вернуть по мере надобности. Так он меньше захлёбывается в лишних деталях, дольше держит ход мысли и стабильнее доводит сложные задачи до конца. В этом обзоре разбираем, как ИИ-агента научили управлять своей памятью во время длинной работы и почему это помогает ему лучше искать решения и писать код.

Ваша LLM умнее, чем кажется — вы просто используете ее неправильно

Когда важен не только мозг, но и «обвязка» вокруг него. Как Meta-Harness автоматизирует создание harness для LLM. В разговорах об ИИ мы почти всегда обсуждаем сами LLM: размер, качество данных, архитектуру и скорость. Но в реальных приложениях на итоговую полезность влияет ещё один слой — harness. Это кодовая «обвязка» вокруг модели, которая…

Как LLM помогают дата инженерам наводить порядок в «грязных» данных

В компаниях есть одна общая проблема: данные в таблицах и базах устроены так, что ими сложно пользоваться. Форматы скачут, значения противоречат друг другу, части полей пустые, а разные источники называют одно и то же разными словами. В итоге аналитики тратят недели на подготовку датасетов, а…

Аналитика без SQL и отчётов: как продавцы в Amazon получают инсайты напрямую из данных

В e-commerce продавцу постоянно приходится принимать решения на лету: что поднять в рекламе, где просели продажи, какие товары тянут бизнес вниз, а какие — дают рост. При этом данных вокруг много, но польза от них не всегда очевидна. Чтобы получить ответ, нужно открыть несколько инструментов,…

DataFlow: PyTorch для дата инженеров в эпоху LLM

Сложность обучения языковых моделей сейчас не столько в новых архитектурах, сколько в качестве данных. Их не всегда можно просто собрать, почистить и обучить нейросеть — нужно придумывать процессы, где данные можно синтезировать, валидировать, улучшать, выбрасывать плохие и возвращаться назад на…

Как ИИ-агенты научились писать аналитические отчёты не хуже профессиональных аналитиков

Финансовый отчёт — это не просто текст: его сила в проверяемых цифрах и понятных графиках со ссылками на источники. LLM хороши в написании текстов, но склонны к галлюцинациям. Команда FinSight решила эту проблему с помощью отдельной группы агентов, отвечающих за сбор данных и проверку расчетов,…

Эпоха автономных аналитиков: как ИИ меняет науку о данных

Автономная наука о данных — давняя мечта: от сырых таблиц и файлов до аккуратных графиков и связного аналитического отчета без постоянного участия человека. Большие языковые модели (LLM) продвинули нас вперед, но типичные workflow-агенты живут за счет заранее прописанных правил. Они хрупки:…

Что, если новые бенчмарки для ИИ станут появляться сами по себе?

Когда мы говорим о проверке возможностей ИИ в инженерии машинного обучения, чаще всего всплывают статичные бенчмарки: однажды собранные организаторами конкурсы, единый датасет, фиксированная метрика. Это удобно, но плохо масштабируется. Каждую задачу приходится долго выверять, приводить к общему…

Графики по щелчку: как ИИ-агенты берут на себя работу дата-аналитика

Перевести обычный запрос на человеческом языке в корректный график — задача не такая простая, как кажется. Данные большие и разнородные, код нередко падает, а хороший график почти всегда требует нескольких итераций правок. Исследователи из Google предлагают смотреть на задачу не как на…

Увидел-указал-полетел: как управлять автономными дронами без обучения с нуля

Навигация по текстовым инструкциям — давний вызов для автономных дронов. Традиционные алгоритмы на основе обучения с подкреплением требуют больших датасетов и плохо переносятся на новые домены. Недавняя волна решений на базе визуально-языковых моделей обещала универсальность, но часто просила…

Репозитории на автопилоте: как ИИ сам поднимает окружение и запускает код

Открытые репозитории полны готовых решений: скрипты, модели, датасеты, демо. Но чтобы собрать всё и запустить, нужен ручной труд: поставить зависимости, скачать артефакты, прочесть документацию, не ошибиться со вступными параметрами. EnvX предлагает простой, но мощный подход: агентировать…

Почему Text-to-SQL до сих пор ломается и как это исправить

Превратить вопрос человека в корректный SQL — задача на удивление непростая. Большие языковые модели хорошо пишут валидный синтаксис, но легко промахиваются в логике: путают таблицы, соединяют не тем ключом, забывают GROUP BY, ставят неправильные фильтры. Простая самокоррекция по факту…

Нажал — и мир двинулся: Matrix-Game 2.0 делает видео интерактивным в реальном времени

Интерактивные модели мира — это способ учить ИИ «ощущать» мир, а не только описывать его словами. Но до недавнего времени у таких моделей было три больших препятствия: не хватало качественных данных с точной пометкой действий; классические видеодиффузоры считали слишком долго и «забывали» начало…