
Результаты на ARC-AGI
В тестировании через Provider Adapter Harness, который использует специфичные для поставщика функции — сохранение рассуждений и уплотнение контекста, — Gemini 4 Argon набрала 97,5% на ARC-AGI-3. По данным ARC Prize, Google стала второй лабораторией после OpenAI, преодолевшей отметку 95% на бенчмарке, который считают одним из самых трудных для проверки общего решения задач. Выше результат только у GPT-6 Astra — 99,9%.
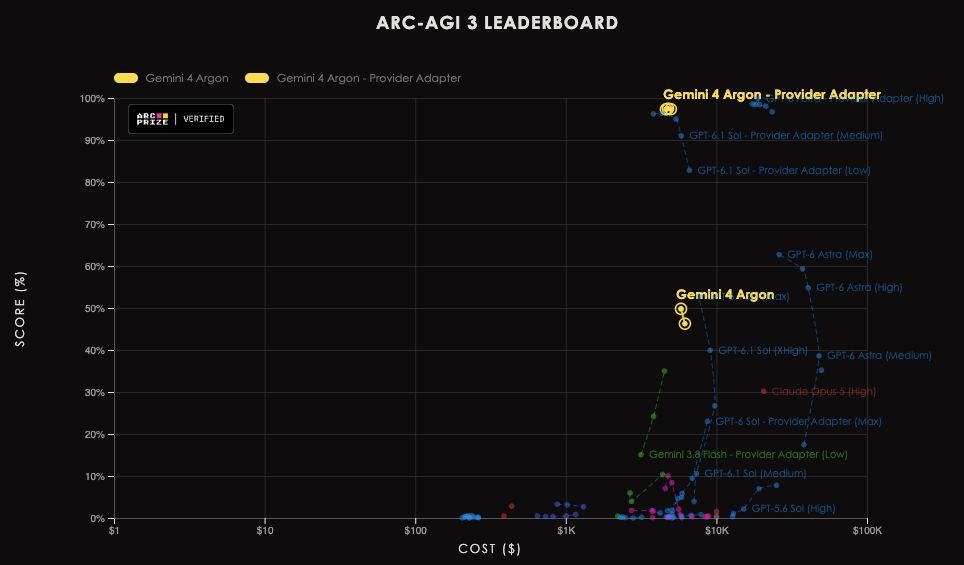
В 25 общедоступных играх ARC-AGI-3 Gemini 4 Argon (жёлтый) и GPT-6 Astra (синий) оба потратили на 62 процента меньше ходов, чем базовый показатель человека (фиолетовый), и часто приближались к рекорду скоростного прохождения (красный)
Источник: the-decoder.com
Как и Astra, Argon использовала на 62% меньше действий, чем человек, в 25 открытых играх. В трёх играх модель сравнялась с рекордом скоростного прохождения или превзошла его, а ещё в шести показала время не более чем на 10% хуже лучшего.
На предыдущих версиях бенчмарка Argon набрала 91,3% в ARC-AGI-2 при цене $0,32 за задачу и 98,5% в ARC-AGI-1 при цене $0,16 за задачу. Расчёт основан на начальной цене: $2 за миллион входных токенов и $10 за миллион выходных.
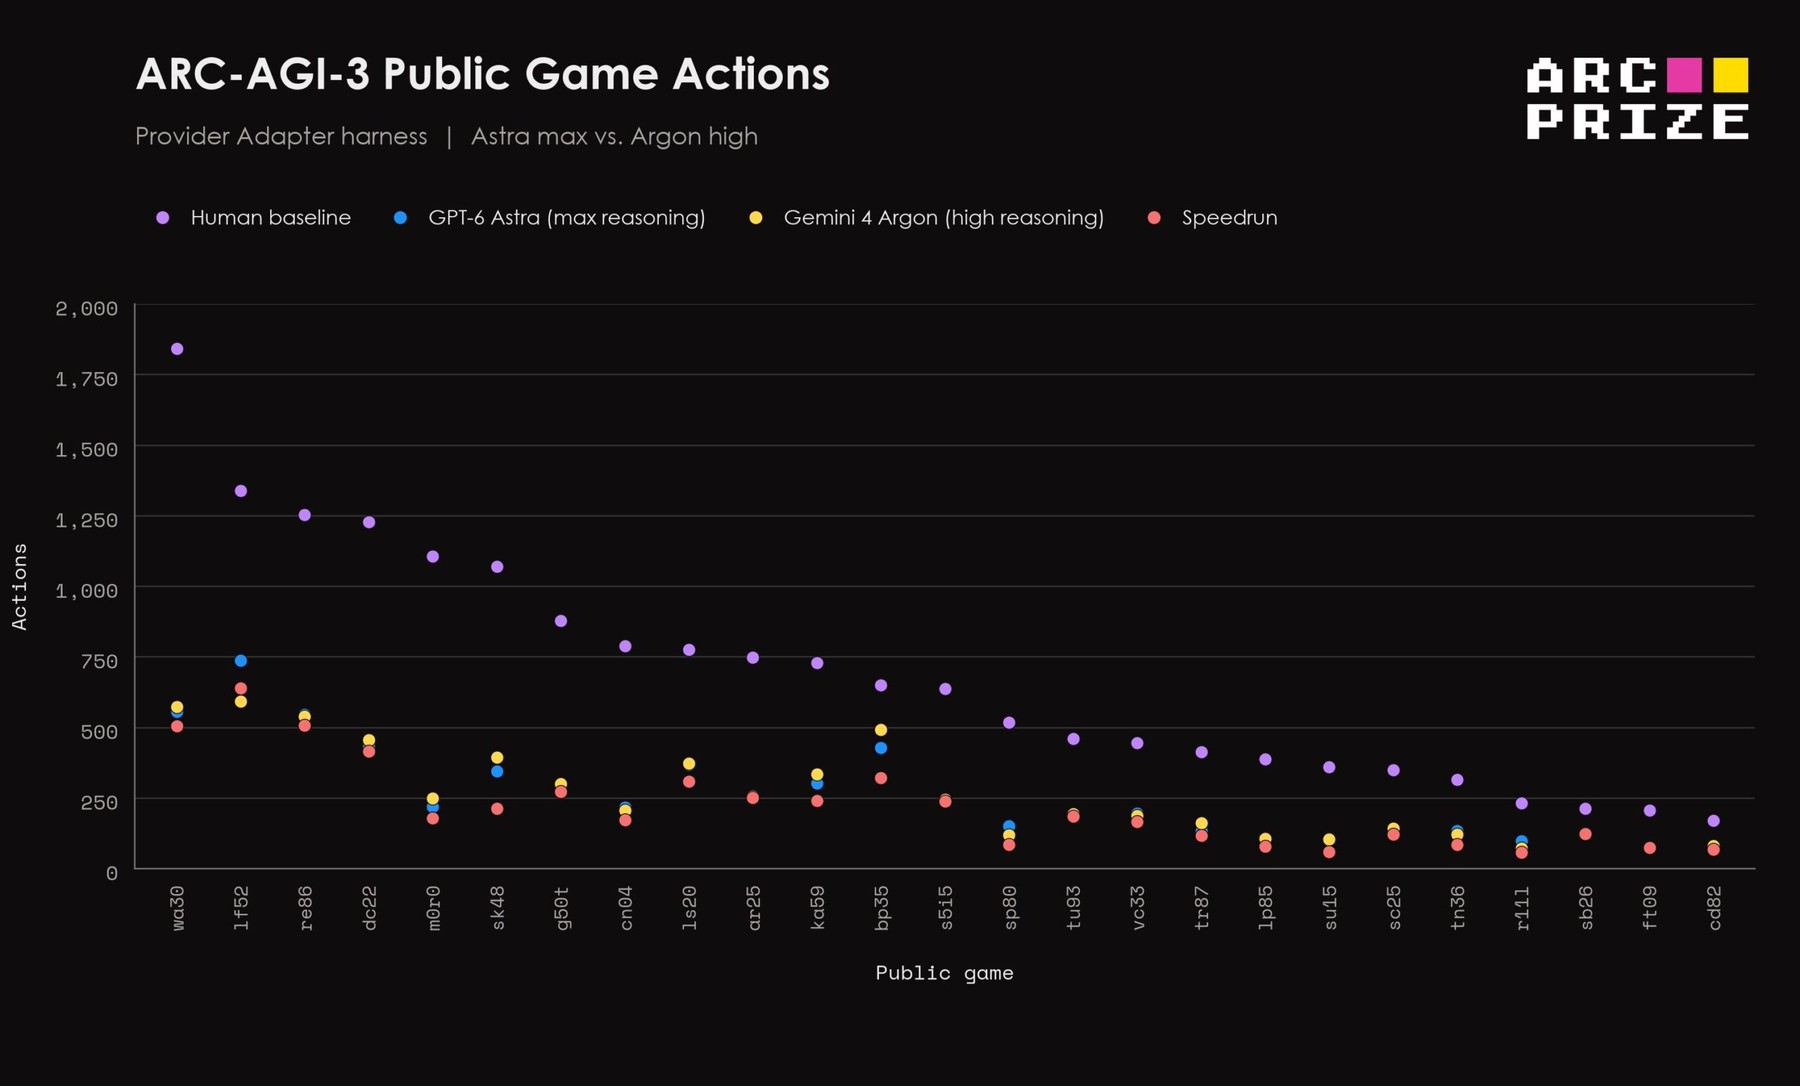
В 25 общедоступных играх ARC-AGI-3 Gemini 4 Argon (жёлтый) и GPT-6 Astra (синий) оба потребовали на 62 процента меньше ходов, чем базовый показатель человека (фиолетовый), и часто приближались к рекорду скоростного прохождения (красный)
Источник: the-decoder.com
Результаты зависят от условий тестирования
В стандартном режиме Standard Harness, где между раундами разрешены только простые заметки, результат Argon при низком уровне рассуждений падает до 49,8%. Такое тестирование обошлось в $5 800. Разница связана с дискуссией, начавшейся в июле 2026 года: тогда GPT-5.6 Sol от OpenAI обошла Claude Opus 5 в ARC-AGI-3 при использовании двух настроек API.
В стандартной среде GPT-5.6 Sol набрала лишь 7,8%. После каждого действия система теряла внутренние рассуждения, а тестирование шло через старый интерфейс без новых функций API Claude. Поэтому Claude и GPT-5.6 проверяли в разных условиях.
Когда модель тестировали через Responses API самой OpenAI с функциями Retained рассуждение и интеллектуального уплотнения контекста Compaction, её результат вырос до 38,3%. Это оказалось выше, чем у Opus 5, — 30,2%. OpenAI заявила, что бенчмарки неизбежно проверяют и техническую среду. После этого сооснователь ARC Prize Франсуа Шолле разрешил использовать общие настройки API, доступные всем.
По словам тестировщиков, проблемы с API помешали Argon завершить все 55 игр в Standard Harness. При низком уровне рассуждений система прошла 42 игры и набрала 49,8%, при среднем — 46 игр и 46,3%. На максимальном уровне она завершила только 19 игр, поэтому ARC Prize не опубликовала результат. При этом опубликованные показатели охватывают все 55 игр: в них учтены и частичные баллы за прерванные попытки.
Argon приблизилась к лидерам, но уступает в математике и программировании
За прогресс Google следил и исследовательский институт Epoch AI. Argon набрала 165 баллов по Epoch Capabilities Index (ECI), сравнявшись с Fable 5.1. Чуть выше оказались Opus 5.5 с 167 баллами и GPT-6 Astra со 166. ECI объединяет более 50 бенчмарков в единую шкалу способностей — похожим образом Artificial Analysis рассчитывает свой основной показатель.
Argon заметно опережает Gemini 3.8 Flash, получившую 157 баллов, и приближает Google к лидерам сильнее, чем любая модель компании со времени Gemini 3.1 Pro в феврале. Ранее такую тенденцию отмечали Artificial Analysis и Vals.ai.
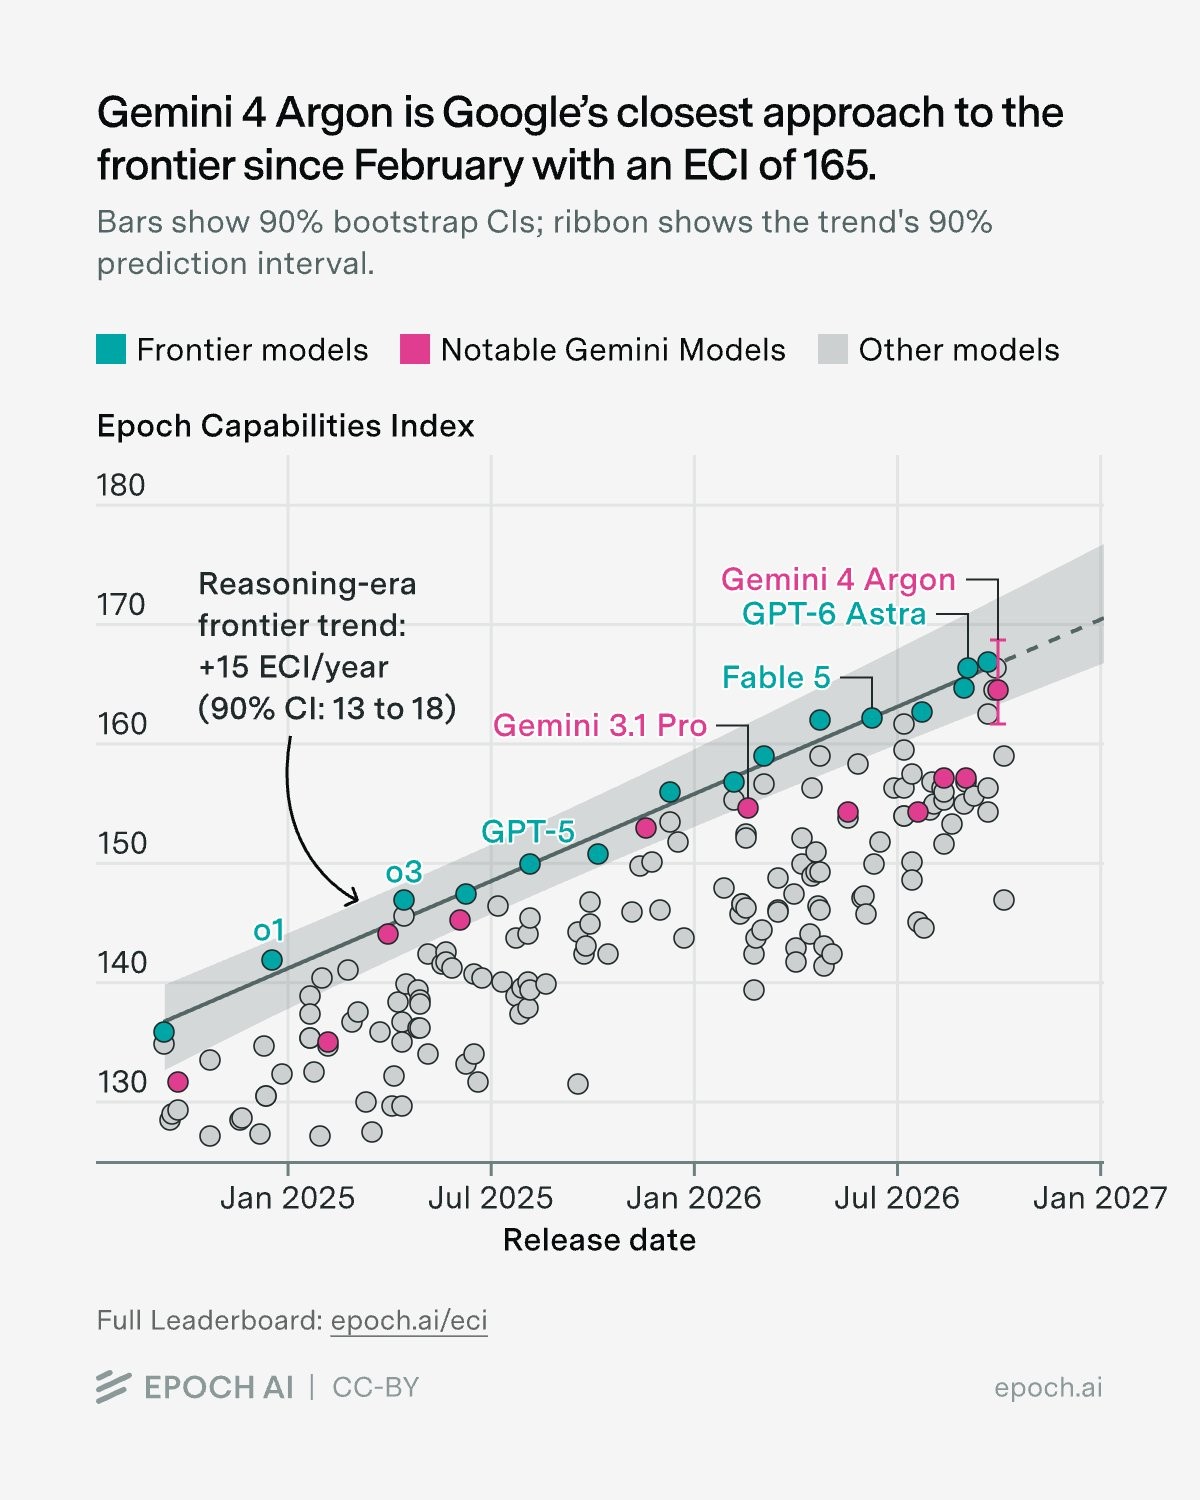
С результатом ECI в 165 баллов Google ближе к нынешнему передовому рубежу ИИ, который задают GPT-6 Astra (166) и Opus 5.5 (167), чем когда-либо со времён Gemini 3.1 Pro в феврале 2026 года
Источник: the-decoder.com
Показатели Argon различаются по направлениям. По оценкам Epoch AI, модель лидирует в нескольких бенчмарках на знания, работу ИИ-агентов и зрение. Однако предварительные оценки ставят её на восьмое место по Math ECI и на шестое — по индексу разработки программного обеспечения (SWE ECI).
Читайте также
 Интерпретируемость ИИ близка к прорыву? Новое эссе разделило исследователей
 Глава Replit: будущее работы — «самоуправляемая компания»
 Reflection хочет потеснить китайские открытые модели не дешевизной токенов, а их меньшим числом
 Эксперты по ИИ уже готовятся к концу света, если ИИ выведет из строя всю финансовую систему
 tokenizers v1: измерили скорость кодирования, декодирования и масштабирования
 ИИ-девушки воруют шутки у комиков, чтобы набрать просмотры на возбуждающих роликах
 ИИ угрожает демократии. Но мы не бессильны: вот как дать отпор
 Вирусный успех Cal AI обеспечила целая армия инфлюенсеров — и это окупилось
 Google хочет, чтобы роботам хватало одной модели ИИ — Gemini 4 Argon
 GPT-6-Astra решает 49 из 50 задач по физике за $2,40 за каждую
 Жители отвергают выплату по $10 000 за согласие разместить в их посёлке дата-центр
 Bluesky расширила возможности приложения Attie на базе ИИ: теперь в нём каждый может создавать сайты, игры и не только
 Muse Spark Open — ответ Meta на Qwen, GLM и Kimi в гонке открытых моделей с весами
 Bank of America направил 4 тысячи человек устранять уязвимости, найденные Mythos от Anthropic и другими ИИ-моделями
 Anthropic рассказала о независимых оценщиках
 FLUX 3 Image Klein от Black Forest Labs работает на видеокартах для обычных ПК с 8 ГБ видеопамяти
 Google запустила в США инструмент для покупок Universal Cart
 Arcade.dev: новая система подбора инструментов снижает расходы компаний на входные токены на 37%
 Magnetar подтверждает корректность программ для вычислений общего назначения с помощью доказательств
 ИИ-агенты появятся в автомобилях Rivian
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram