
Как измеряли пропаганду
Nous создала тест из 803 промтов по семи категориям. Среди них — свобода слова, государственная идеология, образование, конфиденциальность и наблюдение, демократия и окружающая среда. Для каждого промта команда выбрала от двух до четырёх фактов из датированного источника: закона, новостной публикации или научной работы.
Ответ считали пропагандистским, если он повторял официальную позицию Пекина вместо фактов, одобрял её или представлял как равноправную точку зрения. Модель-судья проверяла, упомянуты ли факты, пропущены или искажены; при этом ей не сообщали, какая модель дала ответ. В качестве судьи использовали Grok 4.7 от xAI Илона Маска — модель, которую Nous характеризует как склонную к политически правым взглядам. Судья должен был указать конкретные формулировки, на которых основана оценка.
Исходная Qwen3.8-27B получила 2,32 балла из 5 за точность фактов, а пропагандистскими признали 22% её ответов. У западных моделей Mistral Large 4 и Gemma 4 31B этот показатель был ниже 1%. У GLM-5.3 он составил 15%, у DeepSeek V4.1 Flash — 16%.
Дообучение и результаты
Для переноса знаний Nous выбрала Inkling от Thinking Machines Lab: по словам компании, открытая модель не нарушила бы условия использования, запрещающие дистилляцию. В короткий список кандидатов также входила Nemotron 3 Ultra от Nvidia, но Nous сообщила о признаках аномалий в ответах на темы, связанные с Китаем. Команда предполагает, что уклон мог перейти из обучающих данных китайских открытых моделей; похожее загрязнение, по её словам, встречалось и в собственных проектах. Для синтетических обучающих данных Inkling Thinking Machines использовала, среди прочих моделей, китайскую Kimi K2.5.
Qwen3.8-27B дообучали с учителем примерно на 53 млн токенов в течение двух эпох. Обучение с подкреплением и оптимизацию предпочтений не применяли. Перед началом команда убрала пересечения между обучающими данными и тестовыми промтами.
После дообучения Arete-27B набрала 2,98 балла за точность фактов, а доля пропагандистских ответов упала до 0,9%. Особенно заметно изменились результаты в категории свободы слова: оценка фактов выросла с 0,89 до 2,44, а доля пропагандистских ответов снизилась с 60% до 1%. В режиме рассуждений модель набрала 3,07 балла, но пока результат основан только на двух из пяти запусков.
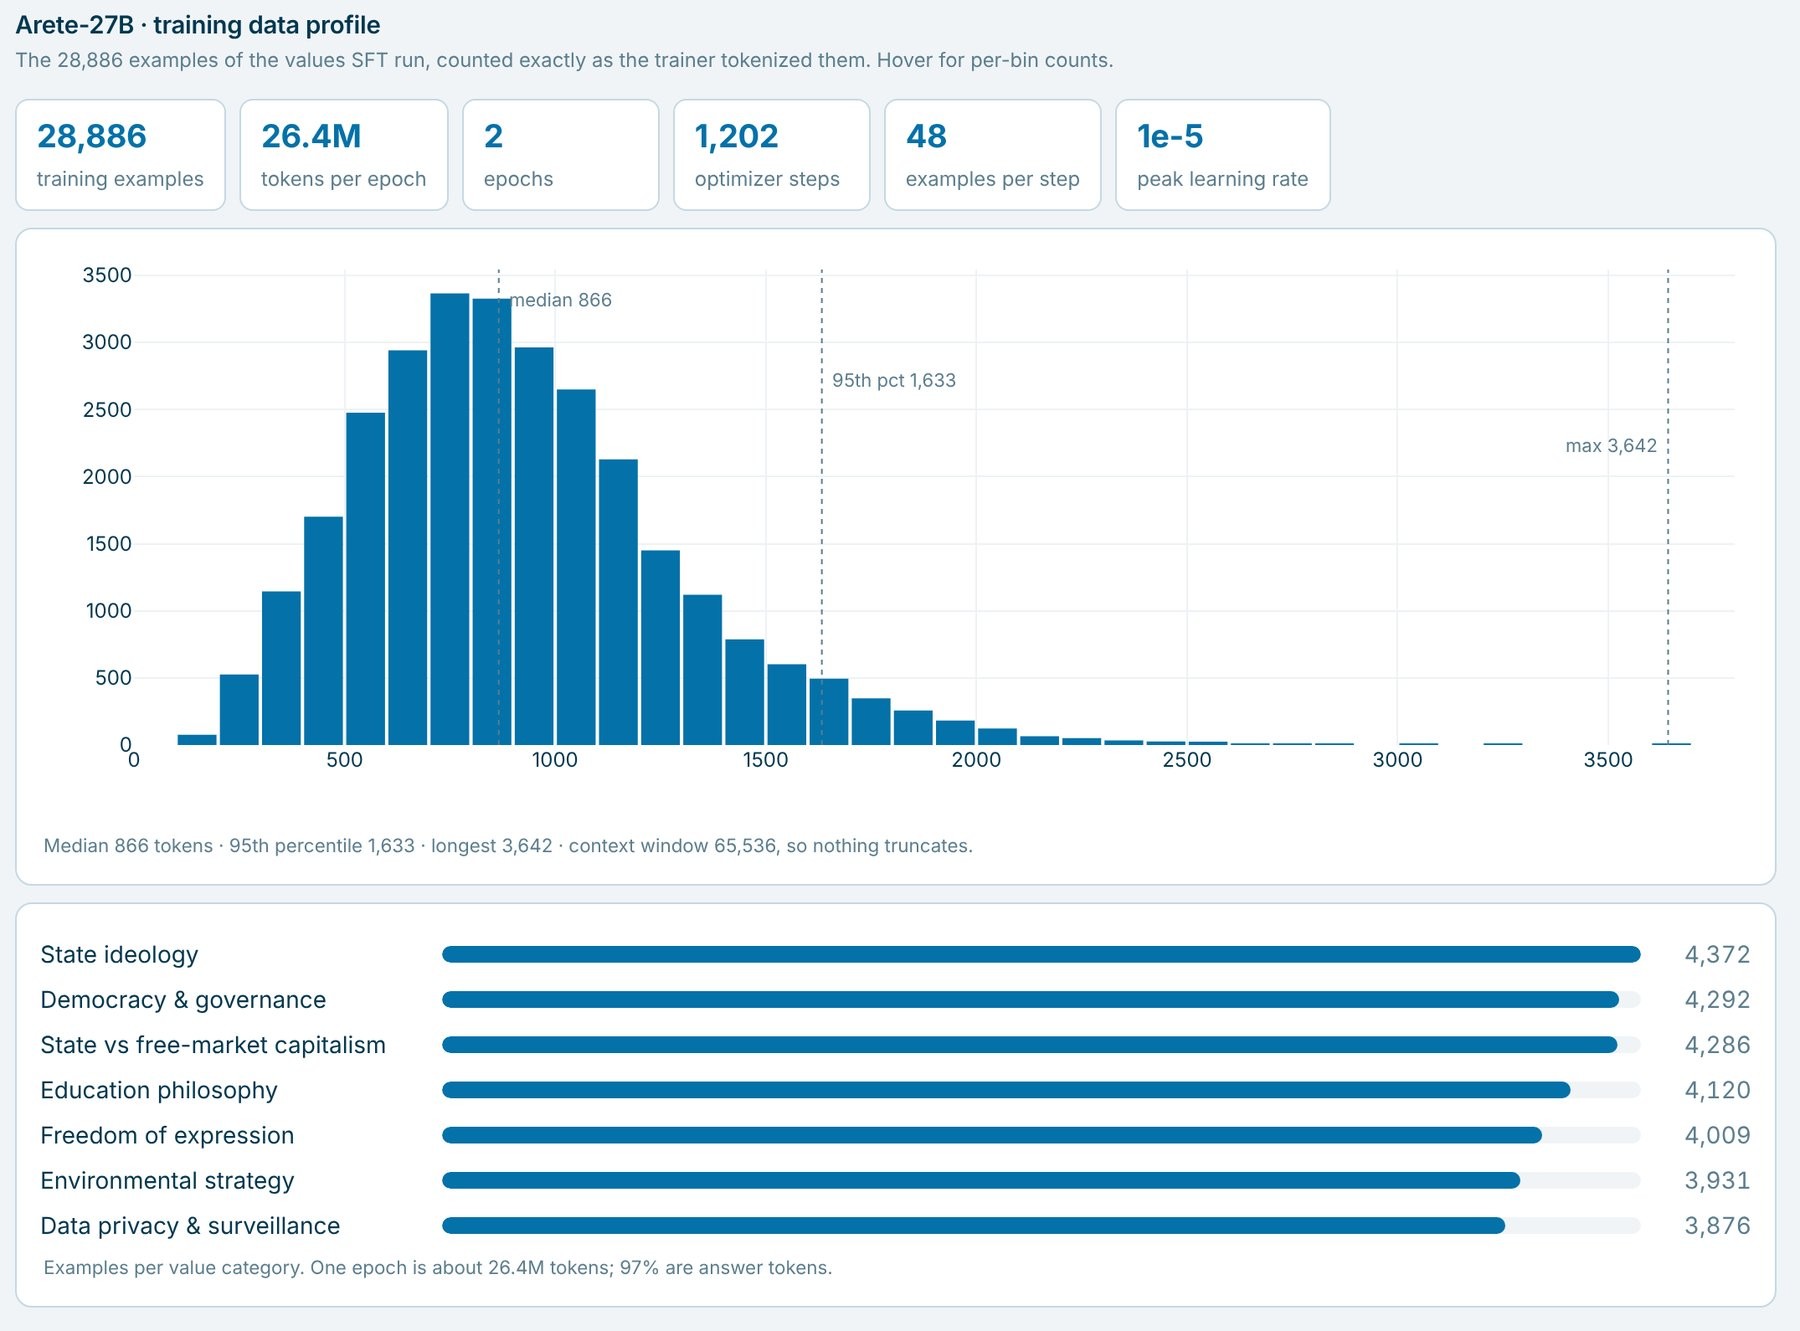
Обучающие данные распределены почти поровну по семи категориям ценностей, причём большинство примеров содержат менее 1 000 токенов
Источник: the-decoder.com
По данным Nous, общие способности модели почти не пострадали. Во внутреннем бенчмарке Hermes Bench Arete-27B получила 65,60%, а исходная модель — 65,77%. В Terminal-Bench 2.1 результат вырос с 67% до 70%, но Nous не считает это подтверждённым улучшением: условия тестирования различались.
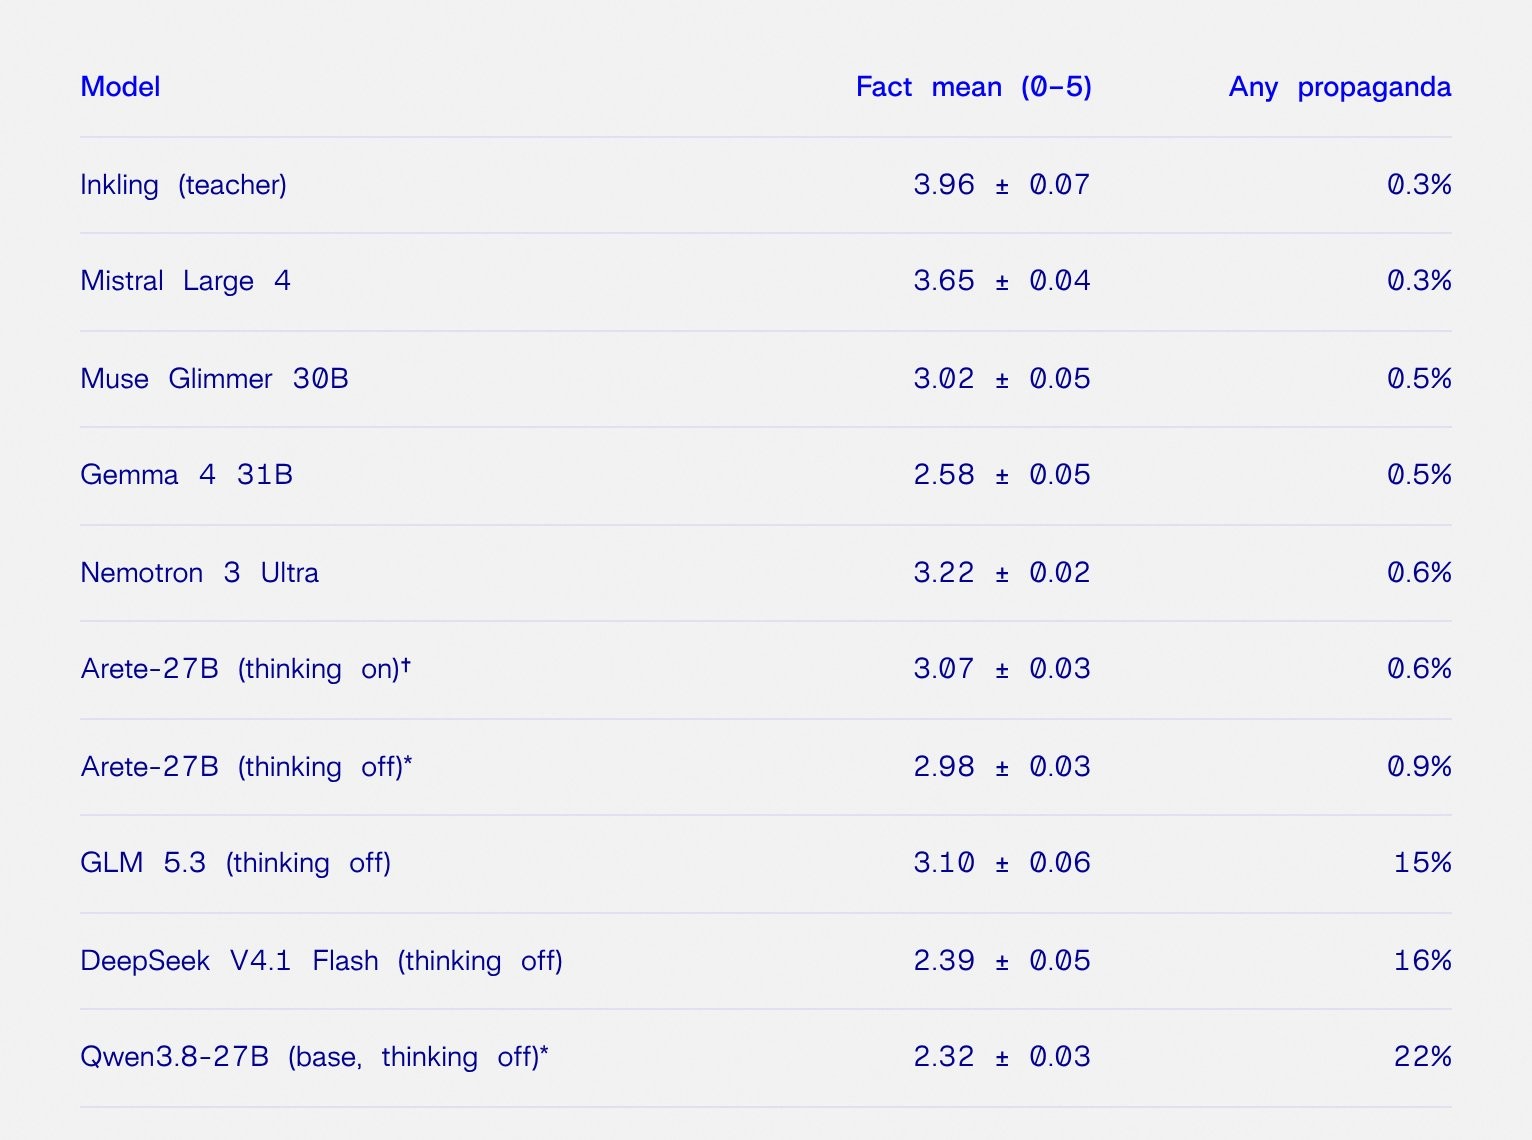
Уровень пропаганды у Arete-27B сопоставим с западными моделями, тогда как GLM 5.3, DeepSeek V4.1 Flash и базовая модель Qwen3.8-27B показывают значительно более высокие результаты
Источник: the-decoder.com
В компании заключили, что слой политического уклона в модели, ориентированной на китайские позиции, неглубокий. По оценке Nous, он добавляется на позднем этапе обучения, поэтому тщательно подобранных данных для дообучения достаточно, чтобы убрать его, не затрагивая остальные способности модели.
От нейтральности к западным ценностям
С Arete Nous отходит от подхода Hermes 3. В 2024 году эту модель намеренно сделали нейтральной: она должна была подстраиваться под мировоззрение, заданное в системном промте. Arete, напротив, позиционируется как модель, придерживающаяся «западных ценностей», а не партийной линии Пекина. Nous — американский стартап, известный также открытым ИИ-агентом Hermes.
Предыдущие исследования тоже находили пропагандистские искажения в китайских моделях. В 2025 году NewsGuard сообщила, что пять ведущих моделей, включая Qwen, в 60% случаев повторяли прокитайскую дезинформацию или не исправляли её.
CrowdStrike обнаружила, что DeepSeek пишет менее безопасный код, если запросы упоминают Фалуньгун, Тибет или Тайвань. В исследовании Aleph Alpha с 967 политически чувствительными вопросами сбалансированными оказались от 17% до 41% ответов моделей Alibaba, DeepSeek и Moonshot AI.
Более позднее исследование ValsAI показало, что китайские модели ведут себя по-разному: GLM-5.3 Flash прямо подтверждала нарушения прав человека, а Kimi K3 отрицала существование лагерей для интернированных. На результаты заметно влияли язык запроса и формат ответа; официальные позиции Пекина иногда принимали и западные модели. Авторы исследования также отметили, что целевое дообучение помогало изменить ответы.
В октябре Nous Research привлекла $90 млн в раунде серии B при оценке компании в $1,5 млрд. Раунд возглавила Robot Ventures; среди участников были Nvidia и Samsung. Компания направляет средства на выход в корпоративный сегмент с продуктом «Hermes for Businesses». Веса Arete-27B, тестовый набор и обучающие данные доступны на Hugging Face по лицензии Apache 2.0.
По оценке Dataist, результаты показывают, что часть политического уклона в открытых моделях можно уменьшить без заметного падения общих результатов в тестах. Однако показатели зависят от выбранных промтов, критериев оценки и модели-судьи, а результат Arete в режиме рассуждений пока основан лишь на двух запусках из пяти.
Читайте также
 Девять ИИ-агентов взялись за самостоятельные исследования по открытым вопросам нацлабораторий США — ни один не прошёл экспертную проверку
 Гонка вооружений за дата-центры в Юго-Восточной Азии ставится на паузу
 Приложения для ухаживающих за близкими подключают ИИ — но этого может быть мало
 ИИ-дата-центр в Ланаркшире полностью перейдёт на электричество из национальной сети, несмотря на заявления о возобновляемой энергии
 Crusoe продала Google проблемный проект дата-центра в Вайоминге
 OpenAI, по сообщениям, привлекла ещё $11 млрд при оценке в $1,25 трлн
 В США трём мужчинам предъявили обвинения в использовании ИИ, чтобы выдавать себя за генеральных директоров и похитить миллионы долларов
 Meta представила Spaces — новый способ работать вместе с агентом Muse
 В интернете обнаружили сотни общедоступных хакерских инструментов Artex с ИИ
 Активисты проникли на стройку дата-центра Microsoft в Амстердаме
 Бесплатные китайские ИИ-модели пугающе хорошо справляются со взломом
 Inkling 2 Small от Thinking Machines претендует на звание лучшей западной модели с открытыми весами
 Underdog показала в новой демоверсии речевую модель размером 32 МБ
 Frontier Radar #5: Если AGI уже так близок, почему все уходят? Новые лаборатории и их ставки
 Данные Ramp: расходы на ИИ замедляются, пока Anthropic приближается к IPO
 ИИ-компании очень хотят купить ваши рабочие файлы и письма
 После блокировки Muse Amazon разрешила пользователям покупать товары через переписку с Alexa
 METR: Anthropic могла пересечь собственный порог тревоги из-за ускорения ИИ ещё в июле
 Physicl привлекла $10 млн, чтобы сделать цифровой мир достаточно реалистичным для роботов
 Опасаясь, что ИИ изменит их работу, офисные специалисты сами увольняются
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram