Игровые миры можно превратить в проверяемые учебные задачи, а прохождение этих задач — в данные для обучения зрительных ИИ-агентов. В Game2Player игры проверяют сами игроки: их ошибки помогают исправлять среду, а каждое действие связывается с измеримым прогрессом. Обученная на таких данных модель чаще продвигается к цели даже в незнакомых играх.
Главная мысль
Чтобы учить ИИ играть, нужны не просто видео, а записи с понятной целью, действиями и достоверной оценкой результата. Game2Player автоматически готовит такие данные из веб-игр и использует прогресс в игре, чтобы выделять полезные действия.
🟠 Сборщик адаптирует игру и задаёт задачи, чей прогресс и успех измеряются по внутреннему состоянию игры.
🟠 Два игрока тестируют среду разными способами и сообщают о проблемах.
🟠 Исправленные игры дают траектории — последовательности экранов, действий и оценок прогресса.
🟠 Обучение сильнее учитывает действия, после которых игрок продвинулся к цели.
Что такое Game2Player
Game2Player — это пайплайн из поиска игр, их адаптации и проверки, сбора игровых записей и обучения модели. Среда и игроки дорабатывают друг друга: игроки находят ошибки, которые не заметил сборщик, а сборщик проверяет их сообщения по записи прохождения.
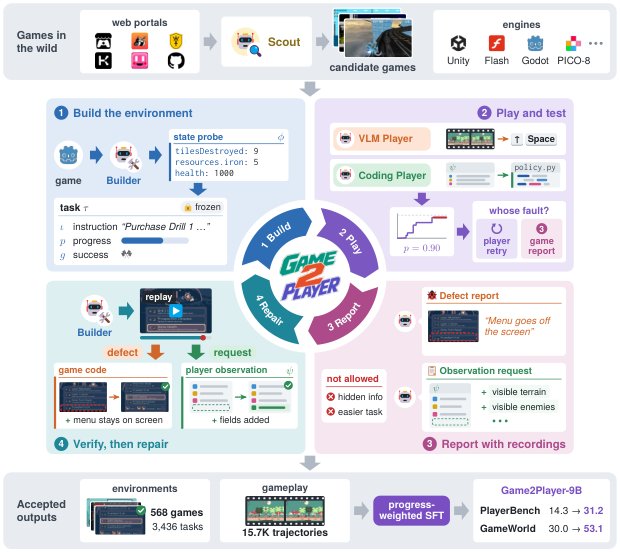
Game2Player подготавливает игру, проверяет её двумя игроками, исправляет найденные проблемы и собирает данные для обучения.
🟠 Искатель отбирает игры, которые можно запускать офлайн в браузере, проходить в одиночку и надёжно перезапускать.
🟠 Сборщик упаковывает игру в воспроизводимую среду, задаёт начальные условия и создаёт задачи. Для каждой он определяет, как измерять промежуточный прогресс и что считать успехом.
🟠 Игрок с изображениями видит снимок экрана и выбирает действие, после чего игра останавливается до следующего решения. Он играет в режиме, близком к тому, как будет действовать обученная модель.
🟠 Игрок с программой пишет отдельную программу для каждой игры. Она читает доступные игроку сведения о видимых объектах и действует в реальном времени без вызова модели на каждом шаге.
🟠 Проверка сообщений: игроки сообщают о неисправных кнопках, неверной оценке прогресса или нехватке наблюдаемых данных. Сборщик сверяет жалобы с видеозаписью и состоянием игры, затем исправляет подтверждённые проблемы.
🟠 Отбор данных повышает вес действий, за которыми последовал заметный прогресс, и снижает вес повторов и финальных шагов неудачных попыток.
Как это работает: задача в веб-игре
Представим задачу, где нужно доставить железо и купить бур первого уровня. Система должна записать нажатия и отличить движение к цели от бесцельной игры.
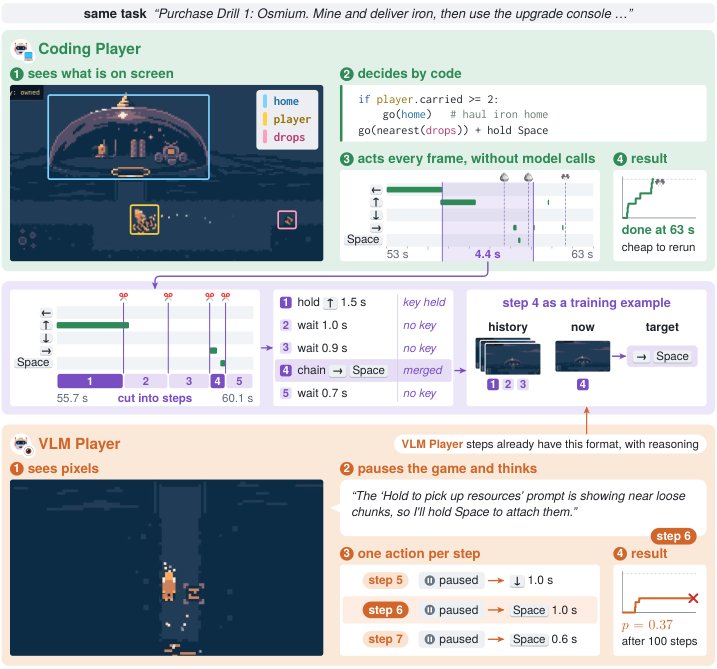
Игрок с программой действует по наблюдаемым данным в реальном времени, а игрок с изображениями выбирает действие по снимку экрана; их записи приводятся к общему формату.
Сначала сборщик находит в коде игры данные о запасе железа и покупке бура. По этим данным он задаёт шкалу прогресса: каждое доставленное железо увеличивает оценку, а покупка бура означает успех. Оценка опирается на состояние игры, а не на мнение другой модели.
Затем игроки пытаются выполнить задачу. Игрок с изображениями видит экран, читает описание управления и выбирает действие, например нажимает клавишу движения. Игрок с программой получает сведения о видимых объектах и может точнее рассчитывать, когда нажать или отпустить клавишу.
Если железо доставлено, но оценка прогресса не меняется, игрок сообщает о возможной ошибке. Сборщик пересматривает запись и проверяет, правильно ли он связал показатель прогресса с игровым событием. Если проверка подтверждает проблему, он исправляет измерение, после чего игроки проходят задачу повторно. Здесь возможны сбои: сообщение может быть ошибочным, игровое состояние — прочитано неверно, а сама задача — оказаться невыполнимой. Поэтому сборщик должен подтвердить каждую жалобу и проверить результат исправления.
Когда среда принята, прохождения превращаются в обучающие примеры. Система связывает каждый экран и предшествующую историю с нужным действием. Примеры, после которых прогресс вырос, чаще попадают в обучение; бесполезные повторы получают меньший вес. Так модель учится выбирать действия, которые помогают двигаться к задаче.
Как проверяют результаты
Авторы проверяют качество игровых сред и пользу собранных данных. Для первого теста они сравнивают полный цикл с вариантом без сообщений игроков и с обычным агентом для программирования, у которого нет специальных инструментов. Задачи заранее зафиксированы, а правильность среды проверяется сверкой с исходной игрой; проверку оценок дополнительно просматривают люди.
Для оценки обученной модели используют два бенчмарка: Player Bench из 50 игр, отложенных от обучения, и внешний GameWorld из 34 игр, которых нет в обучающей коллекции. В каждом измеряют прогресс — среднюю долю пути к цели, и успех — долю полностью выполненных задач. Игры в обучающей выборке не пересекаются с Player Bench; GameWorld тоже не пересекается с коллекцией.
Сравнение включает исходные модели, обученные Game2Player модели и другие зрительные модели. Участникам и моделям дают описания задач и управления, а попытки ограничивают одинаковым пределом в 100 шагов. Есть оговорка: модели останавливают игру на время каждого решения, поэтому тест не проверяет, как они справятся с задержками в реальном времени.
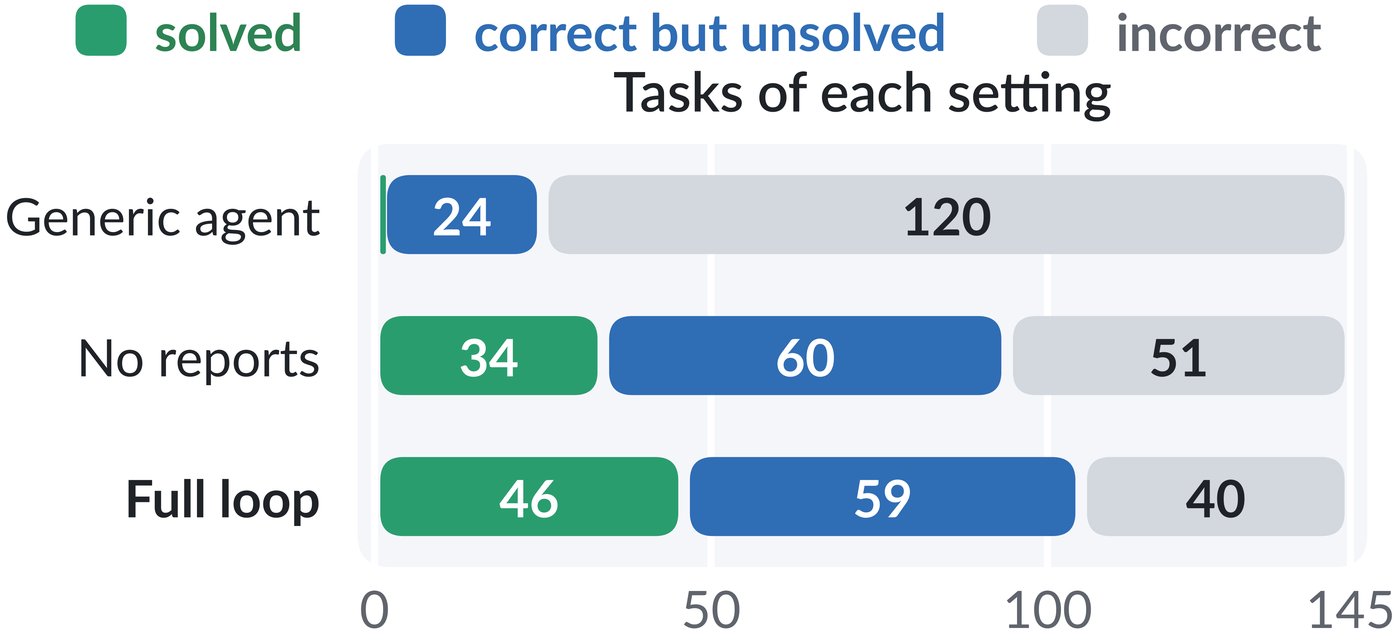
В исследовании на 20 играх сообщения игроков повысили число правильно реализованных задач и задач, которые удалось пройти.
Цифры
Модель заметно улучшилась на обеих проверках, в том числе на играх, которых не было в обучающем наборе. В отдельном испытании на 20 играх сообщения игроков повысили долю правильно реализованных задач с 65% до 72%, а число задач, решённых программами-игроками, — с 34 до 46. Совместная проверка помогает собирать больше записей и исправлять условия, на которых они основаны.
Вывод
Game2Player автоматизирует сбор игровых данных с проверяемыми целями: программу-игрока можно запускать много раз без отдельных вызовов модели на каждом шаге, а игрок с изображениями добавляет примеры решений, близких к восприятию будущей модели. Веса по прогрессу помогают модели учиться на действиях, которые действительно продвигают задачу.
Проверка не гарантирует, что каждая среда безошибочна: в исследовании часть задач после сборки оказалась реализована неверно. Набор ограничен одиночными играми, которые запускаются офлайн в браузере; онлайн-игры, многопользовательские режимы и крупные коммерческие проекты не охвачены. Кроме того, модели помогают собирать игровые миры и проверять жалобы, а их отдельные версии со временем меняются.
Пока результаты показывают, что такой подход полезен для обучения и тестирования зрительных агентов в играх. Следующий шаг — выяснить, сохранится ли эффект в более сложных средах, где решения приходится принимать без остановки игры и учитывать реальное время.
Читайте также
 Как научить ИИ-агента разработать приложение с нуля
 Какой ИИ выбрать для медицинских задач
 Почему ИИ-агенту трудно действовать в реальном мире
 Как отличить генерацию видео от симуляции мира
 Как ИИ может усилить интеллект конкретного человека
 Проверим, способны ли ИИ-агенты делать открытия в физике
 Как ИИ выбирает подходящую модель для каждой задачи
 Как управлять роботом с помощью небольшой ИИ-модели
 Сотни тысяч профессиональных задач помогли обучить ИИ-агентов
 Как ИИ-агенты учатся общим навыкам на разных задачах
 Как понять, что ИИ-агент выполняет задачу неправильно
 Как ИИ-агенту освоить новый навык на практике методом Сократа
ИИ-обзоры простыми словами
Каждый день читаем свежие статьи об ИИ и пересказываем главное естественным языком — без хайпа и воды. Если хотите понимать, куда движутся ИИ-агенты раньше остальных, — подписывайтесь.
Новые обзоры — каждый день
В Telegram