Длинные задачи по программированию требуют от модели не только писать код, но и собирать из множества частей работающий проект. RepoFactory автоматически превращает реальные репозитории в учебные задачи, а затем улучшает их с помощью недорогих проверок. Такое обучение заметно повышает результаты модели на задачах по созданию целых проектов.
Главная мысль
Обычно систему для обучения проверяют на пригодность: запускается ли код и проходят ли тесты. RepoFactory добавляет второй шаг — меняет сами задачи, чтобы в них было больше работы и связей между компонентами. Затем авторы проверяют, помогает ли такое обучение на независимых бенчмарках.
🟠 Реальный репозиторий становится задачей: агент должен восстановить проект по описанию, не видя исходного кода.
🟠 Качество среды оценивают по трём признакам: проходит ли она проверку, связаны ли части проекта между собой и сколько кода предстоит написать.
🟠 После каждой правки среду проверяют заново; неудачную версию откатывают.
🟠 Модель, обученная на таких задачах, заметно улучшила результаты на создании репозиториев и других задачах для программных агентов.
Что такое RepoFactory
RepoFactory — это пайплайн, который превращает исходные проекты в проверяемые среды для обучения. Он находит репозитории, создаёт для них изолированное окружение, составляет описание задачи и затем улучшает её по результатам автоматических проверок.
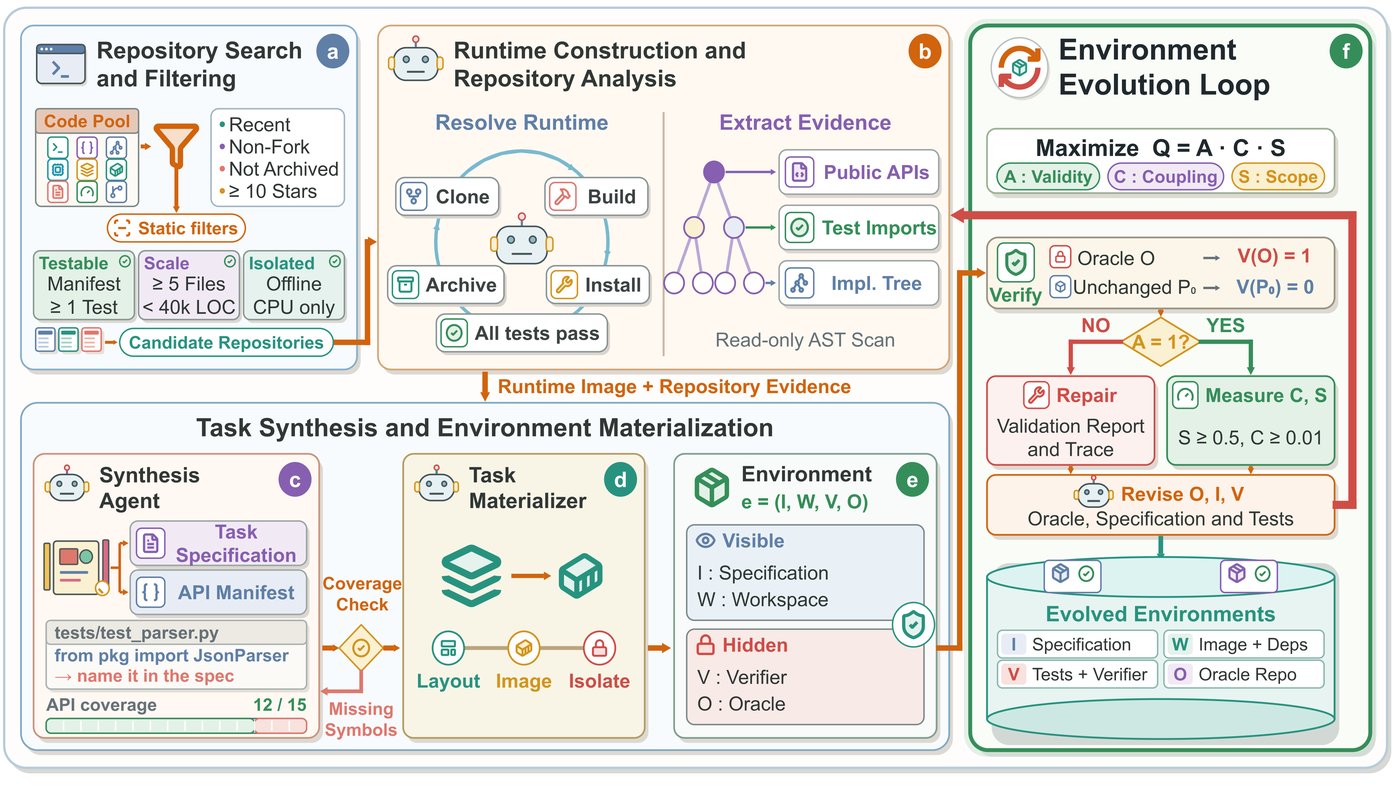
RepoFactory ищет репозитории, собирает для них окружения, составляет задания и улучшает их по проверкам.
Система состоит из нескольких связанных частей:
🟣 Поиск проектов. Система отбирает открытые репозитории с метаданными пакета и тестами. Проекты, которым нужны внешние сервисы, доступ к сети или специальное оборудование, исключают: среда должна работать изолированно.
🟣 Подготовка окружения. Для проекта создают контейнер — отдельную среду запуска с зависимостями. Система проверяет, что тесты проходят в чистом контейнере без доступа к сети.
🟣 Составление задания. Анализатор извлекает из кода публичные функции и классы, а также интерфейсы, которые вызывают тесты. По этим данным агент составляет описание того, что нужно реализовать. Исходный проект и проверяющий код остаются скрытыми от обучаемого агента.
🟣 Цикл улучшения среды. Система проверяет описание, реализацию и тесты, а затем меняет их вместе. Так можно исправить неудачную среду или увеличить объём работы, которую требует задача.
Для улучшения используют три оценки. Пригодность означает, что исходная реализация проходит тесты, а пустая среда — нет. Связанность показывает, насколько тесно взаимодействуют части программы. Масштаб реализации учитывает объём кода и число зависимостей. Оценки перемножают: если любой показатель равен нулю, итоговая оценка тоже обнуляется.
Это приблизительные признаки обучающей ценности, а не прямое измерение того, насколько хорошо агент научится. Поэтому авторы отдельно проверяют эффект на обученной модели.
Как работает восстановление проекта по описанию
Представим, что RepoFactory выбрала библиотеку для обработки данных. Она должна превратить её в задачу, в которой агент создаёт библиотеку заново, не имея доступа к исходному проекту.
🟠 Сначала система запускает библиотеку в контейнере и проверяет её тестами. Если зависимости не установились или тесты не работают, среду исправляют. Если это не удаётся, проект не проходит проверку пригодности.
🟠 Затем анализатор выясняет, какие функции и классы использует набор тестов. На этой основе агент составляет описание проекта и список интерфейсов, которые нужно реализовать.
🟠 Система сверяет описание со списком символов, вызываемых тестами. Если нужный интерфейс пропущен, проверка сообщает об ошибке, и описание исправляют.
🟠 После этого проверяют, что исходная библиотека получает полный балл, а пустая папка — нулевой. Если условие не выполнено, агент изучает отчёт и меняет описание, код или тесты. Если задача слишком мала или её части почти не связаны, агент пытается расширить проект или усилить взаимодействие между компонентами.
🟠 Каждую новую версию проверяют заново. Если выбранный показатель не вырос, систему возвращают к предыдущей версии. Цикл может повторяться до 12 раз.
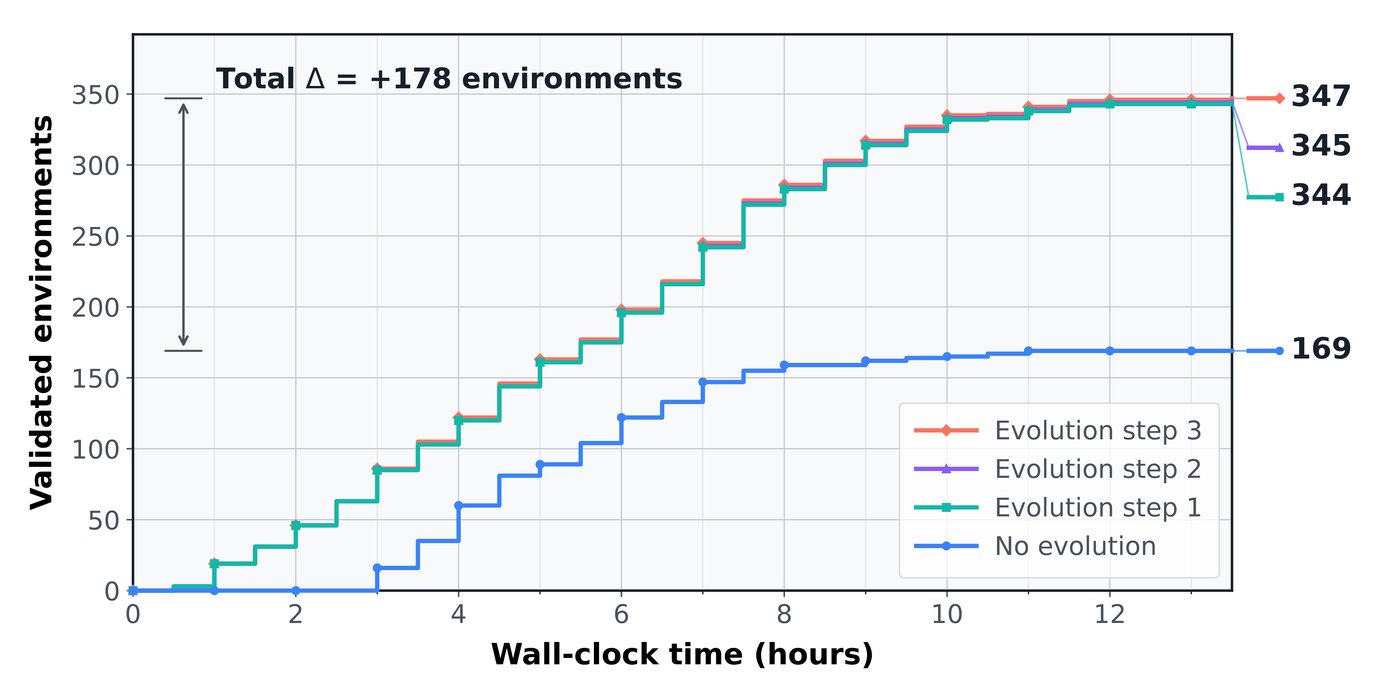
По мере исправлений растёт число сред, прошедших проверку пригодности.
В этом процессе агент не решает задачу целиком. Вместо этого RepoFactory использует отчёты тестов и анализ кода — это дешевле, чем каждый раз запускать долгую попытку решения и ждать результата. Но такие проверки могут не заметить, например, что описание стало формально полным, а задача всё ещё не требует содержательного программирования.
Как проверяют RepoFactory
Авторы оценивают систему по двум направлениям: удаётся ли создавать больше пригодных сред и помогает ли обучение на них самой модели.
Для проверки модели используют пять бенчмарков. NL2Repo оценивает создание полного репозитория по описанию. Три версии SWE-bench проверяют исправление ошибок в существующих проектах, в том числе на разных языках. Terminal-Bench проверяет выполнение задач в командной строке.
Сравнение с вариантом без цикла улучшения показывает вклад самой доработки сред. Чтобы оценить ценность данных, авторы также обучают модели на других наборах задач по программированию. В сравнении используют одинаковую модель, сопоставимое число обучающих примеров и одну обвязку для оценки. При этом ранее опубликованные результаты других работ получены в разных условиях.
Отдельный эксперимент проверяет, помогает ли увеличение числа сред. Ещё один сравнивает обучение на средах с разной сложностью и связанностью. Так авторы пытаются отделить эффект масштаба от эффекта самого цикла улучшения.
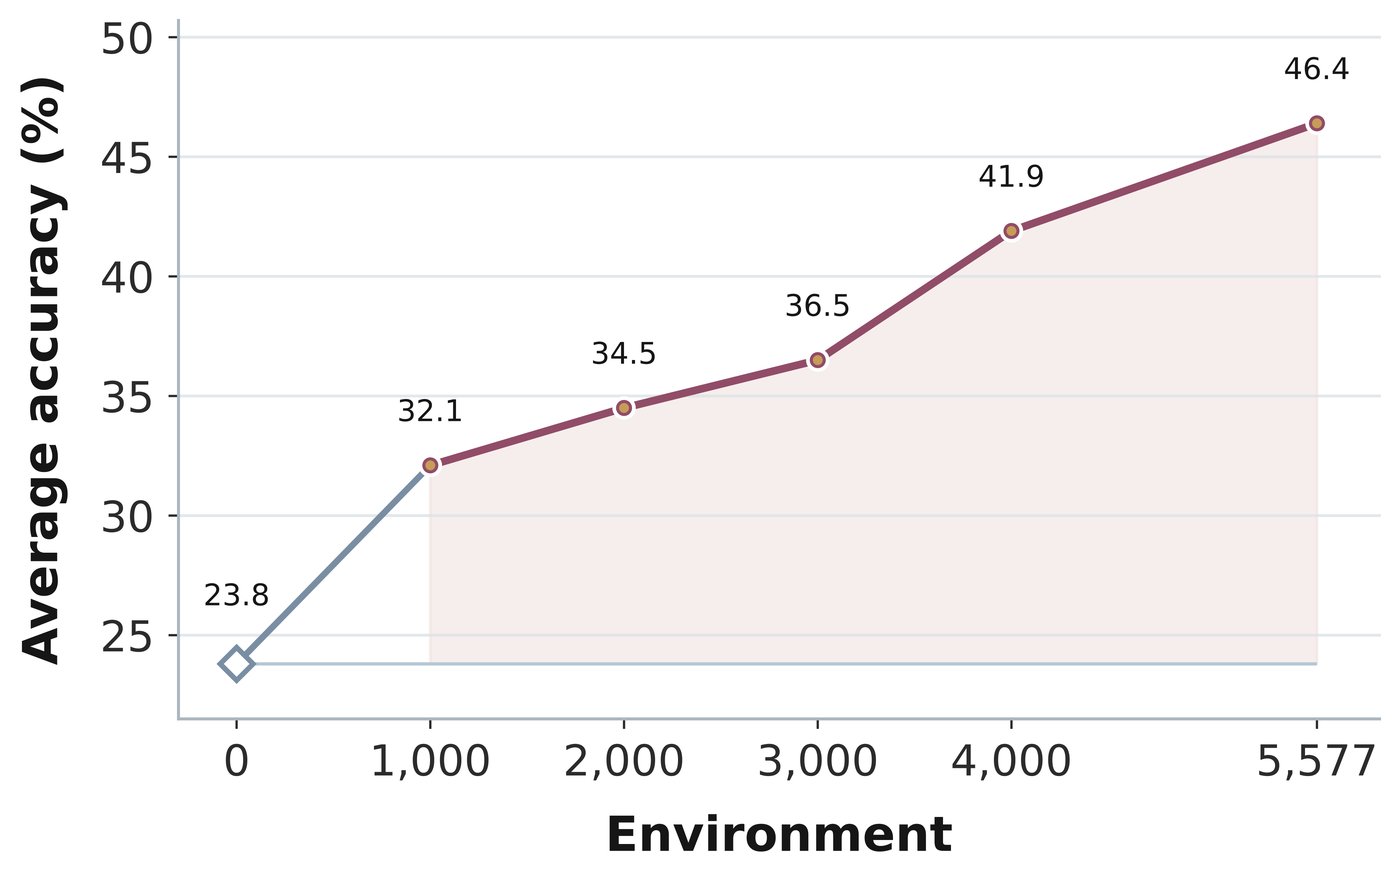
На бенчмарке NL2Repo точность растёт вместе с числом обучающих сред.
Цифры
Обучение повысило результат на всех пяти бенчмарках, но эффект оказался неодинаковым: наибольший прирост пришёлся на создание репозиториев. Вариант с циклом улучшения сред также обошёл обучение без него: результаты на NL2Repo составили 46,4% против 41,3%, а среднее по пяти бенчмаркам — 53,5% против 51,5%. Прирост связан не только с количеством задач: их автоматическая доработка тоже улучшила результаты.
Вывод
RepoFactory показывает, что реальные репозитории можно превращать в проверяемые задачи по сборке целого проекта, а не только по исправлению отдельного фрагмента кода. Модель, обученная на таких задачах, улучшила результаты не только на создании репозиториев, но и на исправлении ошибок и работе в командной строке.
Главное ограничение — охват и точность оценок. Система пока сосредоточена на проектах на Python, а три показателя качества лишь в общих чертах описывают задачу. Они не определяют напрямую, какие именно навыки программирования потребуются агенту. Поэтому дальнейшая работа — расширить поддержку языков и точнее оценивать, чему обучает каждая среда.
Читайте также
 Какой ИИ выбрать для медицинских задач
 Почему ИИ-агенту трудно действовать в реальном мире
 Как отличить генерацию видео от симуляции мира
 Как ИИ может усилить интеллект конкретного человека
 Проверим, способны ли ИИ-агенты делать открытия в физике
 Как ИИ выбирает подходящую модель для каждой задачи
 Как управлять роботом с помощью небольшой ИИ-модели
 Сотни тысяч профессиональных задач помогли обучить ИИ-агентов
 Как ИИ-агенты учатся общим навыкам на разных задачах
 Как понять, что ИИ-агент выполняет задачу неправильно
 Как ИИ-агенту освоить новый навык на практике методом Сократа
 Как ИИ-агент сам улучшает интерфейсы
ИИ-обзоры простыми словами
Каждый день читаем свежие статьи об ИИ и пересказываем главное естественным языком — без хайпа и воды. Если хотите понимать, куда движутся ИИ-агенты раньше остальных, — подписывайтесь.
Новые обзоры — каждый день
В Telegram