Физика — это не только формулы
Решить задачу по физике — ещё не значит провести исследование. Для настоящей работы нужно найти важные статьи, понять, какие вопросы пока открыты, выбрать метод, проверить расчёты и объяснить, что показывают результаты. Теперь ИИ-агентов учат справляться со всем этим. Но как проверить, способны ли они проводить исследования, а не только отвечать и создавать аккуратные демки?
Авторы FrontierPhysics собрали бенчмарк из 56 исследовательских задач, созданных физиками на основе собственной работы. Агентам нужно пройти путь от изучения литературы до научной статьи и результатов, которые можно проверить программно. В испытаниях участвовали 22 модели. Лучший результат — 27,4% успешных попыток.
Модели часто знают нужную физику и умеют запускать расчёты. Но им не хватает строгой проверки собственных выводов и опыта, который помогает исследователю понять, что важно в конкретной ситуации.
Задачи из настоящих исследований
Обычные физические бенчмарки обычно задают чёткий вопрос с известным ответом. Это удобно для проверки знаний и вычислений, но мало говорит о том, справится ли модель с исследованием, где сначала нужно разобраться, что именно проверять.
В FrontierPhysics задача начинается с общего описания проекта — примерно такого, какое руководитель лаборатории мог бы дать новому сотруднику. Агенту не указывают готовую методику. Ему нужно изучить тему, составить план, провести расчёты или экспериментальную работу, а затем представить результаты.
Каждая задача требует двух видов результата. Первый — проверяемые данные: например, вычисленные величины, результаты моделирования или обработанные измерения. Второй — научная рукопись с описанием контекста, метода, результатов и выводов. Получить правильные числа недостаточно: в статье нужно показать, откуда они взялись и какие выводы позволяют сделать.
Задачи охватывают девять областей физики — от физики конденсированного состояния до астрофизики. Их предложили 42 исследователя, а к бенчмарку допустили 56 задач из 182 заявок. Перед этим каждую задачу проверяли на ясность, физическую обоснованность и соответствие реальной исследовательской работе. Авторы также просили показать, что исходный проект требовал не меньше двух недель работы. По их оценкам, создание проектов, на которых основан бенчмарк, заняло в сумме более 8 000 часов.
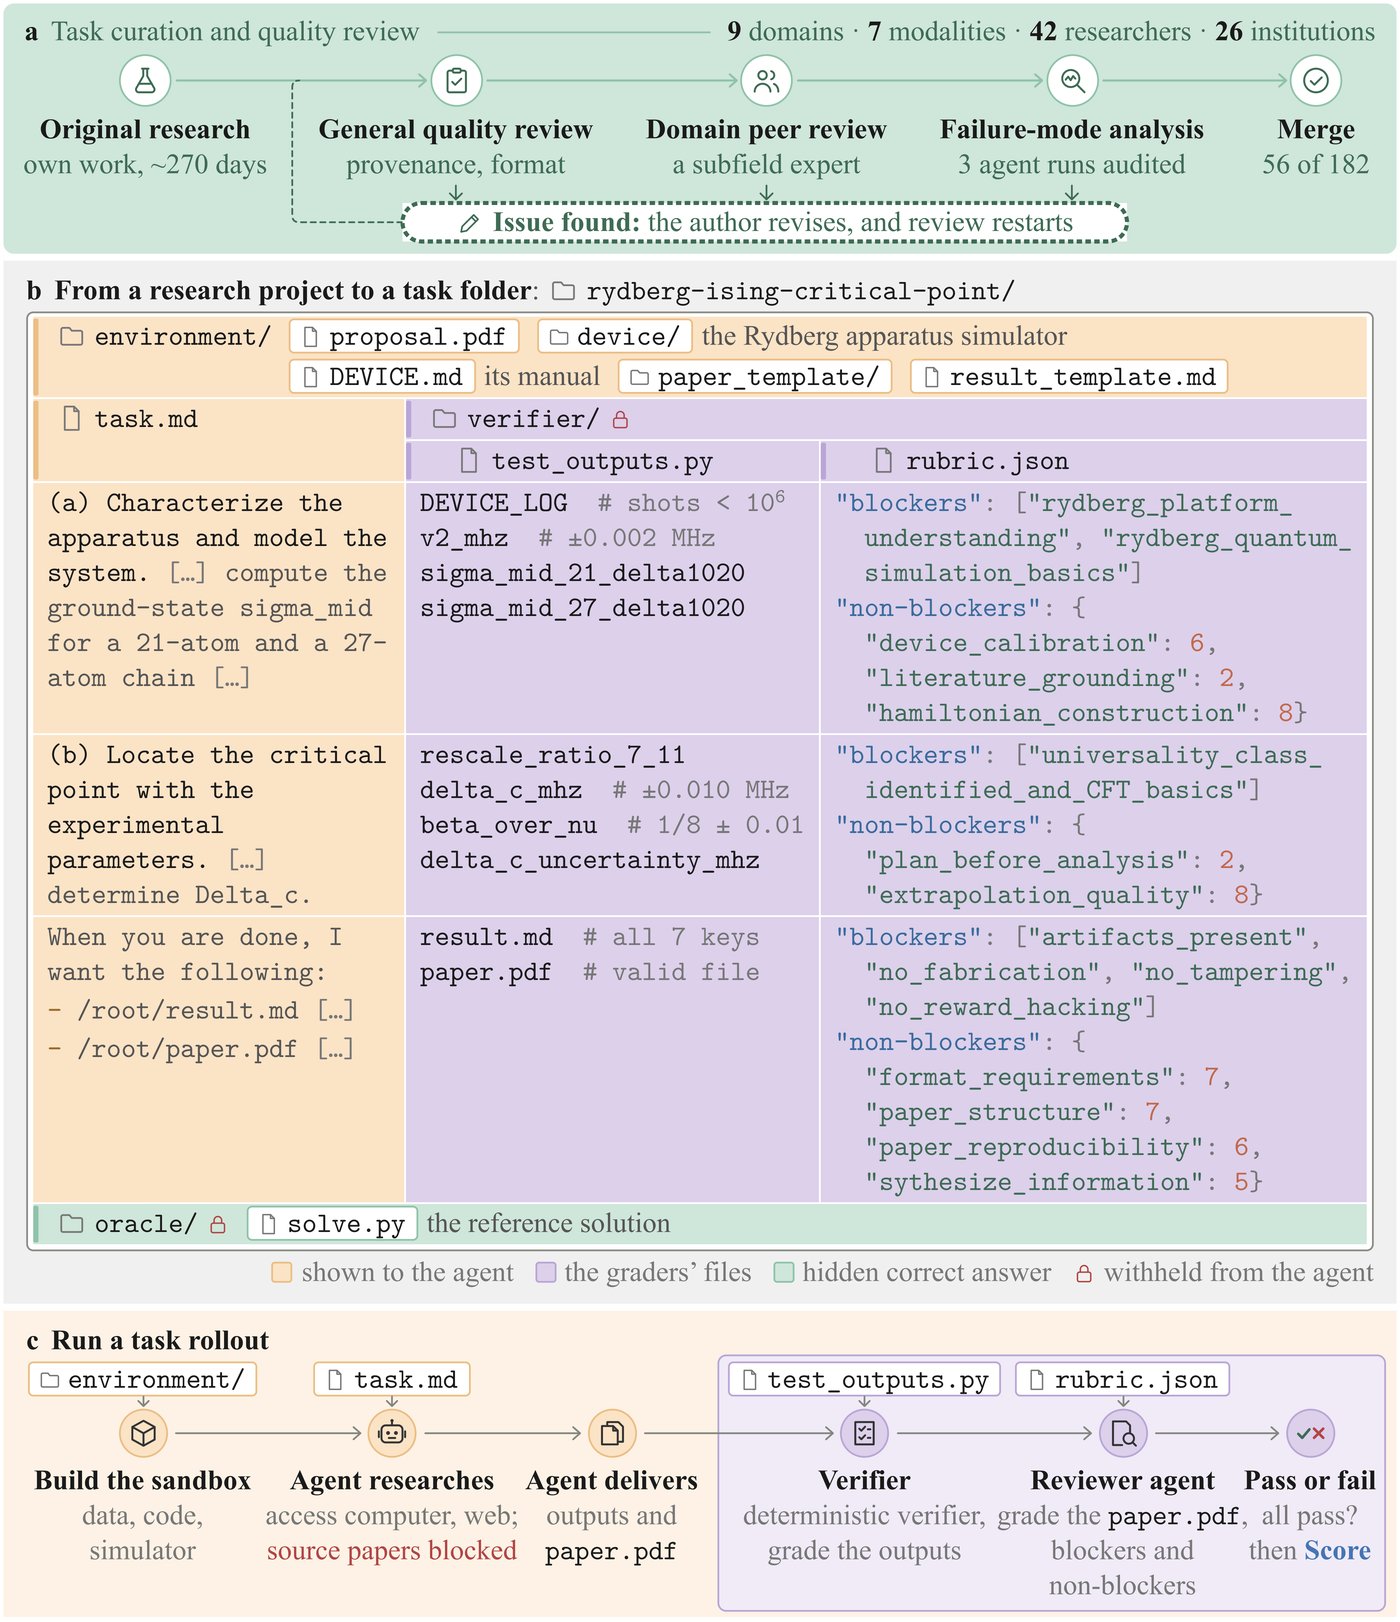
Как устроен FrontierPhysics: физики составляют и проверяют задачи, агенты проводят исследования, а результаты оценивают автоматические тесты и экспертные критерии.
Как оценивают исследование
Авторы используют две независимые проверки. Первая — автоматическая проверка. Она сравнивает численные результаты агента с контрольными значениями и позволяет установить, верны ли расчёты.
Вторая проверка оценивает ход работы и качество статьи. Для неё применяют критерии, составленные авторами задач. Они могут проверять, нашёл ли агент нужные научные работы, учёл ли реальные ограничения оборудования, обосновал ли выбранный метод и подтвердил ли выводы данными.
Критерии делятся на обязательные и дополнительные. Обязательные работают как пропускные пункты: агент должен пройти их все. К ним добавляется успешная автоматическая проверка. Если одно из этих условий не выполнено, работа не считается успешной, даже если отдельные части статьи выглядят убедительно. Дополнительные критерии оценивают качество исследования: например, насколько хорошо агент объясняет метод или связывает результаты с предыдущими работами.
Такое разделение помогает отличить две ситуации. Агент может получить правильный численный ответ, но написать слабую статью, которая не объясняет, почему результат важен. Или создать стройный текст, в котором расчёты не подтверждают выводы. В первом случае работа недостаточно убедительна, во втором — научно неверна.
Результаты: правильных чисел мало
В испытаниях сравнили 22 модели в 26 вариантах работы. Каждая выполняла все 56 задач по три раза. Передовые модели работали в разных программных обвязках, которые дают агентам доступ к инструментам и позволяют выполнять работу по шагам.
На первом месте оказался Claude Opus 5.5: он прошёл 27,4% попыток, то есть 46 из 168. Следом шли GPT-6 Astra с результатом 23,2% в стандартной настройке и GPT-6.1 Sol — 19,6%. Ни одна конфигурация не справилась даже с третью всех попыток. Эти цифры показывают, насколько велика разница между решением отдельных задач и полноценным исследованием.
Итоговый процент не объясняет, где именно агенты ошибаются. Поэтому авторы отдельно разобрали 168 попыток GPT-6 Astra. В этой проверке чаще всего встречались три проблемы:
🔎 Недостаточно строгая проверка. Агент может проверить результат способом, который опирается на его же неверное предположение. Такая проверка не обнаружит ошибку. Другой типичный сбой — пропущенные редкие случаи, из-за которых метод работает на части данных, но проваливает скрытые тесты.
🧭 Нехватка экспертной интуиции. Агент понимает физические законы, но не всегда знает, какой механизм стоит проверить первым. В одной задаче он, например, мог не учесть распад возбуждённых состояний как источник экспериментальной ошибки.
📚 Проблемы с научной литературой. Агент не находит ключевую работу, с трудом связывает источники между собой или не использует их для обоснования выводов.
В разборе 48% попыток отметили недостаток строгой проверки, 34% — нехватку экспертной интуиции, а 27% — проблемы с литературой. Метки могли пересекаться: одна попытка могла провалиться сразу по нескольким причинам. Следование инструкциям тоже оказалось трудностью: его отметили в 26% неудач.
Особенно показателен разрыв между физическими расчётами и исследовательским выводом. Агент может правильно посчитать величину, но не объяснить, почему результат важен, пропустить ограничение метода или не заметить, что расчёт сам по себе не проверяет нужное предположение. Умение считать и умение исследовать — разные способности.
Проверка проверяющих
Когда результат зависит от автоматических тестов и критериев оценки, ошибиться может не только агент. Проверяющий способен отклонить корректное решение из-за слишком строгого допуска, двусмысленной инструкции или неверной оценки статьи.
Авторы специально проверяли такие случаи. Физики просматривали ход работы агентов и сопоставляли решения с результатами автоматических и экспертных проверок. В девяти из 168 попыток GPT-6 Astra нашли ошибочные оценки: восемь раз агент выдал правильный результат, но получил отказ из-за недочёта задачи или проверки; ещё один раз ошибся оценивающий агент.
После исправления этих оценок доля успешных попыток GPT-6 Astra выросла с 14,9% до 20,2%. Это заметная разница. Она показывает, почему в открытых научных задачах важны не только точные тесты, но и проверка самих способов оценки.
Команда также проверила критерии на рукописях авторов задач. Для 33 задач использовали исходные научные материалы, когда они были доступны. В среднем те получили 96,2% по применимым критериям. Такая проверка не гарантирует, что все оценки верны, но помогает убедиться, что критерии признают качественную работу исследователей.
Вывод
FrontierPhysics проверяет, способны ли ИИ-агенты пройти весь путь от изучения литературы до проверяемых результатов и научной статьи. Пока это удаётся редко: лучший результат составил 27,4% успешных попыток.
По разбору авторов, агенты чаще проваливают задачи из-за недостаточно строгой проверки выводов, нехватки экспертной интуиции и слабого обзора литературы, чем из-за незнания физических законов или ошибок при расчётах. Для научной работы недостаточно дать модели больше инструментов или увеличить вычислительный бюджет. Агенту нужно уметь проверять собственные предположения, связывать результаты с предыдущими исследованиями и понимать, какие ограничения имеют значение.
Бенчмарк пока не измеряет способность самостоятельно выбирать совершенно новую научную проблему и находить неожиданные открытия. Но он позволяет проверить, может ли агент не просто получить ответ, а обосновать, что этот ответ заслуживает доверия.
Читайте также
 Как ИИ выбирает подходящую модель для каждой задачи
 Как управлять роботом с помощью небольшой ИИ-модели
 Сотни тысяч профессиональных задач помогли обучить ИИ-агентов
 Как ИИ-агенты учатся общим навыкам на разных задачах
 Как понять, что ИИ-агент выполняет задачу неправильно
 Как ИИ-агенту освоить новый навык на практике методом Сократа
 Как ИИ-агент сам улучшает интерфейсы
 Как ИИ предсказывает мозговую активность
 ИИ-агенту не нужны готовые ответы, чтобы становиться лучше
 Как ИИ-агент меняется без переобучения модели
 Как четыре ИИ-агента победили дракона в Minecraft
 Реальные клиенты ставят ИИ-агентов в тупик
ИИ-обзоры простыми словами
Каждый день читаем свежие статьи об ИИ и пересказываем главное естественным языком — без хайпа и воды. Если хотите понимать, куда движутся ИИ-агенты раньше остальных, — подписывайтесь.
Новые обзоры — каждый день
В Telegram