Один ИИ — много специалистов
Представьте, что на каждый вопрос отвечает одна и та же модель. Она же пишет код, генерирует видео и управляет роботом. Удобно — но дорого, и не всегда хорошо. Часто одна модель лучше решает задачи по программированию, другая — понимает изображение, а третья успешнее управляет роботом в сложной сцене.
Авторы статьи Route Anything предлагают собирать общие системы ИИ из специализированных моделей и инструментов. Для каждой задачи система выбирает подходящего исполнителя. Такой выбор называют маршрутизацией.
Ключевой вопрос — как выбирать: отправлять запрос самой сильной модели или искать более дешёвый вариант, который справится почти так же хорошо? Исследователи изучили этот вопрос сразу для текста, изображений, видео, речи, программирования и робототехники.
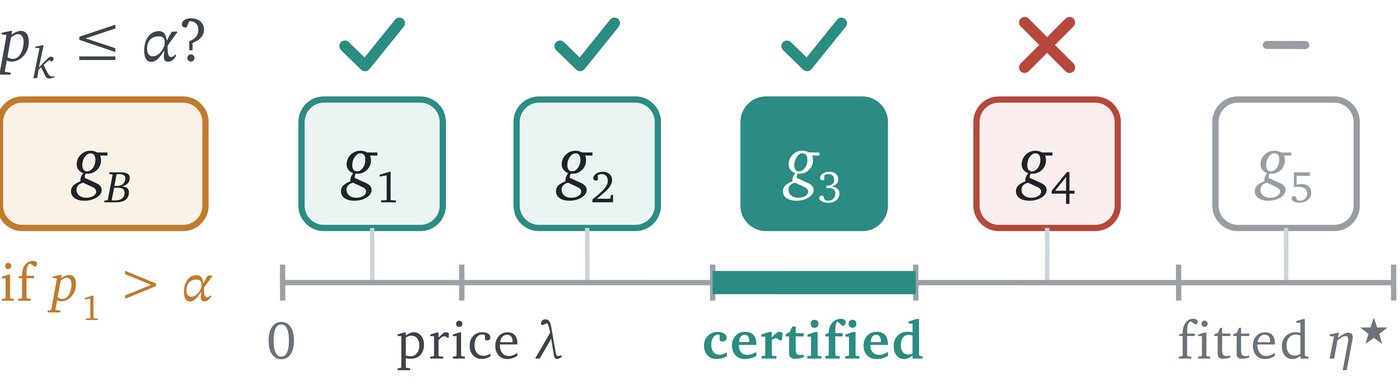
На схеме показано, как система выбирает исполнителя для каждого запроса и сопоставляет качество с затратами.
Как измерить пользу маршрутизации
Авторы собрали данные по 25 бенчмаркам и 452 вариантам моделей, инструментов и политик управления роботами. Каждый вариант проверяли на одних и тех же входных данных. Всего получилось 374 тысячи оценённых запусков.
Это условие важно. Если одну модель проверяли на лёгких задачах, а другую — на трудных, сравнение мало что скажет о выборе исполнителя. Здесь же можно увидеть, кто лучше отвечает именно на один и тот же запрос.
Исследователи сравнивали три подхода:
🟠 Один постоянный кандидат для всех запросов в бенчмарке.
🟠 Маршрутизатор выбирает кандидата по доступным признакам: например, по типу задачи или самому запросу.
🟠 Оракул задним числом выбирает лучшего кандидата для каждого входа. Это недостижимый в обычной работе верхний предел, потому что для такого выбора нужно заранее знать результат.
Оракул в среднем опережает лучшего постоянного кандидата на 5,4 пункта по стобалльной шкале. Разрыв особенно велик для видео и управления роботами — около 19 и 18 пунктов. Значит, модели действительно дополняют друг друга: нет одного исполнителя, который лучше всех решает каждую задачу.
Но большая часть выгоды скрыта внутри одного типа задач. Если знать только, что перед нами, скажем, запрос на генерацию изображения, выбор почти не меняется. Чтобы приблизиться к оракулу, маршрутизатору нужно различать отдельные запросы и условия их выполнения.
Маршрутизатор пока не догоняет оракула
Для практической проверки авторы обучили маршрутизаторы на данных о задачах и результатах кандидатов. Основной вариант предсказывал ожидаемый результат каждого кандидата и выбирал того, у кого прогноз выше. Отдельный вариант сначала определял тип задачи, а затем выбирал подходящую модель из таблицы.
На 16 бенчмарках маршрутизатор набрал 79,98 пункта. Лучший постоянный кандидат — 79,68. Разница небольшая, но показывает, что обученный выбор может превзойти фиксированную модель. На генерации видео выигрыш составил 2,1 пункта, а на задачах с программированием и рабочими агентами — 0,8 пункта.
Это далеко от оракула: его результат в том же сравнении — 84,80. Маршрутизатору удаётся использовать лишь небольшую часть доступного запаса. На генерации изображений проверили 124 настройки маршрутизации; ни одна не превзошла постоянную модель с убедительным преимуществом.
Сравнение постоянного выбора, обученного маршрутизатора и оракула на разных группах задач.
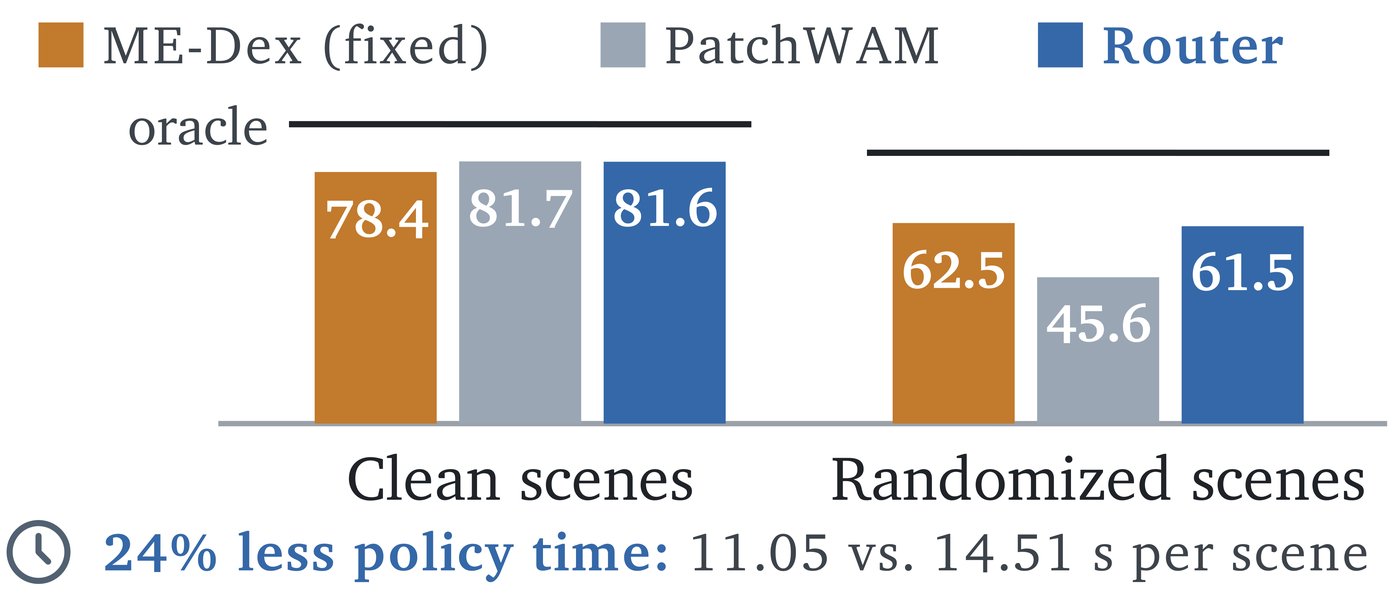
Отдельный эксперимент с роботами показал, зачем маршрутизатору могут быть полезны сами входные изображения. Система получала инструкцию, состояние робота и три кадра с камер. В чистых сценах она чаще выбирала одну политику управления, а в сценах со случайными изменениями — другую.
На двух тысячах тестовых сцен маршрутизатор добился успеха в 71,6% случаев. Лучший одиночный вариант — в 70,5%. При этом время работы политики сократилось на 24%. Разница в успешности была небольшой и статистически неуверенной, но сочетание качества и меньшего времени выглядело перспективно.
На чистых и изменённых сценах маршрутизатор выбирает разные политики управления роботом.
Предсказывать результат, а не победителя
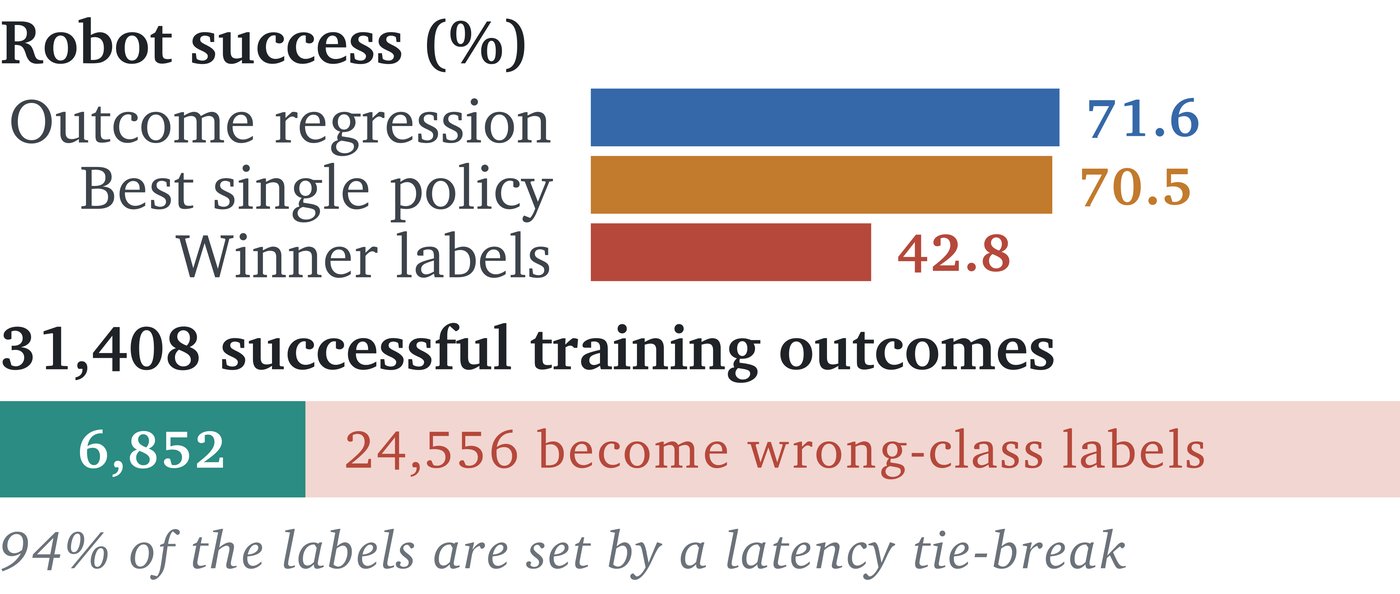
Ещё один вывод касается того, чему именно обучать маршрутизатор. Можно попросить его назвать победителя — кандидата с лучшим результатом на конкретном примере. Но такое обучение теряет информацию: если несколько моделей справились успешно, в метке всё равно останется только одна.
На роботах эта разница оказалась особенно заметной. Модель, предсказывавшая успех каждой политики отдельно, достигла 71,6% успешных выполнений. Классификатор, который должен был угадывать победителя, — только 42,8%.
Причина была в правилах выбора победителя. Если несколько политик справлялись с задачей, предпочтение часто отдавали более быстрой. В итоге классификатор учился выбирать скорость, а не вероятность успеха. По мнению авторов, маршрутизатору полезнее учиться оценивать ожидаемый результат каждого кандидата, а затем сравнивать эти оценки.
Результат зависит и от того, с чем сравнивают маршрутизатор. Если постоянную модель исключают из набора из-за нескольких пропущенных оценок, базовый результат падает. Тогда маршрутизатор может показаться лучше, хотя выигрыш возник из-за способа подсчёта. Поэтому кандидатов нужно сравнивать на одинаковых входах и с одинаковыми правилами замены при пропущенных результатах.
Экономия без заметной потери качества
Самый крупный практический эффект обнаружился не в улучшении качества, а в снижении цены. Исследователи сравнили маршруты с сильной моделью или другим фиксированным исполнителем, который считался исходным вариантом. В среднем эффективность — качество на доллар или секунду работы — выросла в 8,82 раза.
Для задач по программированию выигрыш составил 25,5 раза, для текстовых вопросов и ответов — 7,1 раза. В этих случаях маршрутизатор чаще обращался к более дешёвым моделям и выбирал исходную лишь там, где она была действительно нужна.
Но условия имеют значение. На одном наборе задач по программированию дешёвые модели почти не уступали исходной, поэтому маршрутизатор смог обойтись без неё. На текстовых вопросах слабые модели теряли слишком много качества: здесь понадобилась схема с проверкой и переходом к более сильной модели, если первая не справилась.
Авторы также проверили, можно ли гарантировать допустимую потерю качества. Маршрутизатор сначала подбирают на обучающих данных, а затем проверяют на отдельной выборке. В экспериментах такой подход удерживал обещанный предел потери качества во всех 200 проверках для двух наборов задач, хотя случайно подобранные маршруты часто не проходили проверку.
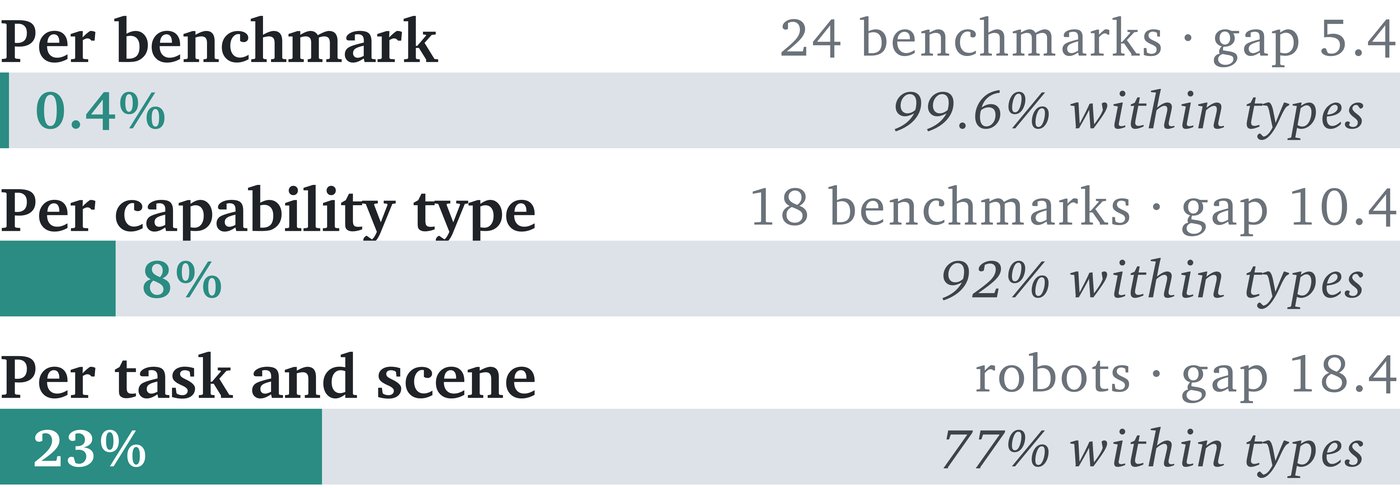
Маршрутизация сокращает расходы по сравнению с постоянным выбором сильной модели, сохраняя близкое качество.
Более сложная обвязка тоже может оказаться невыгодной. Например, проверка кода бесплатным компилятором помогала отсеивать неудачные решения. А языковой судья при обычной цене обходился настолько дорого, что экономия исчезала. Польза проверки определяется не тем, насколько она выглядит разумно, а тем, сколько ошибок она предотвращает и сколько стоит.
Вывод
Маршрутизация полезна прежде всего там, где качество кандидатов близко, а цена заметно различается. Она уже может снижать расходы без ощутимого ухудшения результата, а в некоторых задачах — немного повышать качество, выбирая разных исполнителей для разных входов.
До выбора идеального кандидата для каждого запроса ещё далеко. Обученные маршрутизаторы используют лишь небольшую часть потенциального выигрыша, особенно когда различия между задачами тонкие. Для практических систем важны три правила: сравнивать кандидатов на одних и тех же входах, предсказывать результаты каждого кандидата, а не просто угадывать победителя, и отдельно проверять, что экономия не опустила качество ниже допустимого уровня.
Общая система ИИ может состоять из множества специализированных частей. Но её полезность зависит не только от того, какие модели доступны. Важно ещё понять, когда именно стоит вызывать каждую из них.
Читайте также
 Как управлять роботом с помощью небольшой ИИ-модели
 Сотни тысяч профессиональных задач помогли обучить ИИ-агентов
 Как ИИ-агенты учатся общим навыкам на разных задачах
 Как понять, что ИИ-агент выполняет задачу неправильно
 Как ИИ-агенту освоить новый навык на практике методом Сократа
 Как ИИ-агент сам улучшает интерфейсы
 Как ИИ предсказывает мозговую активность
 ИИ-агенту не нужны готовые ответы, чтобы становиться лучше
 Как ИИ-агент меняется без переобучения модели
 Как четыре ИИ-агента победили дракона в Minecraft
 Реальные клиенты ставят ИИ-агентов в тупик
 Рассуждения без слов улучшили ответы ИИ-агента на 10% и снизили расходы почти в 4 раза
ИИ-обзоры простыми словами
Каждый день читаем свежие статьи об ИИ и пересказываем главное естественным языком — без хайпа и воды. Если хотите понимать, куда движутся ИИ-агенты раньше остальных, — подписывайтесь.
Новые обзоры — каждый день
В Telegram