ИИ-модель, которая набрала больше всех баллов в медицинском бенчмарке, не обязательно лучше справится с задачей конкретной клиники: рейтинг меняется, если оценивать рассуждение, действия или работу с медицинскими записями. InclusionMed собирает такие проверки в общую систему и показывает, какие задачи она охватывает, а какие пока почти не представлены.
Общий балл часто выглядит убедительнее, чем позволяет его основа: он зависит от того, какие задания включили в сравнение и как их взвесили.
Главная мысль
InclusionMed — открытая система оценки медицинских моделей. Она связывает отбор бенчмарков, проверку их воспроизводимости и сравнение моделей, чтобы общий рейтинг можно было рассматривать вместе с результатами по конкретным ролям и способностям.
🟠 Атлас раскладывает медицинские задачи по роли в здравоохранении и способности ИИ: знаниям, рассуждению или выполнению действий.
🟠 Кандидатные бенчмарки проходят проверку по шести критериям, а затем независимое воспроизведение — так отсеивают непригодные и переставшие различать модели тесты.
🟠 Итоговый индекс усредняет результаты пяти бенчмарков, а отдельные оценки показывают, как модели справляются с разными видами задач и сколько стоит их запуск.
Из чего состоит система InclusionMed
Система начинается с карты покрытия и заканчивается сравнением моделей. Атлас устроен как матрица: три роли в здравоохранении пересекаются с тремя способностями ИИ. Роль отвечает на вопрос, чью работу или потребности отражает задача; способность — что именно должен показать ИИ.
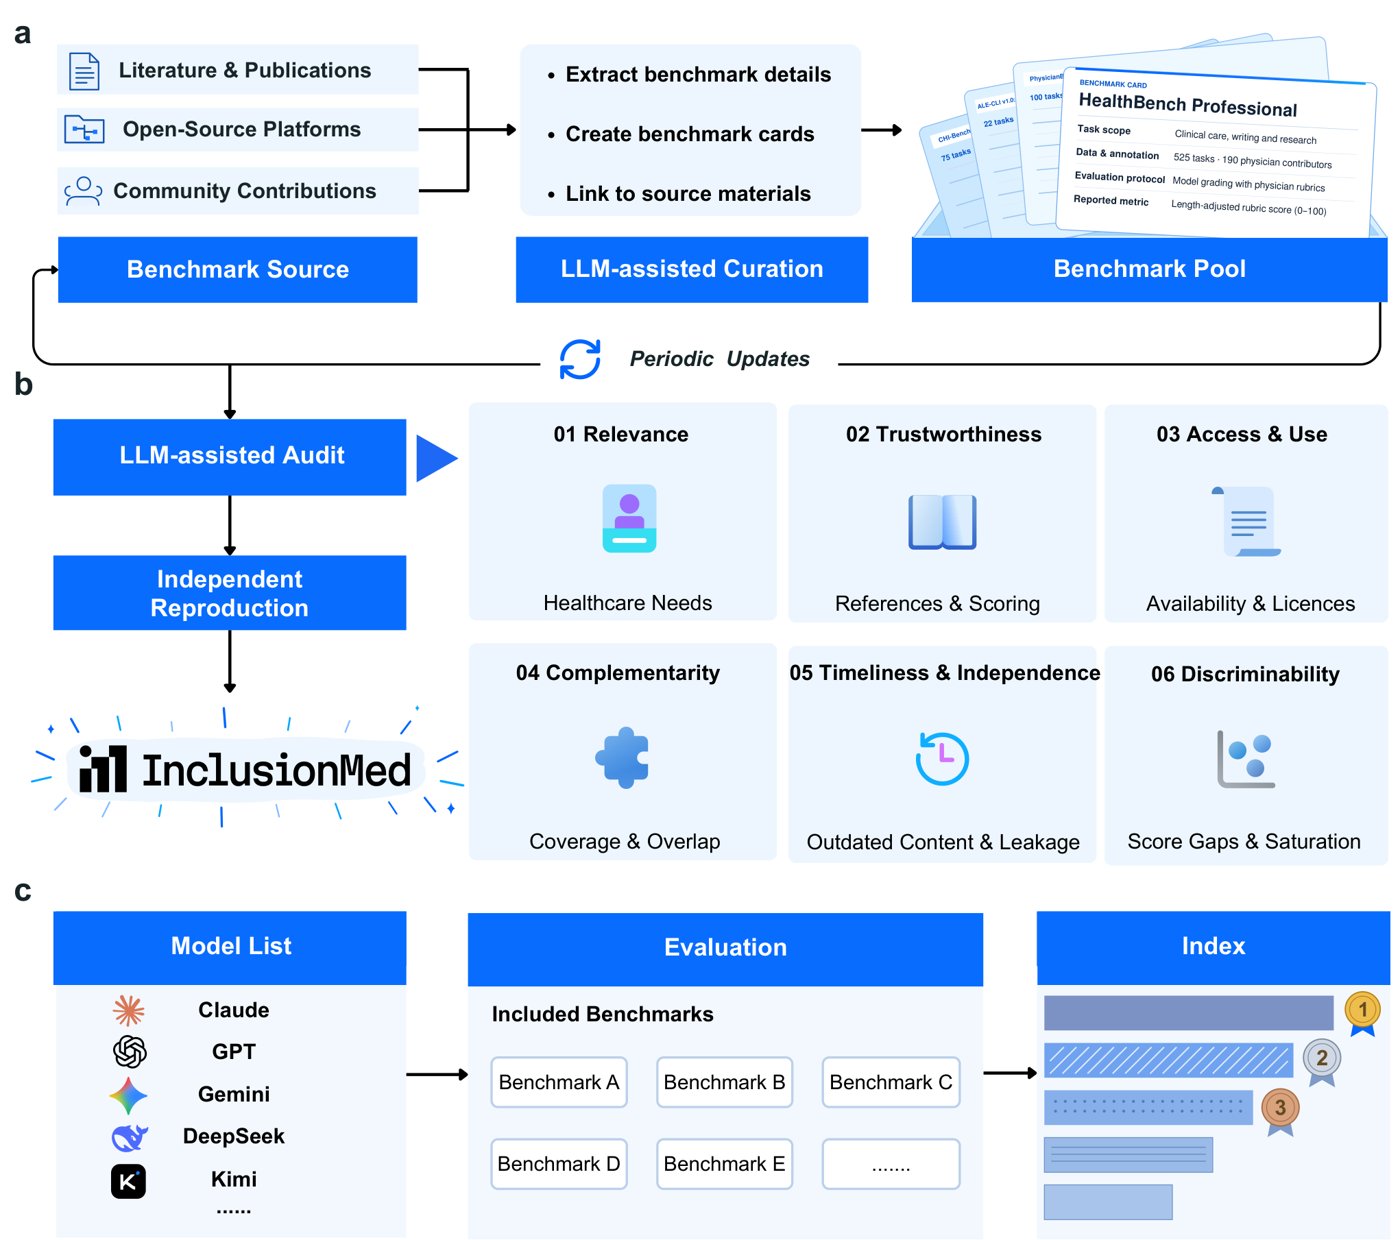
Путь InclusionMed: сбор кандидатов, аудит и независимое воспроизведение, затем оценка моделей и расчёт общего индекса.
В этой схеме важны три части.
🟣 Сбор и описание. Команда собрала бенчмарки из научных публикаций, открытых платформ и предложений сообщества. С помощью больших языковых моделей сведения о задачах, данных, оценивании и доступности оформляют в карточки, которые затем проверяют люди. Сбор повторяют, чтобы добавлять новые тесты и обновления.
🟣 Аудит и воспроизведение. Кандидатов проверяют на медицинскую значимость, надёжность источников и оценивания, доступность, пользу для общего покрытия, актуальность и способность различать модели. Затем исследователи запускают одни и те же модели на отобранных бенчмарках и сверяют, получается ли воспроизвести их оценку.
🟣 Пять бенчмарков и индекс. В первую версию вошли четыре открытых бенчмарка и один закрытый, созданный авторами. Каждый получает одинаковый вес — 20%. Индекс дополняют оценки по роли и способности, а также приблизительная стоимость обработки одной задачи.
Карта пока покрывает только три из девяти возможных сочетаний роли и способности. В ней нет бенчмарка, который в первую очередь оценивает помощь пациентам и широкой публике; знания как отдельную способность тоже пока не представляют включённые тесты.
Как это работает: от проверки бенчмарка к рейтингу
Представим новый бенчмарк, где ИИ должен выполнять рабочие задачи медицинской организации. Сначала система проверяет сам тест, затем сравнивает на нём модели.
🟠 Сначала бенчмарк описывают. Из публикации, сайта и доступных материалов собирают сведения о задачах, источниках данных, правилах оценки и лицензии. Если материалы неполные или непонятно, откуда взялись правильные ответы, это может стать причиной отказа.
🟠 Затем определяют место в атласе. Команда выясняет, чью работу отражают задания и какую способность они проверяют. Если большинство задач посвящено действиям сотрудников администрации, тест относят к роли медицинской администрации и способности выполнять действия.
🟠 Потом проходят аудит и воспроизведение. Исследователи проверяют бенчмарк по шести критериям и запускают на нём один и тот же набор из восьми моделей. Тест исключают, если он почти не различает модели или верхние результаты упираются в потолок. Здесь система может остановиться: например, из-за недоступного кода, сомнительных эталонных ответов или невоспроизводимого оценивания.
🟠 Наконец, оценивают модели и считают индекс. Вошедший в Атлас тест становится частью сравнения. Каждая модель получает оценку по пяти бенчмаркам; их среднее с равными весами формирует общий результат. Если важна именно административная работа или способность рассуждать, можно смотреть профиль по этой категории, а не только общий рейтинг.
Состав индекса влияет на вывод: модель может хорошо выступить на клинических вопросах, но хуже — при выполнении процедур. Если подходящего бенчмарка нет, рейтинг не заполнит этот пробел.
Как это проверяют
В первой версии сравнили 22 выпуска моделей из 11 семейств. Проверки охватывают пять бенчмарков: ответы на профессиональные запросы врачей, работу с электронными медицинскими записями, вычислительные задачи медицинских исследований, административные процессы и диагностическое рассуждение.
Модели запускали по правилам каждого бенчмарка. В одном случае ответ оценивали по врачебным критериям, в другом задача считалась успешной только при прохождении всех контрольных пунктов, а в третьем проверяли, совпали ли диагноз и его обоснование с эталоном. Все оценки приводили к шкале от нуля до ста, но исходные метрики различались. Поэтому общий индекс удобен для ориентира, но не превращает задачи в полностью одинаковые измерения.
Чтобы проверить качество самих бенчмарков, восемь моделей прогнали на восьми кандидатах. Тест исключали, если три лучшие модели набирали не менее 85 баллов или разброс результатов между моделями был не больше четырёх баллов. Это помогает выявить потолок и слабую способность различать результаты, хотя не проверяет, насколько задания отражают реальную работу клиники.
Кроме оценок, авторы сравнили расчётную стоимость инференса — обработки запросов моделью. Её оценивали по числу входных и выходных токенов и опубликованным ценам. В расчёт не вошли часть расходов на неудачные запуски, повторные попытки, оценивание и инструменты, поэтому это не полная стоимость внедрения.
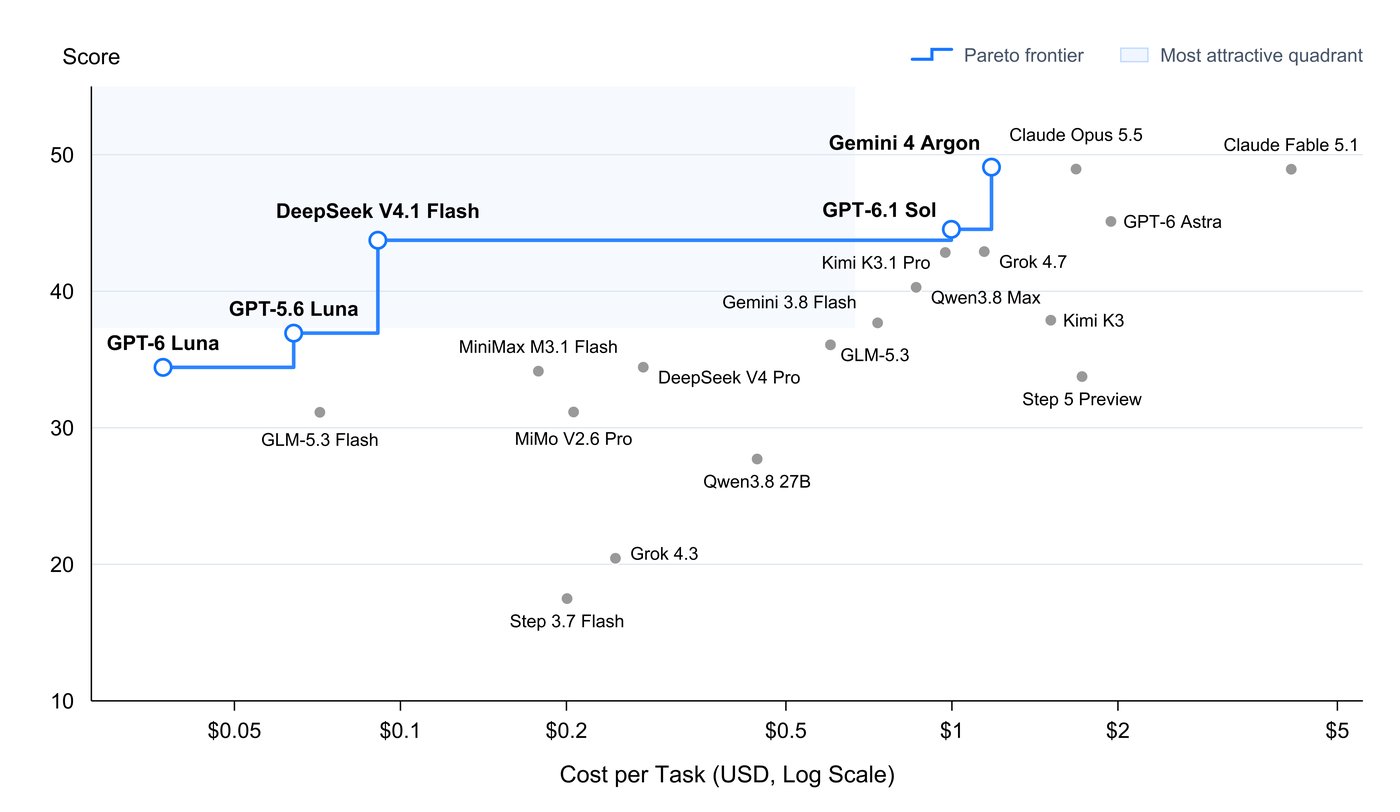
Сравнение общего балла и расчётной стоимости: близкие результаты моделей могут требовать разных затрат.
Цифры
Числа показывают масштаб отбора и пределы сравнения. Из 388 кандидатов в индекс попала малая часть, а оценки моделей заметно различались. При этом близкий общий балл не означает близких расходов: выбор модели зависит от того, какие задачи нужны и сколько стоит регулярно их проверять.
Что это значит
InclusionMed превращает медицинскую оценку ИИ в систему, где можно увидеть не только рейтинг, но и его состав: какие роли и способности представлены, как отбирались тесты и где остаются пробелы. В отдельных задачах заметны различия, которые общий балл сглаживает: например, десять лидирующих моделей лучше справлялись с общением с пациентом, чем с клиническими решениями.
Но нынешний индекс покрывает лишь три из девяти ячеек Атласа. Большинство задач связано с английским языком, текстом и медицинскими условиями США; помощь пациентам напрямую не представлена. Кроме того, только 104 кандидатных бенчмарка имели достаточно материалов для независимого воспроизведения.
Рейтинг помогает сузить выбор, но не подтверждает безопасность модели для клинического применения. Для такого решения нужны проверки в конкретной клинике, с её задачами, правилами и ограничениями. Дальше системе предстоит расширять покрытие, добавлять задачи для пациентов и разных регионов, регулярно проверять, не устарели ли тесты, и точнее учитывать полную стоимость рабочих процессов.
Читайте также
 Почему ИИ-агенту трудно действовать в реальном мире
 Как отличить генерацию видео от симуляции мира
 Как ИИ может усилить интеллект конкретного человека
 Проверим, способны ли ИИ-агенты делать открытия в физике
 Как ИИ выбирает подходящую модель для каждой задачи
 Как управлять роботом с помощью небольшой ИИ-модели
 Сотни тысяч профессиональных задач помогли обучить ИИ-агентов
 Как ИИ-агенты учатся общим навыкам на разных задачах
 Как понять, что ИИ-агент выполняет задачу неправильно
 Как ИИ-агенту освоить новый навык на практике методом Сократа
 Как ИИ-агент сам улучшает интерфейсы
 Как ИИ предсказывает мозговую активность
ИИ-обзоры простыми словами
Каждый день читаем свежие статьи об ИИ и пересказываем главное естественным языком — без хайпа и воды. Если хотите понимать, куда движутся ИИ-агенты раньше остальных, — подписывайтесь.
Новые обзоры — каждый день
В Telegram