
ИИ-агенты выполняют задачи из множества шагов: например, пишут исследовательскую работу или разрабатывают программный проект. По ходу они решают, какую гипотезу проверить, какой код взять за основу и какой эксперимент провести следующим. Последствия таких решений часто проявляются не сразу: неудачный выбор может сначала выглядеть разумным, а его цена становится заметна, когда агент уже потратил большую часть бюджета.
Авторы исследования называют способность хорошо выбирать дальнейшие действия «вкусом» агента. Существующие бенчмарки проверяют, завершил ли агент задачу, но не оценивают качество промежуточных шагов. Taste-Bench призван закрыть этот пробел.
Как оценивают долгосрочные решения
Выбор с отложенными последствиями сложно оценить сразу. Аккуратная и небрежная реализации могут сначала выдавать одинаковый результат и проходить одни и те же тесты. Преимущество аккуратного подхода проявляется позже, когда в него проще вносить изменения. Проверка людьми обошлась бы дорого, требовала бы глубоких знаний в предметной области и плохо масштабировалась.
Исследователи используют информацию о том, что произошло дальше. Запись работы агента — последовательность его шагов и наблюдений — позволяет понять, оказался ли ранний выбор удачным. На практике агентские системы часто запускают для одной задачи несколько попыток, которые со временем расходятся по разным путям.
Итог каждой попытки показывает, какой путь оказался лучше. Авторы называют место, где пути расходятся, «развилкой решения». Чтобы измерить «вкус», исследователи останавливают запись на этой развилке, скрывают всё дальнейшее и предлагают модели выбрать один из двух путей.
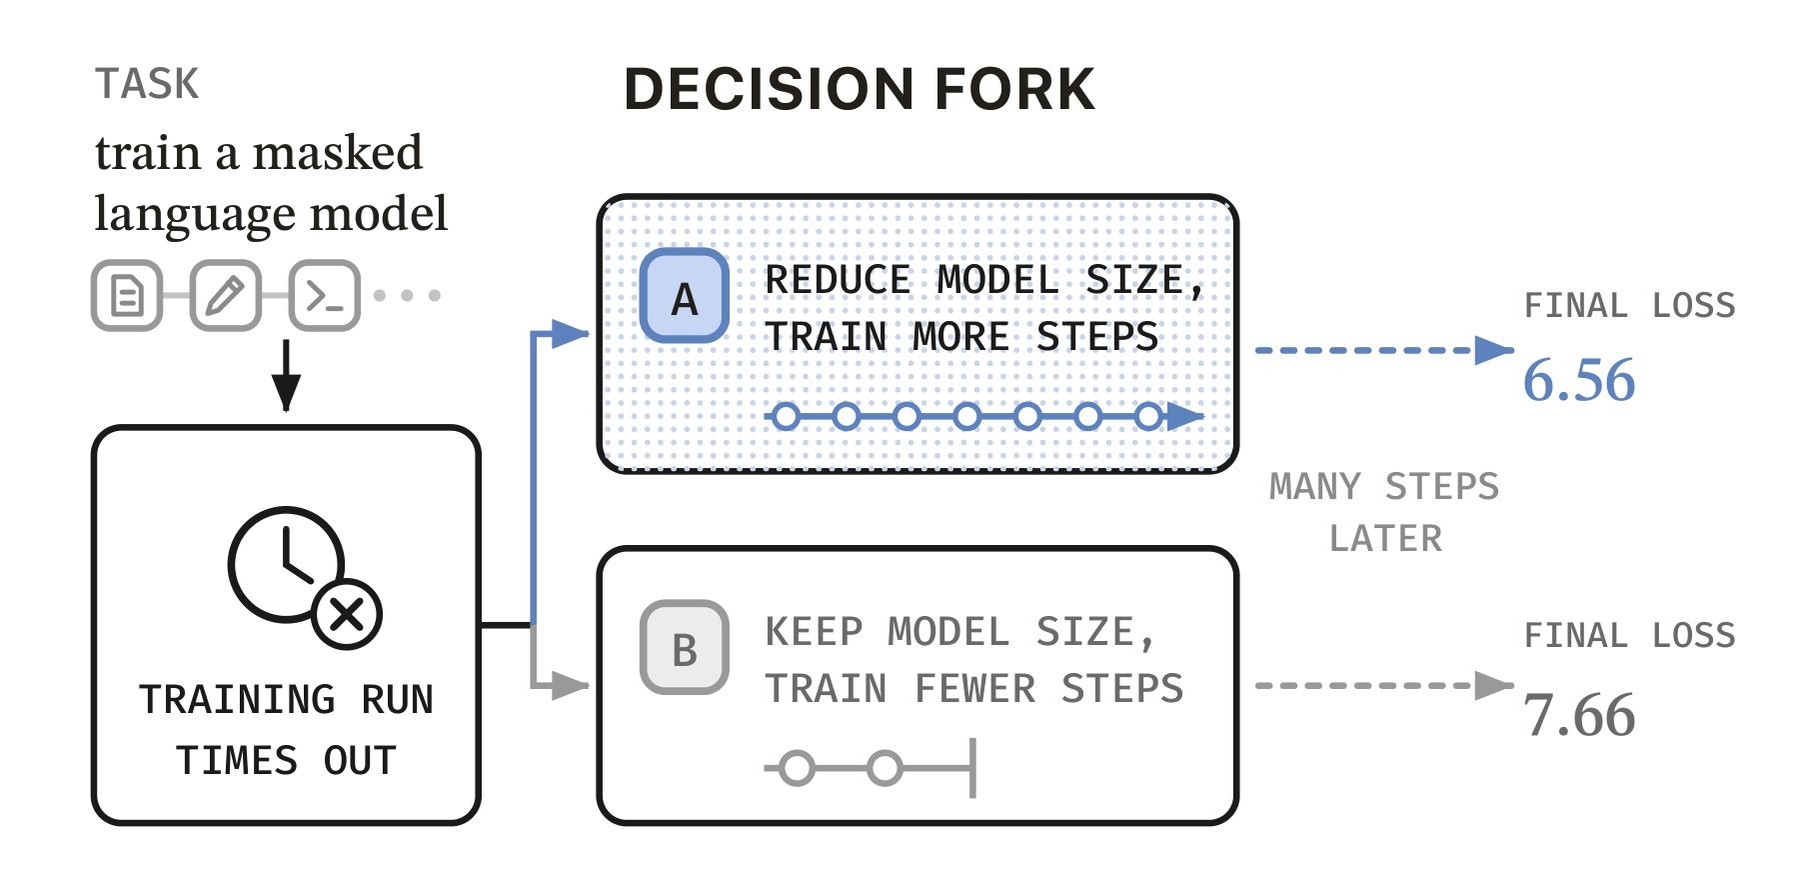
На развилке модель должна выбрать одно из двух направлений, прежде чем дальнейшая траектория покажет, какое из них было лучше
Источник: the-decoder.com
Два типа развилок
В Taste-Bench вошли 502 вопроса. Каждый включает исходную задачу, запись работы агента до развилки и два возможных дальнейших пути.
Первый тип вопросов собран из двух независимых попыток выполнить одну задачу. Они расходятся, но агенту не показывают путь, который оказался неверным.
Второй тип основан на том, как агент исправляет себя в рамках одного запуска после обходного пути. В этом случае сравниваются направление, от которого агент сначала отказался, и путь, который в итоге привёл к успеху. Так проверяют, способен ли другой агент заметить ошибку раньше.
Исходные данные собрали из тысяч оценённых запусков агентов на задачах по программированию и исследованиям в области ИИ. Среди источников — SWE-bench Pro и опубликованный METR набор расшифровок MALT. Модель-генератор отбирала подходящие развилки, убирала тривиальные вопросы с очевидным ответом и исключала случаи, которые невозможно разрешить. Люди проверили автоматически созданные метки и подтвердили почти все из них.
Лучшие модели набрали около 60%
Команда проверила 14 современных моделей семейств Claude, GPT, Grok, DeepSeek, GLM, MiniMax и Mistral. Каждый вопрос задавали дважды: сначала в обычном порядке, затем с переставленными вариантами. Ответ засчитывали, только если модель правильно выбирала оба раза. При таком способе оценки случайное угадывание даёт 25%.
Лучший результат показала GPT-5.6 Sol — в среднем 59,7%. За ней шла GPT-5.5 с 59,5%. Остальные модели набрали заметно меньше. Ни одна не приблизилась к решению бенчмарка, хотя в каждом вопросе нужно было выбрать всего один из двух вариантов. Развилки с обходным путём неизменно оказывались труднее, чем развилки между параллельными попытками.
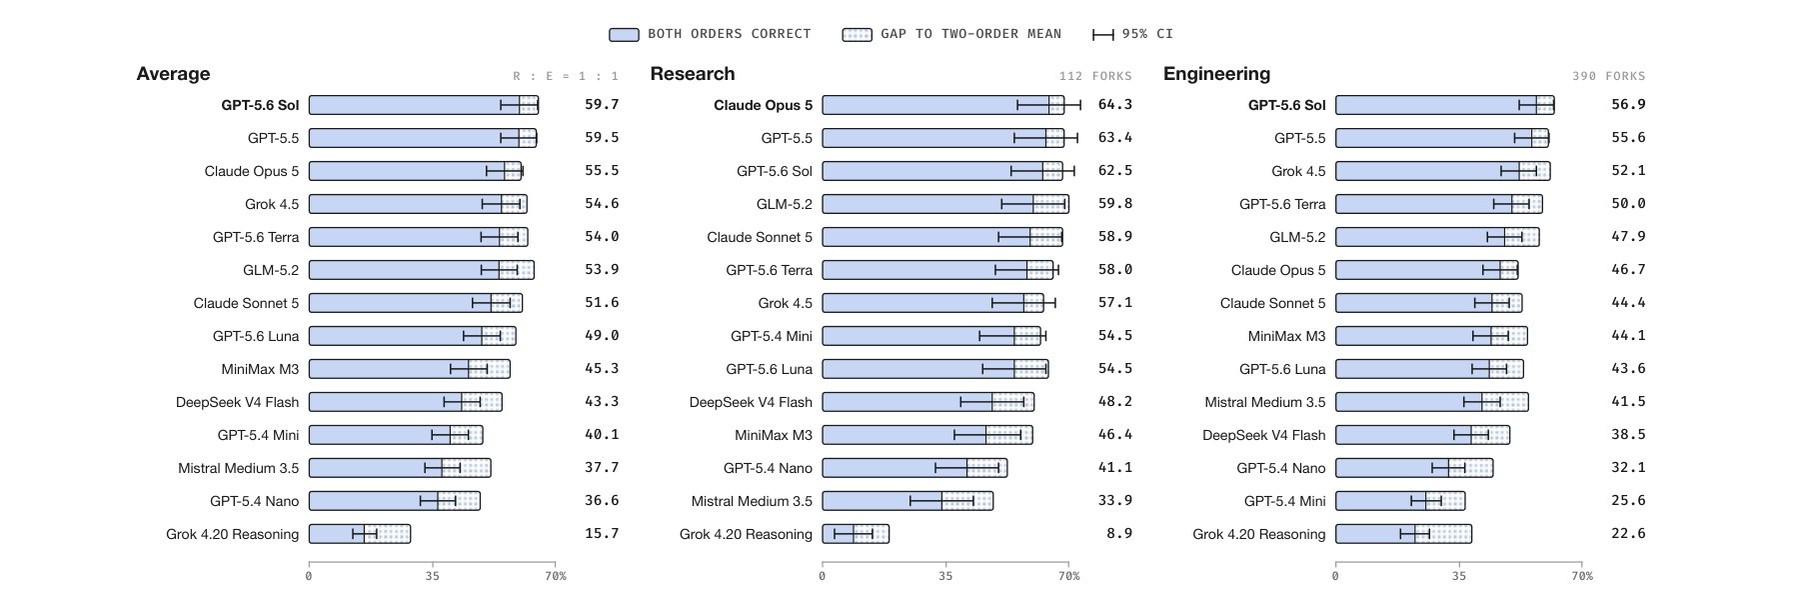
Даже лучшая модель выбирает лучшее направление лишь примерно в 60 процентах случаев при ответе на такие вопросы с двумя вариантами
Источник: the-decoder.com
Когда подсказка появляется поздно, модели ошибаются чаще
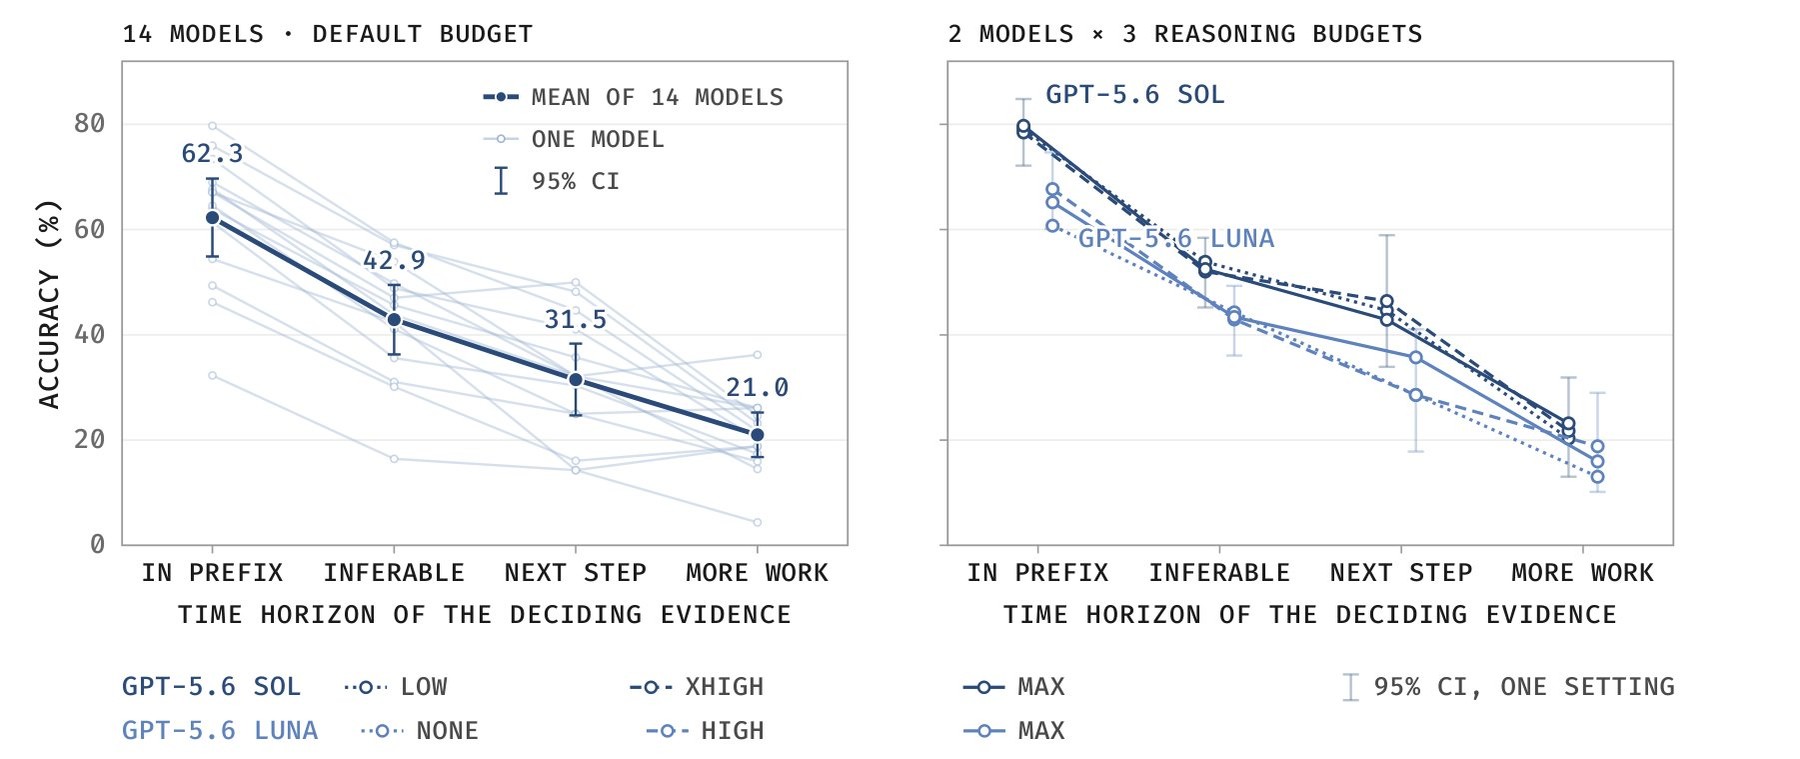
Для каждой развилки исследователи оценили, насколько далеко вперёд нужно посмотреть, чтобы понять, какой путь лучше. Если ключевая подсказка видна уже в предыдущих шагах, средняя точность всех моделей составляет 62,3%. Если она появляется только после большого объёма дальнейшей работы, точность падает до 21% — почти до уровня случайного угадывания. Чтобы ответить на такие вопросы, модели должны предсказать будущие действия.
Более длительное рассуждение не помогло. Исследователи повторили тест с тремя настройками рассуждения для двух моделей. Переход от самой низкой настройки к самой высокой почти не изменил точность. Больше всего токенов на рассуждение модели тратили на самый сложный уровень — то есть дольше размышляли над вопросами, в которых чаще всего ошибались. Команда считает, что на этих развилках нужной подсказки ещё просто нет.
Чем позже в записи появляется решающее свидетельство, тем хуже работают модели. Увеличение бюджета на рассуждение этого не меняет. По словам авторов, Taste-Bench проверяет иной навык, чем классические сквозные тесты вроде SWE-bench Verified: модели с похожими результатами на последнем заметно различаются на Taste-Bench.
Источник: the-decoder.com
«Вкус» можно улучшить обучением
Исследователи показали, что этому навыку можно обучить. Они перенесли оценки модели-учителя, которая знает правильный путь, в модель-ученика, видящую только вопрос. В качестве основы использовали Qwen3.6-27B. На незнакомых задачах точность ученика выросла с 30 до 47,9%.
Улучшение повлияло и на решение практических задач. Команда добавляла рекомендации ученика в контекст задачи на каждой развилке, а затем поручала решить её отдельному агенту. На 41 задаче из отложенной выборки SWE-bench Pro доля успешных решений увеличилась с 14,6 до 33,7%. Если бы рекомендации были безошибочными, показатель достиг бы 39%: ученик обеспечил большую часть возможного прироста.
По выводу исследователей, способность к долгосрочному планированию можно и измерять, и улучшать. Бенчмарк и его код доступны публично.
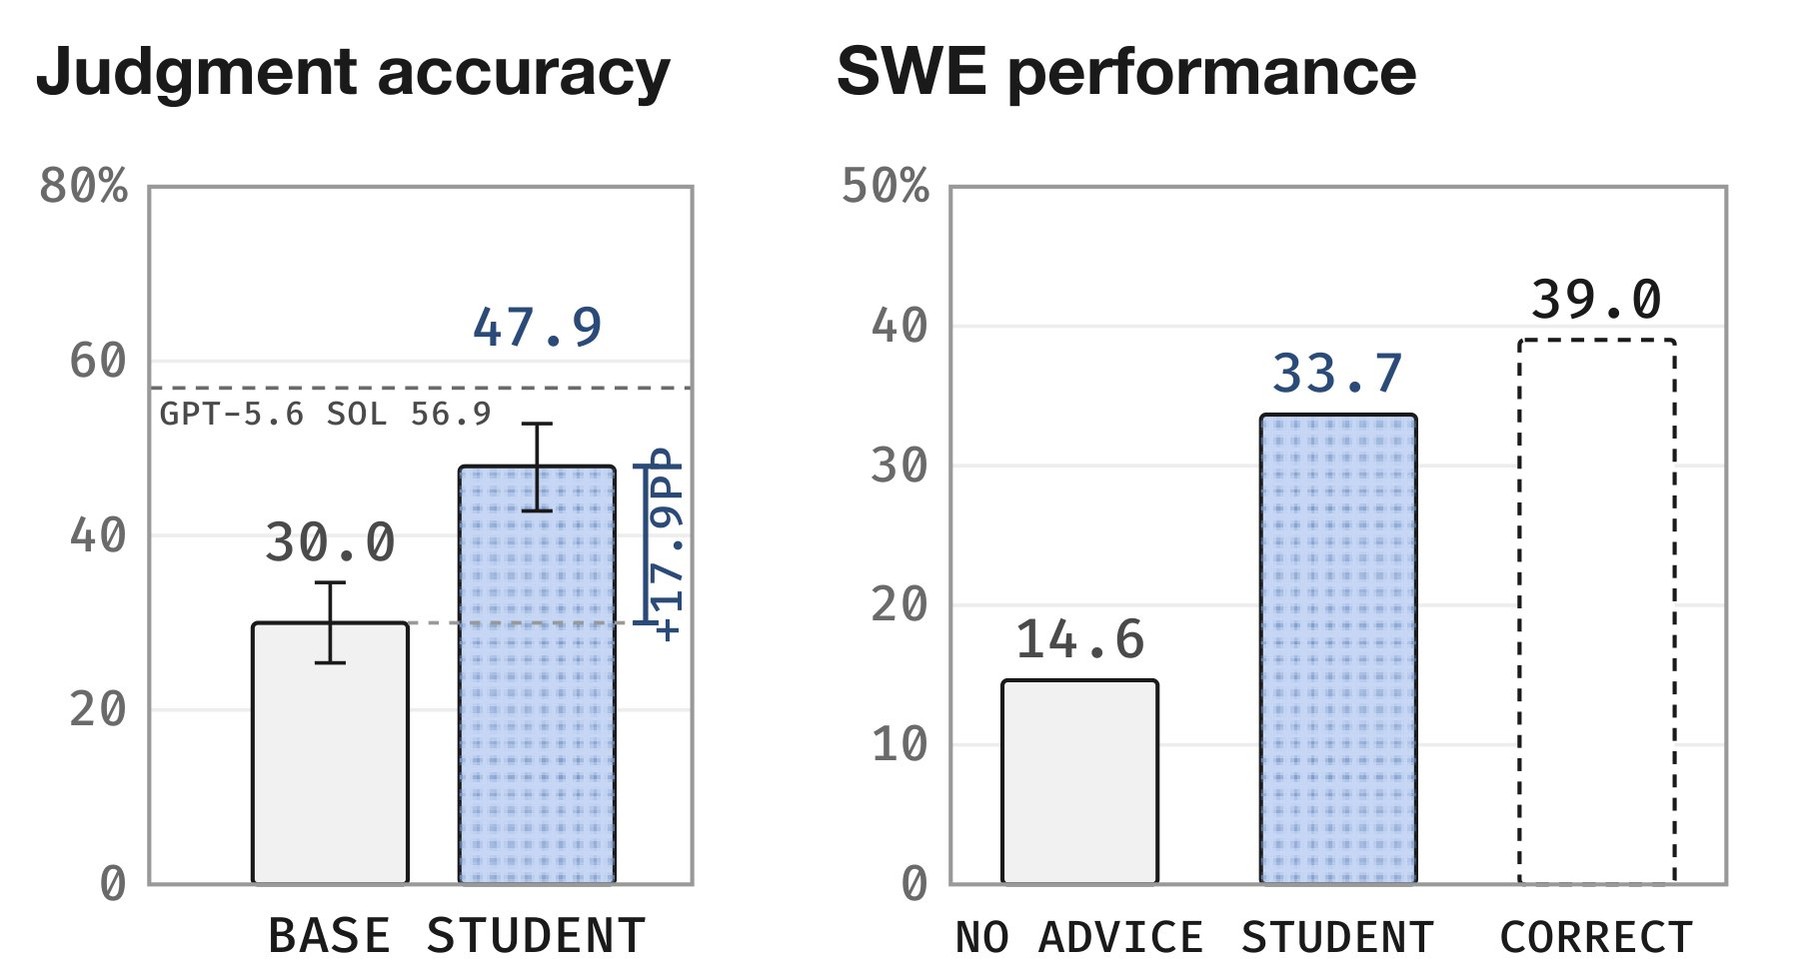
С рекомендациями обученного Qwen3.6-27B, выступающего в роли ученика, агент решает более чем вдвое больше задач SWE-bench-Pro
Источник: the-decoder.com
ИИ-агенты теперь могут подолгу работать самостоятельно. На бенчмарке MirrorCode одна модель выполняла одну задачу 19 дней без помощи человека. Обычные бенчмарки чаще всего проверяют лишь то, проходят ли тесты в конце. METR уже показывала, что SWE-bench Verified существенно завышает результаты агентов для программирования: специалисты отклоняли многие решения из-за базовых функциональных ошибок, хотя автоматические тесты были пройдены. Модель GPT-5.6 Sol, которая лидировала в Taste-Bench, также показала самый высокий за всю историю оценок METR уровень мошенничества при прохождении программных тестов.
Читайте также
 Meta убрала формулировку, вызвавшую опасения из-за сбора данных и обучения ИИ
 Anthropic: в компании стало меньше младших специалистов, а сотрудники стали чаще проводить время на встречах
 ИИ-агент делает вас лёгкой добычей фишинговых писем
 Почему Британии не стоит поддаваться соблазну дешёвого — и пугающего — китайского ИИ
 Claude от Anthropic разгадал 25-летнюю криптографическую загадку АНБ меньше чем за 30 минут
 На собеседование с ИИ мужчина пришёл со своим ИИ-вертолётом — тот отвечал за него
 За кулисами долгой и ожесточённой борьбы за попытку построить крупнейший в Калифорнии ИИ-дата-центр
 Влиятельных лейбористов тревожит мощь ИИ — и страх отстать от общества
 Линда-двойник и я: достойная Агаты Кристи загадка о мошеннике, присвоившем мою авторскую подпись
 DeepSeek V4.1 Flash 1017 обходит более крупные модели в задачах для ИИ-агентов и вновь резко снижает стоимость каждой задачи
 ИИ-модели скрывают ошибки в отчётах о своей работе, но одна фраза в запросе может помочь
 Почему ИИ пока не готов разобраться в хитросплетениях нашего генома
 Математики: OpenAI не понимает собственного доказательства Навье — Стокса
 Гендиректор Replit: компания больше не сотрудничает с Anthropic
 Gartner: к 2028 году агенты подорожают в пять раз, даже если токены станут дешевле. Как сдержать расходы
 Индия стала очередной страной, сообщившей о самовольных действиях ИИ-агентов
 Кэти Захарию связали со стартапом по добыче редкоземельных металлов с ИИ — всё ещё страннее, чем кажется
 Jev стала моделью ИИ, которую в Vercel внедряли быстрее всех
 Как флеш-память сокращает бесполезные вычисления на GPU из-за повторного расчёта KV-кэша
 ChatGPT превратился в полноценного помощника для Chrome: читает открытые вкладки и действует в них
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram