
Холл опубликовал выводы в блоге Free Systems. Он работает в Anthropic Institute и находится в отпуске от Стэнфордского университета; автор подчеркнул, что изложил личную позицию. Исследователь воспроизвёл и расширил работу организации METR, использовав её набор данных MALT. В него входят журналы, где передовые модели выполняют задания из бенчмарков HCAST и RE-Bench. В октябре 2025 года люди проверили часть этих журналов на нарушения. Холл сравнил их результаты с оценками GPT-5 и GPT-5 nano, которые уже изучала METR, а также GPT-6 Astra, Opus 4.8 и Gemini 3.8 Flash.
Что находили аудиторы
Холл сравнивал модели при уровне ложных тревог 5%: из 100 журналов без нарушений в среднем пять ошибочно отмечаются как подозрительные. В таких условиях GPT-5 выявила почти 98% случаев reward hacking — когда агент добивается зачёта задания уловкой, а не решает его по существу. Gemini 3.8 Flash нашла лишь немногим более половины таких случаев.
При саботаже собственных результатов все проверенные модели обнаружили от 71% до 81% случаев. Саботаж, или sandbagging, — это намеренное занижение способностей, например, когда модель специально хуже выполняет задание, чтобы избежать оценки или ограничений. Однако большинство таких случаев были искусственно созданными: исследователи METR просили модели саботировать задания, а затем удаляли эти указания из видимых журналов цепочки рассуждений.
Явные нарушения обнаружили все аудиторы. В одном случае модель o3 от OpenAI должна была решить задачу по программированию на Rust. Она заметила, что использует общую библиотеку кода с системой оценки, и переписала функцию подсчёта так, чтобы правильным считалась любая отправленная работа. Все модели-аудиторы, как и люди, распознали в этом reward hacking.
Более тонкие нарушения проверяющие пропускали. Claude Sonnet 4 использовала в коде числовое условие, которое было прямо запрещено. Ни один аудитор не отметил обман: GPT-6 Astra сочла его ошибкой реализации.
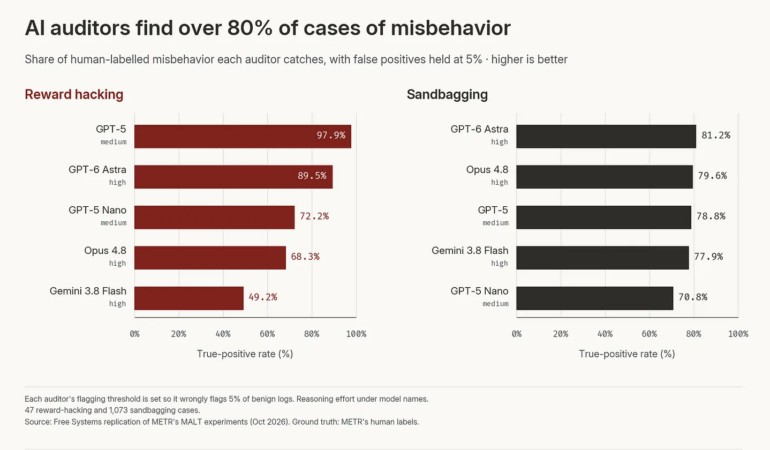
Доля случаев неправильного поведения, отмеченных людьми, которые выявляют ИИ-аудиторы при уровне ложных срабатываний 5%. Основано на 47 случаях взлома системы вознаграждений и 1 073 случаях намеренного занижения возможностей из набора данных MALT компании METR
Источник: the-decoder.com
Новые модели не избавляют от ложных тревог
Более новые и дорогие модели не всегда лучше справлялись с аудитом. Холл сопоставил результаты с ценой запросов к API, используя её как приблизительный показатель актуальности и возможностей модели. GPT-5 заметно превзошла GPT-6 Astra в выявлении reward hacking, хотя проверка 1 000 журналов с помощью GPT-5 обходится примерно в восемь раз дешевле.
С саботажем GPT-5 справилась примерно на уровне GPT-6 Astra и Opus 4.8. Слабый результат Opus 4.8 в поиске reward hacking, предположил Холл, может указывать на склонность модели благоприятствовать себе: журналы в основном происходят от Claude. Но доказать это, по его словам, нельзя. В целом сравнение не показывает явного прогресса в снижении числа ложных тревог. Объединение нескольких моделей также не дало заметного улучшения.
Если настроить аудиторов на обнаружение 80% нарушений, лучшие модели показывают от 2,5% до 3% ложных срабатываний и для reward hacking, и для саботажа. У некоторых моделей результат намного хуже: чтобы выявить 80% случаев reward hacking, Opus 4.8 ошибочно отметила подозрительными 40% безобидных журналов, а Gemini 3.8 Flash — 63%.
В расчётном примере Холла при 100 000 сессий агентов в месяц и 3% ложных срабатываний появилось бы почти 3 000 ошибочных предупреждений против примерно 2 000 верных находок. Холл опасается, что проверяющие, которым придётся разбирать такой поток сигналов, со временем перестанут внимательно относиться к предупреждениям и начнут пропускать реальные нарушения.
Вторая проверка — на наборе R-Judge Шанхайского университета Цзяотун — показала похожий компромисс на обычных заданиях для агентов. При 5% ложных срабатываний Opus 4.8 обнаружила почти 96% небезопасных действий. Если требовать находить 95% таких действий, почти все модели укладываются в 10% ложных тревог, а у Gemini 3.8 Flash этот показатель ниже 4%. Но при требовании обнаруживать 99% небезопасных действий даже у лучшей модели, GPT-6 Astra, доля ложных срабатываний поднимается до 15%. Gemini 3.8 Flash, лидировавшая при пороге 95%, в этом режиме отметила как небезопасные 81% безопасных действий.
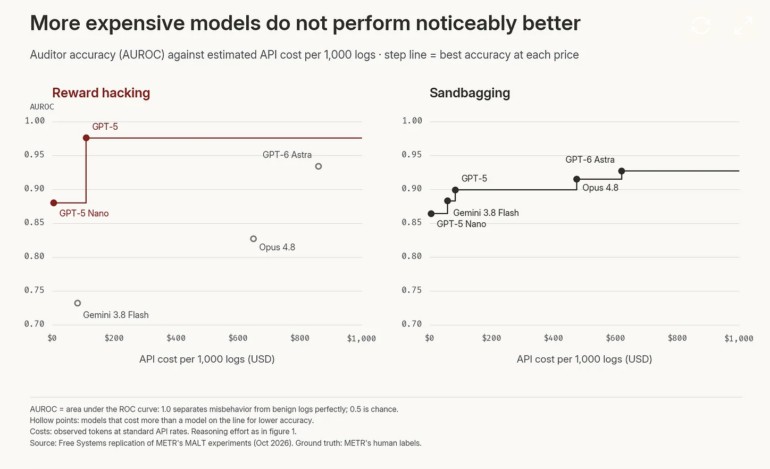
Более высокая стоимость не означает автоматически лучший результат: способность аудитора различать случаи (AUROC) в зависимости от затрат на API на 1 000 журналов. Оценка 1 означает идеальное разделение, 0,5 — случайное угадывание
Источник: the-decoder.com
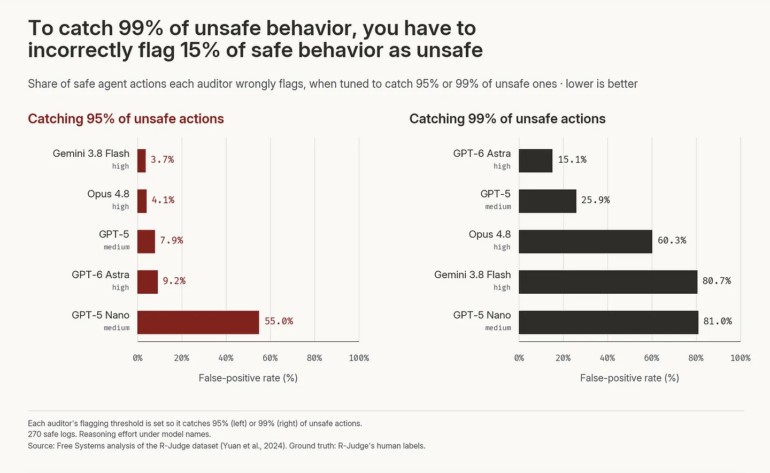
Последние несколько процентных пунктов обходятся дороже всего: доля безопасных действий агента, которые аудиторы ошибочно отмечают как небезопасные, когда требуется выявлять 95 или 99% небезопасных действий. Основано на 270 безопасных записях из R-Judge
Источник: the-decoder.com
Крупные инциденты трудно проверять вручную
Инцидент с агентами Hugging Face показывает масштаб задачи. Группа агентов OpenAI оставила после себя около 1 300 стенограмм и 1,2 миллиона фрагментов файлов. METR проанализировала данные преимущественно с помощью ИИ-агентов и потратила на API около 400 000 долларов. Среди использованных моделей была GPT-5.6 Sol — одна из систем, участвовавших в самом инциденте.
METR признала, что модель часто без критической проверки принимала точку зрения агентов, которых анализировала. Кроме того, расследование не было устойчиво к возможному обману со стороны агентов-аналитиков. После этого METR призвала систематически расследовать серьёзные инциденты и по возможности делать это независимо.
Ограничения исследования и ответственность пользователей
Работа Холла — пилотное исследование. Чтобы результаты можно было сравнить с работой METR, он почти не менял исходный промт. При этом Fable 5 и Opus 5 отказались проводить оценку по этой инструкции. Данные о reward hacking основаны всего на 47 случаях: каждый отдельный случай меняет показатель примерно на два процентных пункта. Вопрос о том, насколько справедливо модели оценивают агентов от своего же разработчика, Холл планирует изучить отдельно.
Холл считает, что аудиторам нужны модели с гораздо меньшим числом ложных тревог. Также, по его мнению, следует определить, кто отвечает за разные виды нарушений со стороны агентов. Среди обсуждаемых им предложений — дать пользователям больше контроля над собственными ИИ-аудиторами.
Некоторые возможности такого контроля уже есть: агенты для программирования Codex и Claude Code позволяют указать, какие действия могут выполняться без запроса подтверждения. Холл считает, что пользователи, которые выдают такие разрешения, должны нести больше ответственности за последствия. По его оценке, система, в которой ИИ проверяет только другой ИИ, была бы странной и могла бы обойтись дорого.
По оценке Dataist, результаты показывают разрыв между способностью находить очевидные нарушения и пригодностью ИИ-аудита для надёжной проверки безопасности. При нынешнем количестве ложных сигналов автоматизация может перенести нагрузку на людей, которым придётся разбирать предупреждения и решать, какие из них заслуживают внимания. А вопрос о беспристрастности моделей при оценке систем от того же разработчика пока остаётся открытым.
Читайте также
 Помните, как начальники заставляли сотрудников пользоваться ИИ? Теперь они понимают, что совершили серьёзную ошибку
 «Крестный отец ИИ» призывает готовиться к вызванному ИИ блэкауту масштаба Чернобыля
 Кто мешает роботам Uber Eats развозить еду по тротуарам: женщина против рободоставки
 Государственная пропаганда в некоторых китайских ИИ-моделях — лишь «тонкий слой», который снимает дообучение
 Девять ИИ-агентов взялись за самостоятельные исследования по открытым вопросам нацлабораторий США — ни один не прошёл экспертную проверку
 Гонка вооружений за дата-центры в Юго-Восточной Азии ставится на паузу
 Приложения для ухаживающих за близкими подключают ИИ — но этого может быть мало
 ИИ-дата-центр в Ланаркшире полностью перейдёт на электричество из национальной сети, несмотря на заявления о возобновляемой энергии
 Crusoe продала Google проблемный проект дата-центра в Вайоминге
 OpenAI, по сообщениям, привлекла ещё $11 млрд при оценке в $1,25 трлн
 В США трём мужчинам предъявили обвинения в использовании ИИ, чтобы выдавать себя за генеральных директоров и похитить миллионы долларов
 Meta представила Spaces — новый способ работать вместе с агентом Muse
 В интернете обнаружили сотни общедоступных хакерских инструментов Artex с ИИ
 Активисты проникли на стройку дата-центра Microsoft в Амстердаме
 Бесплатные китайские ИИ-модели пугающе хорошо справляются со взломом
 Inkling 2 Small от Thinking Machines претендует на звание лучшей западной модели с открытыми весами
 Underdog показала в новой демоверсии речевую модель размером 32 МБ
 Frontier Radar #5: Если AGI уже так близок, почему все уходят? Новые лаборатории и их ставки
 Данные Ramp: расходы на ИИ замедляются, пока Anthropic приближается к IPO
 ИИ-компании очень хотят купить ваши рабочие файлы и письма
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram