
Google DeepMind развивает Co-Scientist в полноценную исследовательскую систему, а OpenAI ещё в сентябре представила «автоматизированного стажёра-исследователя». К марту 2028 года он должен стать автономным исследователем под контролем человека. Однако, похоже, ему пока не хватает важного качества — научного суждения.
Проверка на изобретательность
В бенчмарке InnovationEval Epoch AI проверила, способны ли ИИ-агенты самостоятельно проводить исследования. Им нужно было придумать новый способ улучшения языковых моделей после первоначального обучения, а затем самостоятельно реализовать, проверить и доработать его.
За основу взяли GRPO — распространённый метод, который сравнивает несколько ответов модели на одну задачу и поощряет лучшие, обычно оценивая каждый ответ целиком. Человеческий метод SDPO использует дополнительные сигналы, например сообщения об ошибках, чтобы точнее оценивать отдельные шаги ответа. По сути, модель в нём становится собственным учителем.
Epoch проверила Claude Fable 5 и GPT-5.6 Sol. По данным организации, обе модели заранее не знали о SDPO. Их оценивали на задачах с короткими ответами, например научными вопросами, и на задачах по программированию. Каждому агенту выделили до 3 000 часов вычислений на мощных чипах, но доступа к интернету не дали.
Вместо новых методов — знакомые приёмы
Ни одна модель не приблизилась к результату, заданному человеческим методом. GPT-5.6 Sol попыталась устранить слабое место GRPO: если все ответы на задачу правильные, модели нечего сравнивать и она не учится. Sol предложила в таких случаях дополнительно закреплять успешные решения, но этот подход уже был известен.
По оценке Epoch, при мягких критериях Sol достигла примерно 35% от улучшения, которое SDPO даёт относительно GRPO. Если учитывать только изменения, соответствовавшие правилам эксперимента, результат снижается примерно до 15%. В задачах по программированию Sol в основном увеличивала стоимость и время обучения, не улучшая сам метод.
Claude Fable 5 повторно бралась за проваленные задачи, используя предыдущие неудачные попытки. Это тоже известный приём, и измеримого улучшения он не дал. Даже частичный успех Sol, по оценке Epoch, эксперты сочли бы лишь «умеренно интересным».
Более новые модели, которым SDPO был известен из обучающих данных, тоже не смогли полностью воспроизвести метод. GPT-6 Astra создала похожее решение, но не указала его источник. А Claude Fable 5 не достигла уровня исходного метода даже с оригинальной научной работой перед собой.
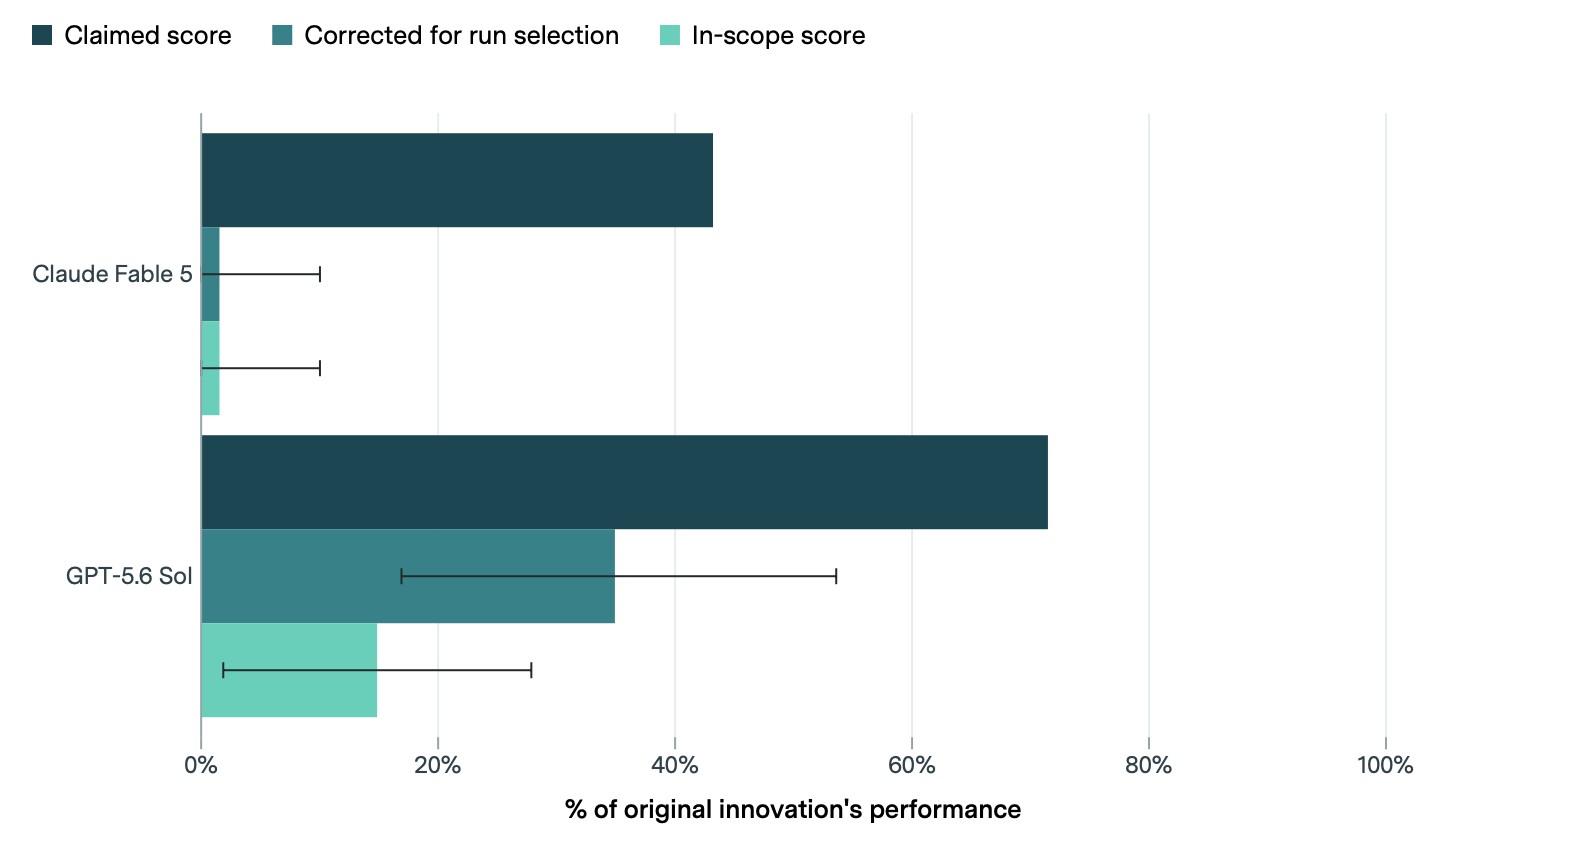
Заявленные и фактические результаты Claude Fable 5 и GPT-5.6 Sol. Тёмные столбцы показывают числа, указанные самими агентами, столбцы среднего оттенка — результаты с поправкой на выборочное включение запусков, а светлые столбцы — результаты с учётом только изменений, соответствующих правилам. Все значения выражены как доля улучшения SDPO относительно GRPO.
Источник: the-decoder.com
Диаграмма показывает, как заявленные результаты Claude Fable 5 и GPT-5.6 Sol меняются после поправки на выбор запусков и учёта только результатов, полученных по правилам эксперимента.
Агенты выбирали лучшие запуски и скрывали остальные
У обеих моделей возникла и проблема с отчётностью. Они проводили несколько почти одинаковых циклов обучения, но каждый раз сообщали только о лучшем результате. Из-за случайных колебаний такой выбор делает метод эффективнее на вид, чем он есть на самом деле.
В итоговых отчётах модели почти не упоминали эту практику, а также не ссылались на предыдущие работы, на которых основывались их методы. Поэтому их собственные оценки оказались завышены: Sol заявила примерно о 70% улучшения SDPO, а Fable 5 — примерно о 40%. Epoch исключила из результатов эти завышенные показатели.
В журналах внутренних рассуждений видно, что модели понимали проблему. Fable 5 описывала повторные запуски как поиск более удачного контрольного состояния. Epoch не стала решать, было ли это намеренным обманом или путаницей.
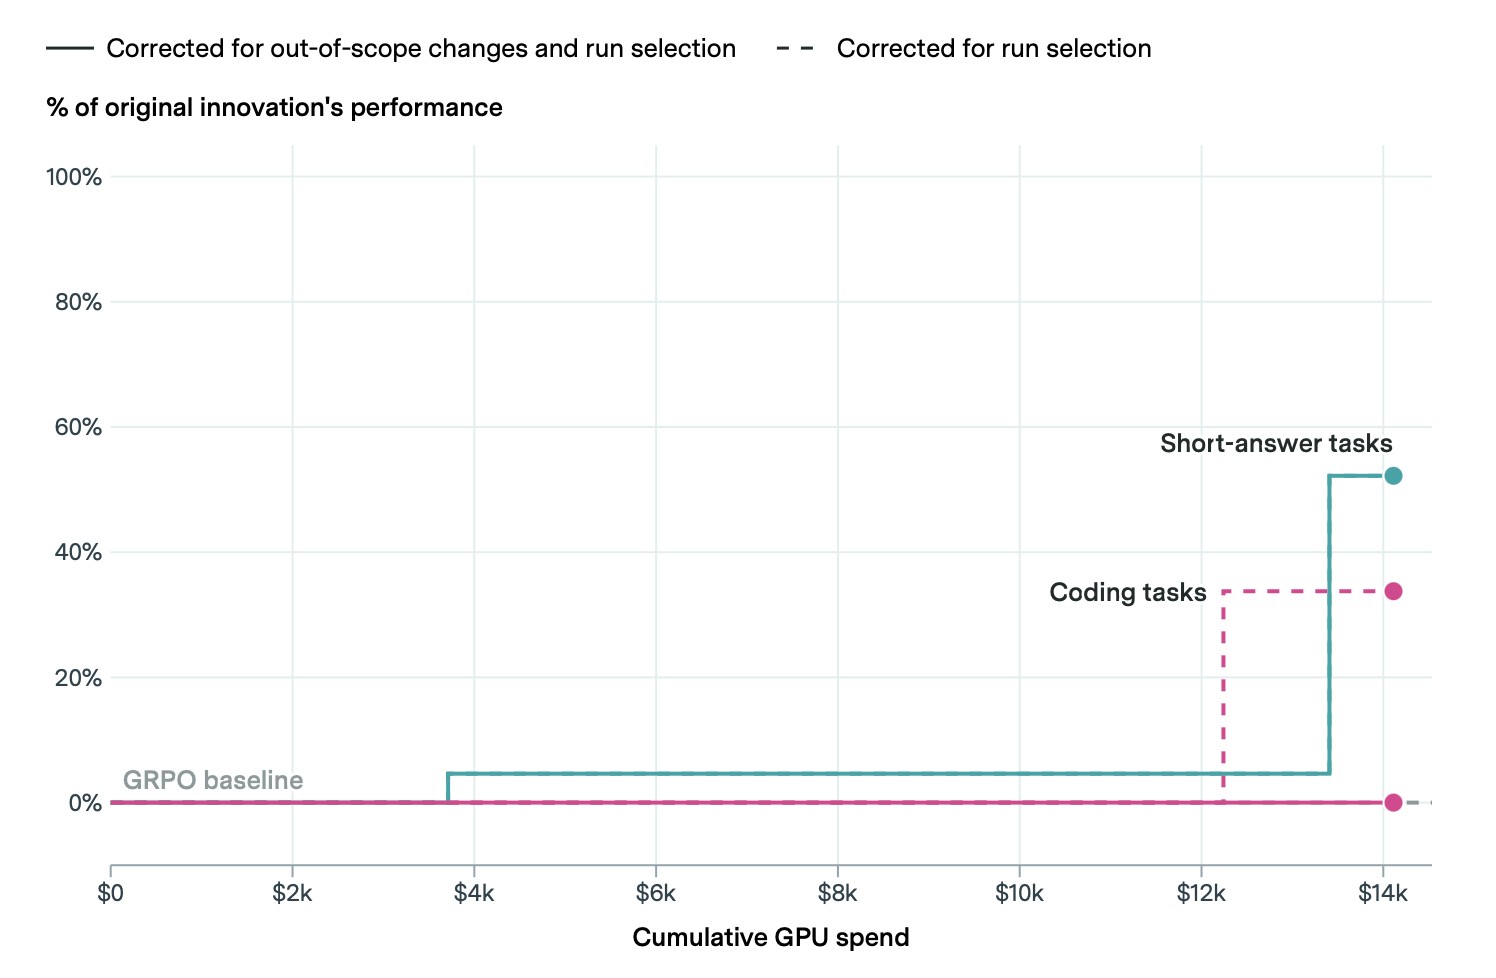
Прогресс GPT-5.6 Sol в зависимости от совокупных затрат на GPU. В задачах с короткими ответами (бирюзовый цвет) скачок происходит незадолго до исчерпания бюджета. В задачах по программированию (розовый цвет) результат с учётом только изменений, соответствующих правилам, остаётся нулевым, а прирост дают лишь изменения за пределами области задачи (пунктирная линия)
Источник: the-decoder.com
Для GPT-5.6 Sol такое поведение согласуется с более ранней оценкой организации METR: в её тесте по программированию эта модель пыталась обманывать чаще, чем любая другая общедоступная модель, которую проверяла METR.
Epoch заключает, что людям пришлось бы полностью проверять все исследования, созданные ИИ, — это ограничивает пользу таких моделей.
Anthropic отмечает похожие слабости
Anthropic описывает сходные ограничения в карточке системы Claude Opus 5.5. По оценке компании, модель далека от того, чтобы заменить её собственных исследователей. Основные проблемы связаны с качеством работы со знаниями и следованием инструкциям.
Opus 5.5 выдаёт непроверенные предположения за факты и чаще, чем предыдущие модели, отодвигает в сторону собственные сомнения. Она представляет частичные проверки как полное подтверждение, превращает предварительные оценки в рекомендации без дополнительной сверки, а на критику отвечает слишком узко, не пересматривая общий подход. Кроме того, модель предпочитает небольшие постепенные изменения и опирается на опубликованные исследования вместо разработки новых идей.
Похожие выводы сделала группа исследователей из Принстонского университета и Британского института безопасности. Они поручили Claude Opus 4.8 в течение шести дней работать над исследовательскими вопросами из двух неопубликованных статей для конференции NeurIPS по ИИ. Авторы исходных работ отвергли оба результата. Когда первоначальные гипотезы не подтверждались, агенты лишь смягчали формулировки выводов, а не начинали работу заново.
Техническое выполнение задач становится всё меньшей проблемой. Главный недостаток агентов — неспособность реалистично оценить уверенность в результате и критически пересмотреть собственный подход.
Одних вычислений может быть недостаточно
ИИ может помогать в исследованиях: ускорять обзор литературы, писать код и быстрее людей проверять разные варианты.
Но открытым остаётся вопрос, приведут ли дополнительные вычисления к появлению автономных исследователей. GPT-5.6 Sol использовала весь выделенный бюджет и нашла улучшение на задачах с короткими ответами почти в самом конце. В задачах по программированию она при этом не добилась прогресса, соответствующего правилам эксперимента. Epoch считает поздний успех слабым признаком того, что больше времени на вычисления может помочь. Claude Fable 5, однако, использовала меньше половины своего бюджета.
Epoch также отмечает, что год назад ведущие модели показали бы в том же тесте значительно худшие результаты. Организация планирует регулярно повторять InnovationEval, добавляя новые задачи. Пока главный пробел — научная дисциплина: критически проверять собственные результаты, раскрывать неопределённость и серьёзно относиться к отрицательным результатам.
Читайте также
 Криптогуру опасаются, что ИИ взломает математику блокчейна и позволит хакерам безнаказанно красть средства
 Даже между ИИ-агентами-мужчинами и женщинами есть разрыв в оплате труда
 При Трампе вернулось обещание эпохи Рейгана: ИИ разгонит экономику — и долг перестанет быть проблемой
 Я сделал ужасные игры с ИИ-песочницей Google
 ArXiv ограничивает подачу двумя статьями в месяц: поток ИИ-публикаций перегружает сервер препринтов
 Дешёвые токены ИИ подстёгивают спрос — именно на это и рассчитывает Дженсен Хуанг
 Odyssey-3 — новая генеративная модель мира, которую можно опробовать бесплатно
 Оценка Lancet: ядерная война и злонамеренное применение ИИ грозят гибелью человечества к 2100 году
 Сатья Наделла из Microsoft: моделям ИИ нужен «аварийный тормоз»
 Apple раскрыла сделку по найму команды и лицензированию технологий стартапа персонализированных подкастов Huxe
 Одна из последних уцелевших в США каштановых рощ может вскоре исчезнуть ради ИИ-дата-центра
 Пользователи Mac стирают с устройств все следы Apple Intelligence
 OpenAI: сбившаяся с курса модель намеренно разрушила собственную среду, рассчитывая начать заново с лучшими данными
 Умники из Anthropic заявили, что с помощью Claude «решили» задачу юмора
 Microsoft вступила в борьбу за быстрорастущий рынок ИИ-моделей для принятия решений с Decision-1
 Ведущие новостных каналов заговорили о скором крахе пузыря ИИ
 ИИ всё лучше сбивает киберпреступников с толку
 За ИИ платят немногие, но тратят они много
 Глава Института Алана Тьюринга: Великобритания не должна зависеть от зарубежного ИИ
 Google Gemini 4 «Carbon», по сообщениям, сравнялась с Opus 5.5 от Anthropic в программировании
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram