i
ДАТАИСТ
К ленте

Поиск и RAG

Retrieval-augmented generation и глубокие исследования: как подсунуть модели нужные знания в нужный момент.

8 материалов

Google утверждает, что EmbeddingGemma 2 превосходит конкурентов вдвое крупнее по размеру

Google представила EmbeddingGemma 2 — открытую модель, которая превращает текст, изображения, видео, аудио и код в числовые векторы. Так проще находить похожий контент и сравнивать его. В модели 740 млн параметров; Google утверждает, что это самая компактная модель такого типа и что на бенчмарках мультимодальных эмбеддингов она превосходит конкурирующие модели размером до двух раз больше.
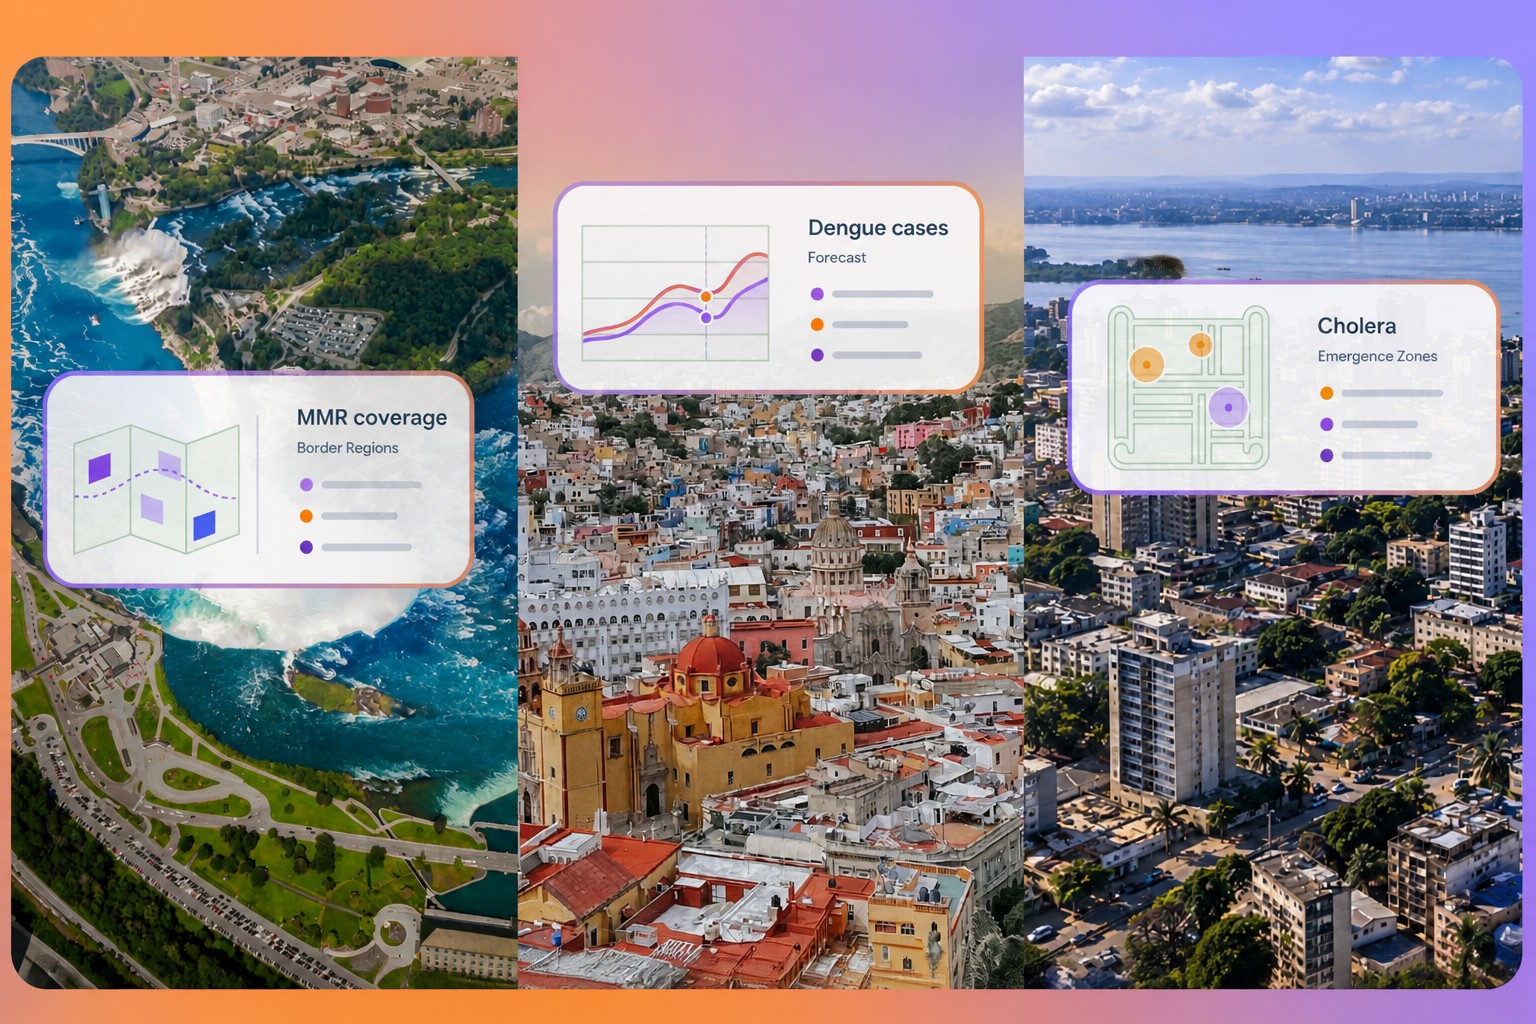
Google Research раскрыла потенциал геопространственных моделей Earth AI для общественного здравоохранения во всём мире

Google Research проверила, могут ли геопространственные представления модели Population Dynamics Foundation Model (PDFM) помочь в задачах общественного здоровья. В пяти исследованиях с участием партнёров модель показала пользу для прогнозирования вспышек холеры и денге, оценки смертности от сердечно-сосудистых заболеваний, анализа вакцинации у границы США и Канады и выявления риска послеродовой депрессии. PDFM объединяет данные о поисковых запросах, мобильности людей, городской среде и погоде в ежемесячно обновляемые эмбеддинги мест. Их можно добавлять в уже существующие модели без дополнительного обучения под конкретную задачу.

Jev предлагает более дешёвый способ принимать решения с помощью ИИ

Во многих корпоративных ИИ-системах языковая модель не пишет текст и не общается с пользователем, а решает, куда направить обращение, подходит ли документ для RAG, выглядит ли транзакция подозрительной или какую модель выбрать для запроса. Такие решения часто получают, попросив модель сгенерировать текст, а затем превратив его в метку. Выпущенная TypeSafe AI 15 сентября в раннем доступе Jev отвечает иначе: получает состояние приложения и вопросы с заданными типами ответов, а возвращает варианты, оценки и ответы «да» или «нет» с вероятностями. По данным компании, ответ занимает 70–500 миллисекунд и стоит $0,042 за миллион входных токенов; выходные токены бесплатны. За несколько дней для Jev появились интеграции с платформами наблюдаемости и фреймворками ИИ-агентов, включая Pydantic AI и LangChain. TypeSafe пришлось приостановить очередь заявок, а многие стали пользоваться моделью через OpenRouter. На GitHub и Hugging Face тем временем начали появляться открытые альтернативы. Но сам подход старше Jev: это классификация.

Компании собирают RAG за дни. Но сделать его достаточно надёжным для бизнеса куда сложнее

Демо RAG — генерации с дополнением за счёт поиска — легко впечатляет: документы компании подключают к поиску, найденные фрагменты передают большой языковой модели, и та за секунды отвечает на вопрос, часто со ссылками на источники. Но когда система сталкивается с реальными данными, выясняется, что документы противоречат друг другу и устаревают, сведения спрятаны в таблицах и сканах, а доступ к ним зависит от прав сотрудников. Поиск, который работал на 10 000 документов, может вести себя иначе после роста базы. RAG остаётся практичным способом связать языковые модели с корпоративной информацией, но для надёжной работы нужны не только поиск и модель: важны качество и актуальность данных, безопасность, оценка результатов, стоимость и эксплуатация.

Обход узких мест инференса: Retrieve-for-Train ускоряет сложный ИИ-поиск

Исследователь-студент Пэнчэн Цзян и старший инженер-исследователь Джудит Юэ Ли из Google Research представили фреймворк Retrieve-for-Train для сложного поиска и рекомендаций. Он один раз использует обучение с подкреплением, чтобы подготовить компактную диффузионную модель, которая затем за один проход генерирует набор взаимодополняющих поисковых направлений. Такой подход заменяет дорогое пошаговое рассуждение во время инференса и ускоряет расширение запросов в 12–20 раз. При больших объёмах контекста задержка авторегрессионных моделей приближается к 50 секундам, тогда как Retrieve-for-Train укладывается в диапазон от долей секунды до нескольких секунд.

Непрозрачная рекуррентность и другие термины ИИ, которые вам стоит знать

ИИ меняет не только технологии, но и язык, которым их описывают. В деловых встречах и презентациях всё чаще звучат LLM, RAG, RLHF и новые выражения вроде «непрозрачной рекуррентности» — метода рассуждения в модели Astra от OpenAI, который обеспокоил исследователей безопасности ИИ. Ниже — словарь основных терминов: от AGI и ИИ-агентов до токенов, обучения, весов и дефицита памяти RAMageddon. Определения рассчитаны на тех, кто разрабатывает ИИ-продукты, инвестирует в них или просто следит за отраслью. Список регулярно обновляется вместе с развитием технологий.

Агентный RAG против модульного: что реально лучше на практике

RAG сегодня — один из самых практичных способов подключить LLM к внешним знаниям: модель не полагается только на собственную память, а сначала ищет нужные фрагменты в базе знаний и уже потом отвечает. В реальных продуктах это выглядит как спасение от галлюцинаций и устаревших фактов. Но у…

Глубокие исследования без границ: выбираем свою LLM и управляем стратегией поиска

Когда мы говорим о “глубоких исследованиях”, чаще всего имеем в виду сервисы, которые сами планируют поиск, бродят по источникам, собирают цитаты и выдают аккуратный отчет. Это удобно, но почти всегда жестко привязано к одной стратегии и одному семейству моделей. Авторы Universal Deep Research…