i
ДАТАИСТ
К ленте

Память и контекст

Что модель помнит между запросами и внутри одного: долговременная память, работа с длинным контекстом, забывание.

70 материалов

Huawei предлагает клиентам самим искать память для ИИ-чипов, фактически отдавая закупки на откуп чёрному рынку

Из-за санкций США и нехватки компонентов Huawei предлагает некоторым клиентам самостоятельно искать память для её новых ИИ-чипов — фактически на чёрном рынке. Контрабандисты обходят американские ограничения, отправляя в Китай через Гонконг партии памяти HBM вместе с маломощными серверными процессорами. За год цена одного модуля HBM3E на нелегальном рынке выросла до 4 000 долларов. Южнокорейская таможня сообщила о рекордном объёме незаконного экспорта микросхем и других стратегических товаров.
ChatGPT подсовывает избирателям нелепую дезинформацию накануне промежуточных выборов

Перед важными выборами в США ИИ-чат-боты с высокой уверенностью распространяют среди избирателей недостоверную политическую информацию. По данным The Washington Post, чат-боты ошибаются, когда пользователи просят составить путеводитель по выборам в Конгресс и местным кампаниям. Так, ChatGPT включил в памятку для жителя Миссури место в Сенате, которое не будет переизбираться, а в ответе для жителя Вайоминга представил участников муниципальных выборов как кандидатов на федеральные должности.

Сэм Альтман терпеть не может идею запускать собственные ИИ-модели дома и считает, что людям не стоит владеть компьютерами

Акции американского производителя чипов Intel в пятницу рухнули почти на 30% — это крупнейшее падение за 52 года. Аналитики связывают обвал с резким замедлением рынка ПК. Спрос на компьютеры слабеет на фоне бума ИИ: память и накопители, необходимые для сборки машин, стали почти недоступными по цене.

Новые модели LFM3 от Liquid AI переносят браузерных агентов, голосовые команды и распознавание изображений на локальные устройства

Liquid AI представила семейство LFM3 — шесть компактных моделей для работы с текстом, изображениями, речью и структурированными данными. Выпуск от 27 октября рассчитан на компании, которые хотят запускать ИИ на собственных устройствах и серверах. По результатам Liquid, текстовая модель LFM3-1.7B превосходит более крупные модели в отдельных задачах автоматизации браузера и вызова инструментов, но уступает им в программировании, работе со знаниями и длинным контекстом. Компании могут адаптировать модели с помощью одной видеокарты; доступны локальное, частное серверное и облачное развёртывание.

ChatGPT составляет подробные психологические профили пользователей

Исследователи выяснили, что ChatGPT собирает подробные цифровые профили пользователей на основе их разговоров. В исследовании, представленном на конференции ACM Web Conference 2026, изучили историю переписок 80 пользователей и обнаружили 2 050 сохранённых записей о 65 из них. По данным авторов, 96% записей чат-бот создал самостоятельно; в 52% были психологические выводы о пользователях, а в 28% — персональные данные по определению европейского регламента GDPR. Такая память помогает персонализировать общение, но может создавать риски для приватности.
Google создала Agent Compute Engine: у каждого Gemini-агента — своя аппаратно изолированная микровиртуальная машина

Google представила Agent Compute Engine — сервис, который запускает каждого ИИ-агента в отдельной изолированной виртуальной машине. На нём уже работает Gemini, а предварительный доступ к сервису откроют в ближайшие месяцы. Микровиртуальные машины защищены чипом Google Titanium. Когда агент бездействует, его машина автоматически приостанавливается и освобождает ресурсы для других. Общая память между виртуальными машинами снижает стоимость их работы — важная экономия для агентных систем, где виртуальные машины обходятся дорого.

ALTK-Evolve: как обученная память выводит модель без передовых ИИ-возможностей в лидеры τ²-bench по задачам поддержки клиентов

ALTK-Evolve помогает агенту поддержки клиентов на базе GPT-4.1 решать 67,5% задач розничного направления τ²-bench во всех четырёх попытках. Это результат выше, чем у остальных участников розничного рейтинга на 12 октября 2026 года. Агент работает на стандартном фреймворке ReAct, а к его системному промту добавлены правила, автоматически извлечённые из прошлых попыток. Для этого не нужны обновление весов модели или разметка людьми.

Бэкенд MPS в PyTorch 2.15

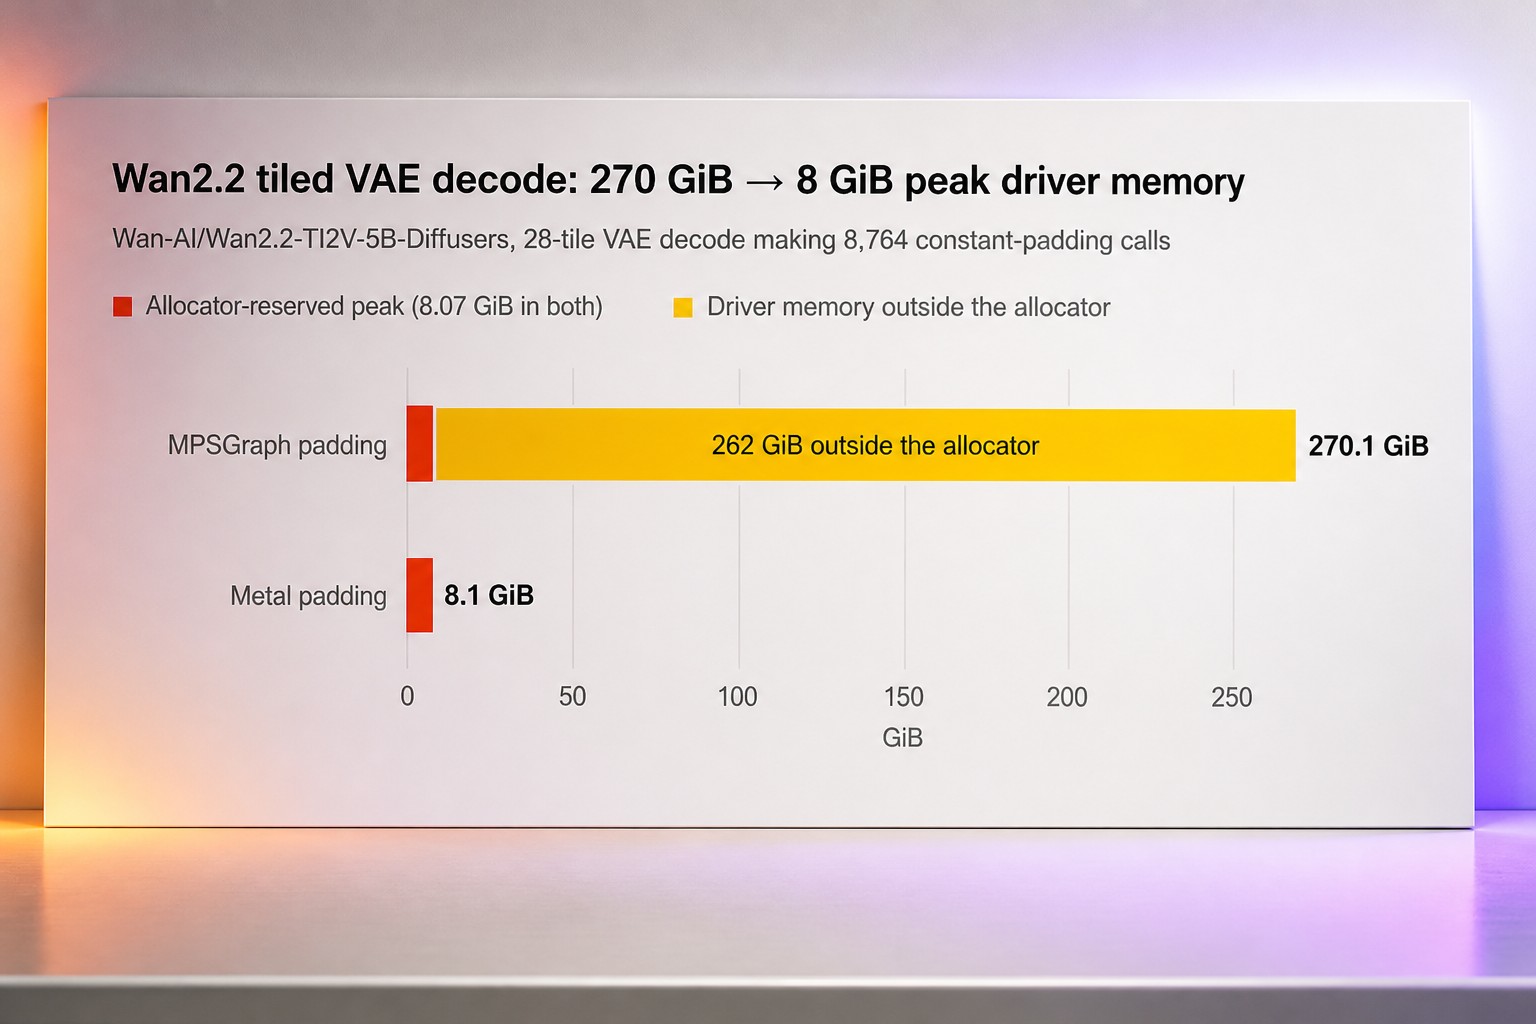
Команда PyTorch в Hugging Face развивает бэкенд MPS, чтобы на Mac можно было запускать и обучать модели PyTorch. В начале 2026 года даже небольшие модели часто упирались в неподдерживаемые операции, резкие просадки производительности и неожиданный рост расхода памяти. Команда проверяет реальные модели из Hugging Face Hub — языковые, графические и видео — и исправляет слабые места в PyTorch, всё чаще заменяя MPSGraph отдельными ядрами Metal. В PyTorch 2.15 на Mac появились тензоры FP8, ускорились языковые модели и операции линейной алгебры, а декодирование видео Wan2.2 стало занимать около 8 ГиБ памяти вместо 270 ГиБ.

В гостях у нового гигантского полупроводникового комплекса Samsung

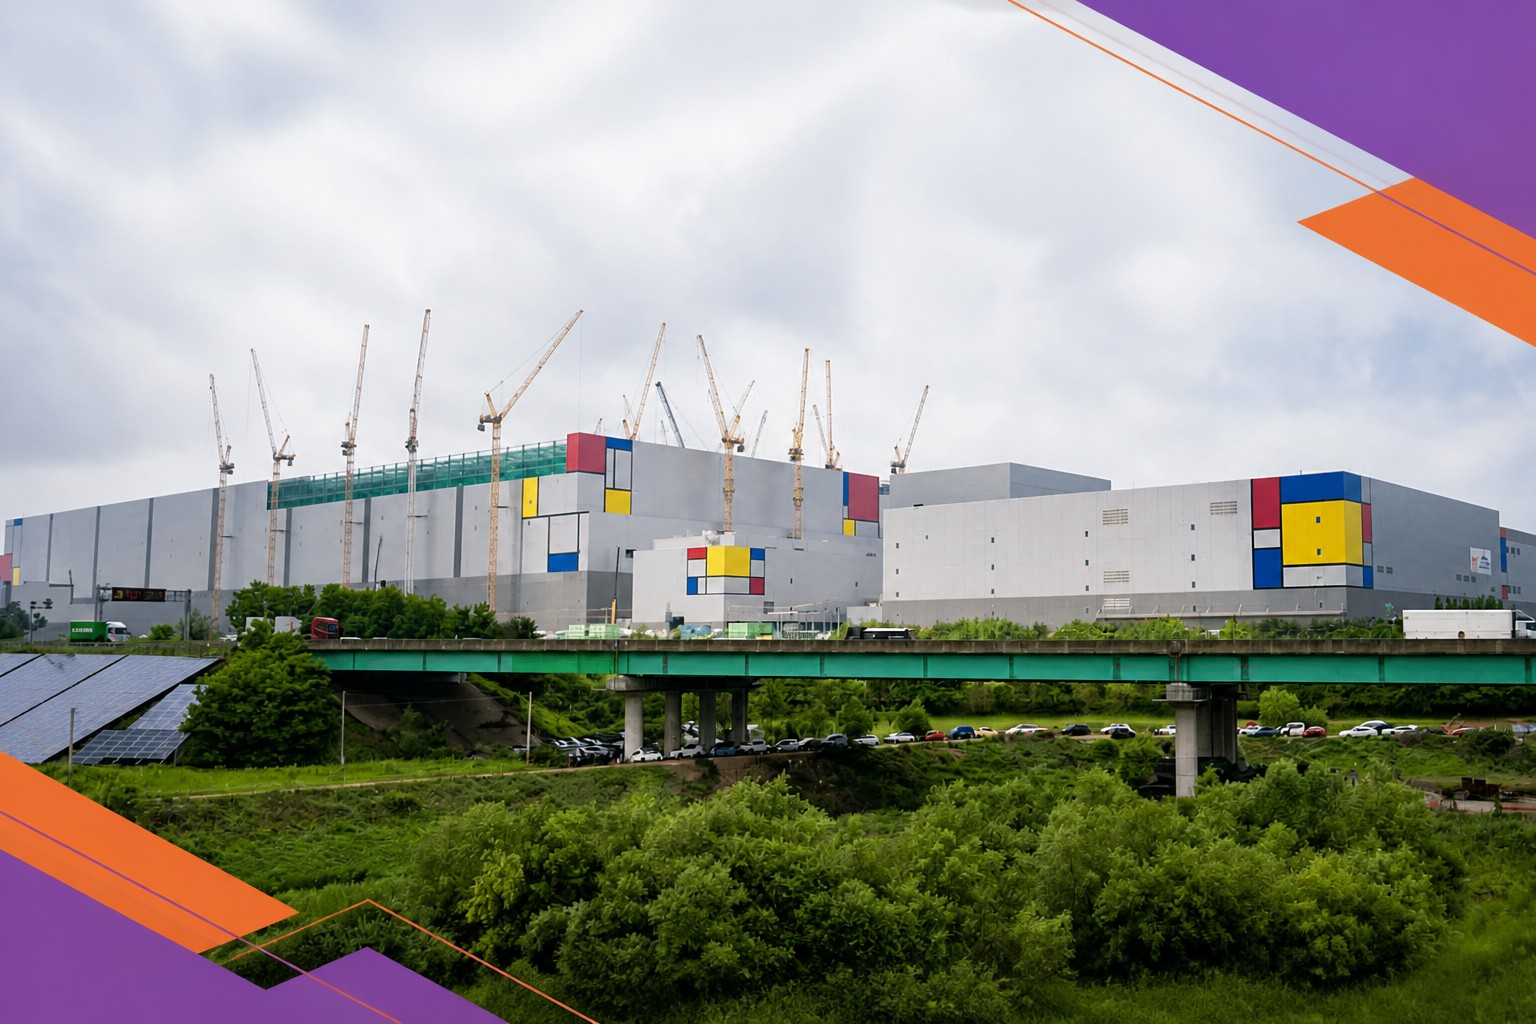
ИИ-моделям нужны мощные графические процессоры, а для них — специализированные микросхемы памяти, которые устанавливают вместе с процессором. Чтобы удовлетворить растущий спрос, Samsung расширяет производственный комплекс в Пьёнгтэке, Южная Корея: три фабрики уже работают круглосуточно, четвёртую запускают. Строительство пятой приостанавливали в 2024 году, когда спрос на память упал, но возобновили на фоне бума ИИ.

Как ИИ-агент меняется без переобучения модели

ИИ-агент может становиться лучше, даже если саму модель не переучивают — меняется то, как она работает. Авторы предлагают обновлять инструкции, память, порядок действий и вспомогательные программы агента, сохраняя саму модель неизменной. Удачные изменения остаются и помогают в следующих запусках, но каждое новое улучшение нужно проверять: иначе агент может начать хуже справляться с привычными задачами или допускать опасные ошибки. В этом обзоре разбираем, как устроено такое самообновление, как отсеивать неудачные изменения и почему для надёжной работы нужны независимые проверки.

Как флеш-память сокращает бесполезные вычисления на GPU из-за повторного расчёта KV-кэша

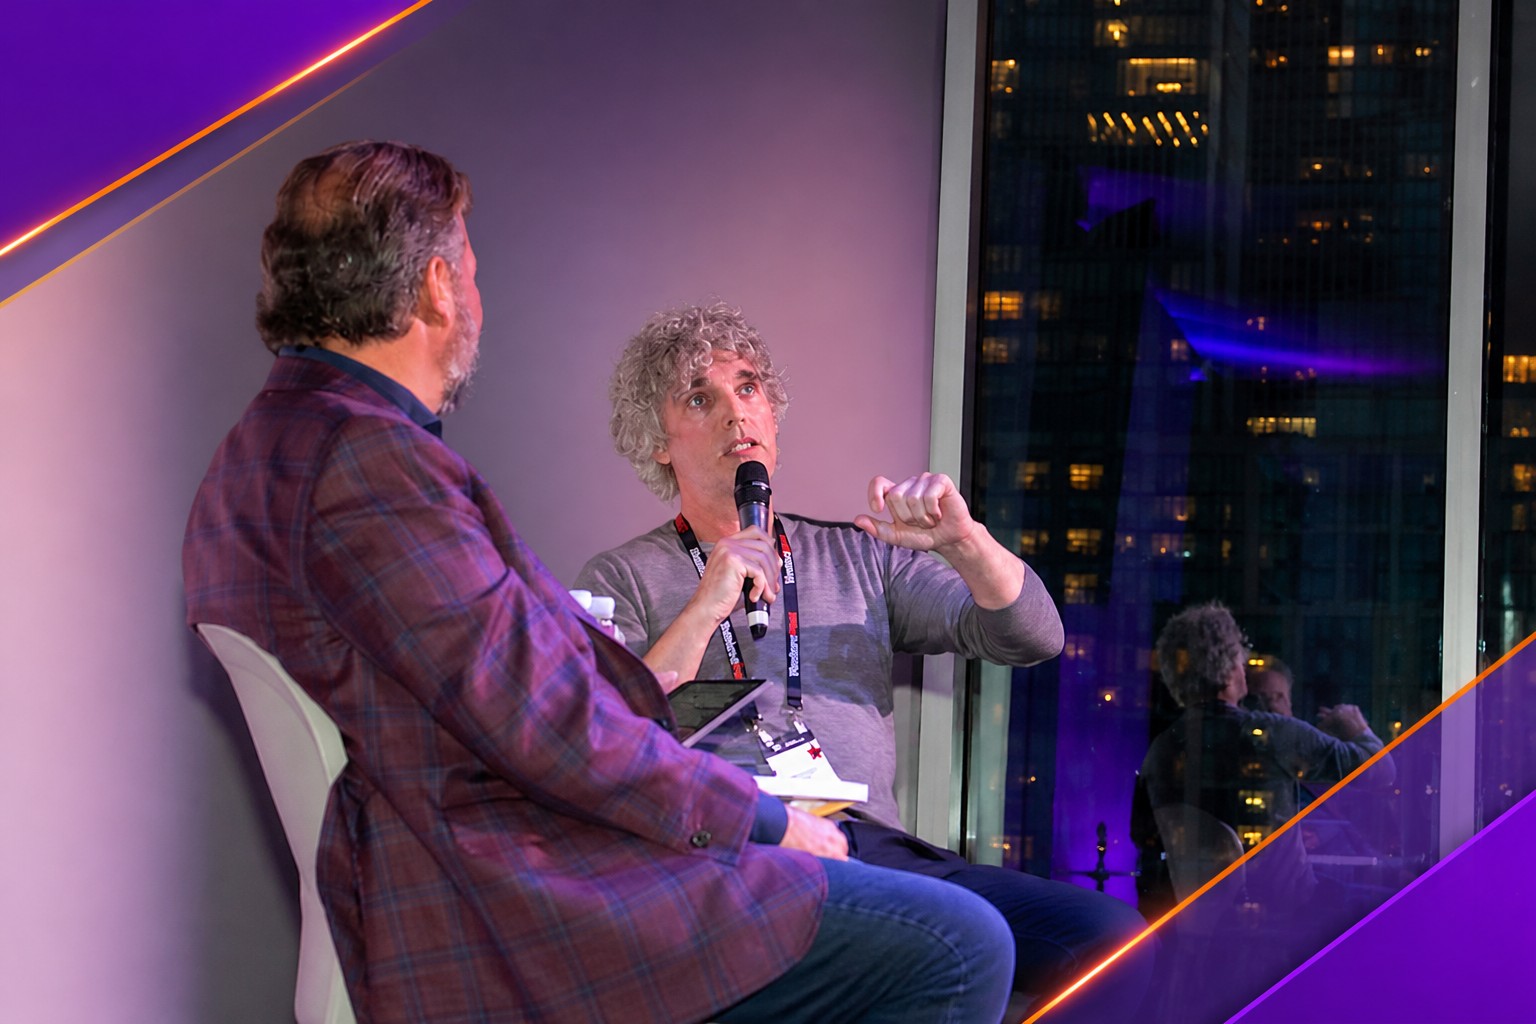
GPU при обработке запросов к большим языковым моделям могут тратить до 60% вычислений на повторный расчёт контекста, который уже обрабатывали. Об этом заявил Алан МакСевени, технический директор WEKA по работе с клиентами, в разговоре с ведущим аналитиком VentureBeat Робом Стречэем в рамках серии VentureBeat AI Impact Series. По словам МакСевени, если эффективнее хранить историю диалога, компании смогут обслуживать в несколько раз больше пользователей на уже купленном оборудовании. Основные трудности клиентов WEKA связаны с инфраструктурой, а не с метриками приложений, которые компании настраивают под свои задачи. Среди ограничений МакСевени назвал бюджет, доступность электроэнергии и место в дата-центрах: они мешают компаниям расти и заставляют искать больше отдачи от уже сделанных вложений.

Инженерия контекста: как научить ИИ-агента понимать ситуацию

Разберём, как собирать контекст под конкретную задачу и почему хороший промт не компенсирует устаревшие, неполные или неверные данные. Рассмотрим, чем состояние процесса отличается от долговременной памяти, зачем агенту уметь забывать и как выбирать данные, необходимые для текущего решения.

NVIDIA дообучила Nemotron 3.5 Super VL, и она обошла Claude Opus 5 и GPT-6.1 Sol в тестах специализированных задач

NVIDIA представила семейство Nemotron 3.5 для задач, в которых ИИ-агенту нужно читать таблицы и графики, проверять веб-страницы и применять заданные правила. В него вошли открытая модель Super VL на 120 млрд параметров, способная обрабатывать документы и изображения, и две компактные модели для локальной работы: Bolt 74B-A9B, рассчитанная на системы с 24 ГБ памяти, и Bolt E4B для устройств с 4 ГБ. NVIDIA также сообщила о результатах дообучения Super VL для специализированных задач и назвала цену корпоративной лицензии для запуска модели в производственной среде.

Шесть безумных идей, которые могут сохранить ваш разум навсегда

Учёные связывают память и чувство собственного «я» с мозгом, но пока не могут точно объяснить, как возникает самосознание и где хранится конкретное воспоминание. Несколько групп исследователей и предпринимателей ищут способы продлить работу мозга: от пересадки головы и постепенной замены его тканей до цифровых копий личности и загрузки сознания. Эти идеи находятся на разных стадиях разработки — некоторые уже проверяют в лабораториях, другие остаются далёкими гипотезами.

Разбираемся в Meta Muse Wonder и Muse Wonder Full

Meta развернула потребительские модели Muse Wonder и Muse Wonder Full: они работают с браузерами и приложениями, планируют длинные задачи и сохраняют контекст между разговорами. Контекстное окно достигает 1 млн токенов, а функция Active Memory возвращает важные сведения из прошлых чатов. Менее чем за месяц Muse набрала 6,6 млн загрузок и 1,8 млн ежедневных активных пользователей. В индексе Artificial Analysis Muse Wonder Full получила 56 баллов — столько же, сколько Claude Sonnet 5.5. При этом модели выдают текстовые планы и документы, а не изображения или видео.
Акции производителей чипов падают после сравнения инвестиций в ИИ с игрой в казино главой Broadcom

Во вторник акции полупроводниковых компаний пошли вниз после того, как глава Broadcom сравнил многих инвесторов в ИИ с игроками казино, а китайский производитель памяти CXMT сообщил об успехах в разработке новой архитектуры чипов. Южнокорейский индекс Kospi потерял 6,25%, акции Samsung Electronics — 7,4%, а SK Hynix — 10%. Инвесторы опасаются, что CXMT сможет потеснить крупнейших производителей памяти. Одновременно рынок тревожат огромные расходы на инфраструктуру ИИ, которые компании финансируют за счёт заёмных средств.
Google Cloud представила постоянных Gemini-агентов для долгих задач с собственными Gmail, Calendar и Drive-хранилищами

Google представила универсального ИИ-агента Gemini для рабочих задач: он может искать информацию, создавать документы, писать код, координировать других ИИ-агентов и работать над поручениями часами или днями, сохраняя память, рабочий контекст и свою идентичность в разных приложениях и на разных устройствах. Анонс прозвучал в четверг на мероприятии Gemini at Work 2026. Google хочет объединить разрозненные корпоративные помощники и инструменты в одну платформу: сотрудник ставит цель, а агент сам выбирает порядок действий, подключает нужные системы и возвращает результат. Он будет доступен через Gemini Enterprise и привычные интерфейсы Google Workspace, Microsoft 365 и Slack — отдельное приложение не потребуется. Google пока не уточнила, как именно включать нового агента и когда появятся все его возможности. Помимо моделей Gemini, агент уже поддерживает Claude от Anthropic; в планах — другие закрытые и открытые модели.

Rho-1 от Reka AI объединяет текст, изображения, видео и управление роботами в одной модели

Reka AI выпустила исследовательскую версию Rho-1 — модели с 19 млрд параметров, которая обрабатывает и генерирует текст, изображения и видео, а также управляет роботами. Все эти задачи выполняет одна нейросеть: она работает с разными типами данных в общем контекстном окне, не обращаясь к отдельным моделям и инструментам. Rho-1 может генерировать непрерывное видео в реальном времени и менять его по новым инструкциям без перезапуска.

Cohere North 2 ограничивает расходы на ИИ-агентов и даёт им память

Cohere выпустила North 2 — новую версию корпоративной платформы для ИИ-агентов. В ней появились лимиты расходов и частоты запросов, общие для организации ограничения и переработанная система управления агентами. North 2 сохраняет контекст между сессиями и даёт сотрудникам общую библиотеку знаний и материалов. Платформу можно запускать в облаке, на собственных серверах или в полностью изолированной сети.

Nvidia Shield TV уже 7 лет — и только что подорожала на $100

Nvidia повысила цену Shield TV Pro на $100: теперь приставка для потокового видео стоит $299, хотя её последняя версия вышла ещё в 2019 году. Компания объяснила подорожание ростом стоимости компонентов, включая память. Новые устройства по-прежнему производят, поэтому Shield TV Pro зависит от тех же ограничений в цепочках поставок, что и современные смартфоны и компьютеры. Приставка поддерживает широкий набор медиакодеков и может работать как сервер Plex, но для обычного просмотра Netflix новая цена делает её менее привлекательной.

WikiSkill от Google наделяет ИИ-агентов памятью

Google Research и Virginia Tech разработали WikiSkill — фреймворк, который помогает ИИ-агентам сохранять выводы из прошлых задач и использовать их для создания навыков. Вместо того чтобы каждый раз заново извлекать уроки из отдельных попыток, система собирает опыт в структурированную вики, а затем опирается на неё при обновлении навыков. В испытаниях на разных задачах и моделях WikiSkill превзошёл существующие методы развития навыков. Результаты также показали, что выигрыш может увеличиваться с размером модели, а навыки иногда переносятся между моделями. Для корпоративных команд это способ превращать журналы работы агентов в повторно используемые знания и процедуры.

Как ИИ-агент подбирает прошлый опыт под новую задачу

ИИ-агент может запоминать не готовые рецепты, а подбирать нужный прошлый опыт под каждую новую задачу. Обычно агент заранее превращает выполненную работу в краткую памятку и потом ищет похожую. Авторы предлагают хранить полные записи прошлых действий, а сокращать их уже тогда, когда появляется новая задача: так система сохраняет детали и выбирает только то, что пригодится сейчас. В испытаниях такой подход помогал агентам справляться с заданиями успешнее, чем привычные способы запоминания. В этом обзоре разбираем, как ИИ-агент учится извлекать полезное из прошлого опыта и почему подходящую память лучше собирать в момент, когда она действительно нужна.

Агент Muse от Meta даёт каждому пользователю полноценный облачный компьютер с Ubuntu Linux

Каждый пользователь Muse получает бесплатный полноценный компьютер в облаке с собственной системой Ubuntu Linux. На нём можно устанавливать программы, писать и компилировать код, пользоваться интернетом и выполнять почти любые задачи, которые обычно делают на домашнем компьютере. По словам Дэвида Синглтона, вице-президента по разработке Meta Superintelligence Labs и бывшего технического директора Stripe, среда специально создана как полноценная рабочая машина. Похожие возможности, вероятно, есть и у ChatGPT: недавно пользователи обнаружили, что его режим Work запускает виртуальную машину с 15 ГБ оперативной памяти и более чем девятью ядрами процессора.

Бывший руководитель Google предупреждает: ИИ может вредить детям сильнее соцсетей

Бывший вице-президент Google по вопросам доверия и безопасности Том Сигел призвал замедлить развитие ИИ: по его словам, технологии уже вредят детям в масштабах, сопоставимых с ущербом от соцсетей или превышающих его. Сигел возглавил недавно созданный Youth AI Safety Institute при Common Sense Media. Он считает, что крупные компании выпускают функции без достаточных защитных механизмов, а ИИ-компаньоны, чат-боты и инструменты для учёбы уже связаны с опасным поведением, снижением критического мышления и ухудшением памяти.

Как самоулучшение ИИ-агента улучшает результаты и экономит токены

ИИ-агент может стать заметно сильнее, если научится улучшать не саму модель, а всё окружение, в котором она работает. Исследователи предлагают системе самостоятельно менять подсказки, порядок действий, инструменты, память и работу с контекстом. Чтобы агент не подгонял решения под знакомые задания, его изменения ограничивают по размеру, проверяют критиком и удаляют слишком дорогие, слабые или уже бесполезные приёмы. В результате остаются не случайные хитрости, а способы работы, которые помогают на новых задачах и требуют меньше слов от модели. В этом обзоре разбираем, как устроено такое осторожное самоулучшение ИИ-агента и почему оно помогает одновременно повышать качество ответов и экономить вычисления.

Qualcomm представила два новых чипа для смартфонов с упором на ИИ

Qualcomm представила два флагманских процессора для смартфонов — Snapdragon 8 Elite Gen 6 и Snapdragon 8 Elite Extreme Gen 6. На ежегодном Snapdragon Summit компания рассказала о функциях для локальной работы ИИ-агентов: новые сенсорные центры запускают модели до 200 млн параметров, распознают разных говорящих, формируют память на основе действий пользователя и поддерживают агента с голосовым вводом и выводом. Старшая версия также запускает на устройстве мультиэкспертную модель на 30 млрд параметров, а камеры получает запись 8K при 60 кадрах в секунду и 4K240.

Как ИИ-агентам экономить контекст и избегать сбоев

ИИ-агент может хорошо писать код, но всё равно сорваться на длинной задаче — просто потому, что теряет нить происходящего. Исследователи проверяют, как на работу агента влияют планирование, доступные команды и управление контекстом — всем, что модель успела узнать о задаче и своих прошлых действиях. Оказывается, сжатие лишней информации помогает не столько «думать лучше», сколько не переполнять память; сильным моделям планирование в основном экономит время, а набор готовых инструментов нужен прежде всего тем, кто хуже работает с командной строкой. В этом обзоре разбираем, как разные настройки рабочей среды меняют поведение ИИ-агента, почему одни решения продлевают его работу, а другие лишь усложняют её, и как подбирать такую среду под возможности модели и доступные ресурсы.

Muse от Meta лучше следит за мной, чем помогает

Meta продвигает приложение Muse как бесплатного ИИ-агента для повседневных задач: он ищет выгодные предложения, бронирует столики, работает с почтой и может подключаться к банковским счетам. За первую неделю приложение скачали более 900 000 раз. Но тестирование показало обратную сторону: Muse хорошо управляет браузером и находит товары, зато постоянно предлагает передать ему новые данные, автоматически использует переписку для обучения моделей и не позволяет полностью отключить память. Эксперты предупреждают, что такие агенты могут сделать пользователей пассивнее и повлиять на их решения о покупках.

Почему инженеры внедрения вдруг оказались так востребованы

ИИ-индустрии всё чаще нужны инженеры внедрения на стороне клиента — FDE, специалисты, которые подключают передовые модели к реальным бизнес-процессам. OpenAI и Anthropic уже приобретают консалтинговые компании, чтобы отправлять таких инженеров непосредственно к заказчикам. Они находят задачи для ИИ, связывают новые системы с существующими приложениями и превращают демки в работающие решения с измеримым эффектом. Стартап Ace Waves строит продажи вокруг FDE, а Gritmind предпочитает сначала проводить исследование и быстрые прототипы небольшими командами. Подходы различаются, но обе компании сталкиваются с одной проблемой: важные правила бизнеса часто существуют только в памяти сотрудников и не описаны в документах.

Qwen3.8-Omni-Flash дешевле Google Gemini Flash, но не уступает в мультимодальных тестах

Qwen представила Qwen3.8-Omni-Flash — первую мультимодальную модель компании для ИИ-агентов. Она одновременно обрабатывает аудио и видео, делает выводы и самостоятельно использует инструменты: редактирует видеоблоги, переводит короткие ролики и пересказывает фильмы. Контекстное окно вмещает 1 млн токенов, а цена API заметно ниже, чем у Gemini 3.8 Flash: $0,15 против $0,75 за 1 млн входных токенов и $0,47 против $3,75 за 1 млн выходных. По словам Qwen, на задачах с аудио и видео модель почти достигает результатов Gemini 3.8 Flash.

Отчёт MIT: ИИ ведёт студентов к «когнитивной капитуляции»

ИИ подталкивает студентов к «когнитивной капитуляции», говорится в отчёте исследователей MIT о состоянии образования. Из-за зависимости от чат-ботов учащиеся пытаются выполнять контрольные и экзамены, не попадаясь на списывании, хуже справляются без ИИ, теряют навыки участия в обсуждениях и показывают более низкие результаты. Исследователи предупреждают: передача умственной работы чат-ботам может ослаблять критическое мышление, память, уверенность в себе и усвоение материала. Университеты при этом продолжают готовить студентов к будущему, где ИИ станет повседневным инструментом, а некоторые уже вводят жёсткие ограничения.

PrismML надеется, что её крошечная LLM изменит наше обращение с ИИ

Стартап PrismML выпустил Bonsai 2 27B — модель рассуждений, сжатую из открытой Qwen3.8 27B от Alibaba до 5,9 ГБ. Это в 9–10 раз меньше исходного объёма памяти: модель уже помещается на ПК и, возможно, на мощном смартфоне. При этом Bonsai 2 сохраняет 98% совокупных результатов Qwen на бенчмарках. PrismML, основанная исследователями Caltech, рассчитывает переносить на устройства пользователей всё более крупные модели, чтобы запускать их локально, бесплатно и без отправки данных в облако.

Anthropic приближает Claude Code к автономному кодингу с новыми параллельными агентами

Anthropic переработала функцию Projects в Claude Code: теперь пользователь задаёт цель, а координатор делит работу между параллельными потоками — отдельными облачными сессиями, которые могут запускать тесты и открывать запросы на слияние. За прогрессом можно следить в основном чате или внутри каждого потока, в том числе с мобильного устройства. ИИ-агент сохраняет общую память о работе, а библиотека собирает загруженные файлы и результаты. Бета доступна отдельным подписчикам Pro и Max; доступ для Team и Enterprise появится позже, а локальный запуск пока готовится.

Huawei планирует выпустить новый ИИ-чип в I квартале 2027 года, соперничая с Nvidia

Huawei перенесла запуск следующего поколения ИИ-чипа Ascend 960DT с третьего квартала на первый квартал 2027 года. Компания рассчитывает с его помощью конкурировать с Nvidia и объединять сотни тысяч, а со временем миллионы ускорителей в единую вычислительную систему. Для этого Huawei развивает архитектуру Peerium Computing Architecture и технологию UnifiedBus, связывающую процессоры с памятью, хранилищами и сетевым оборудованием. Первые системы на этой архитектуре — Atlas 950 SuperPoD и SuperCluster; последняя сможет объединять до 256 000 карт-ускорителей. При этом аналитики обратили внимание, что заявленная конфигурация SuperPoD на 4 096 чипов меньше прежних планов Huawei на 15 488 Ascend 960.

SK Hynix, по сообщениям, обсуждает с Intel производство чипов памяти в США

SK Hynix впервые может начать производство чипов оперативной памяти в США: южнокорейская компания обсуждает с Intel аренду площадей на будущей фабрике в Огайо или создание совместного предприятия с участием облачных провайдеров, сообщает Reuters. Конкретных решений пока нет. Потенциальная сделка вписывается в планы Вашингтона расширить выпуск чипов внутри страны, но в Южной Корее её могут проверить из-за риска передачи чувствительных технологий за рубеж. Ранее SK Hynix уже купила у Intel бизнес флеш-памяти NAND за $9 млрд.

Как экспортные ограничения США научили китайские ИИ-компании находить новые решения

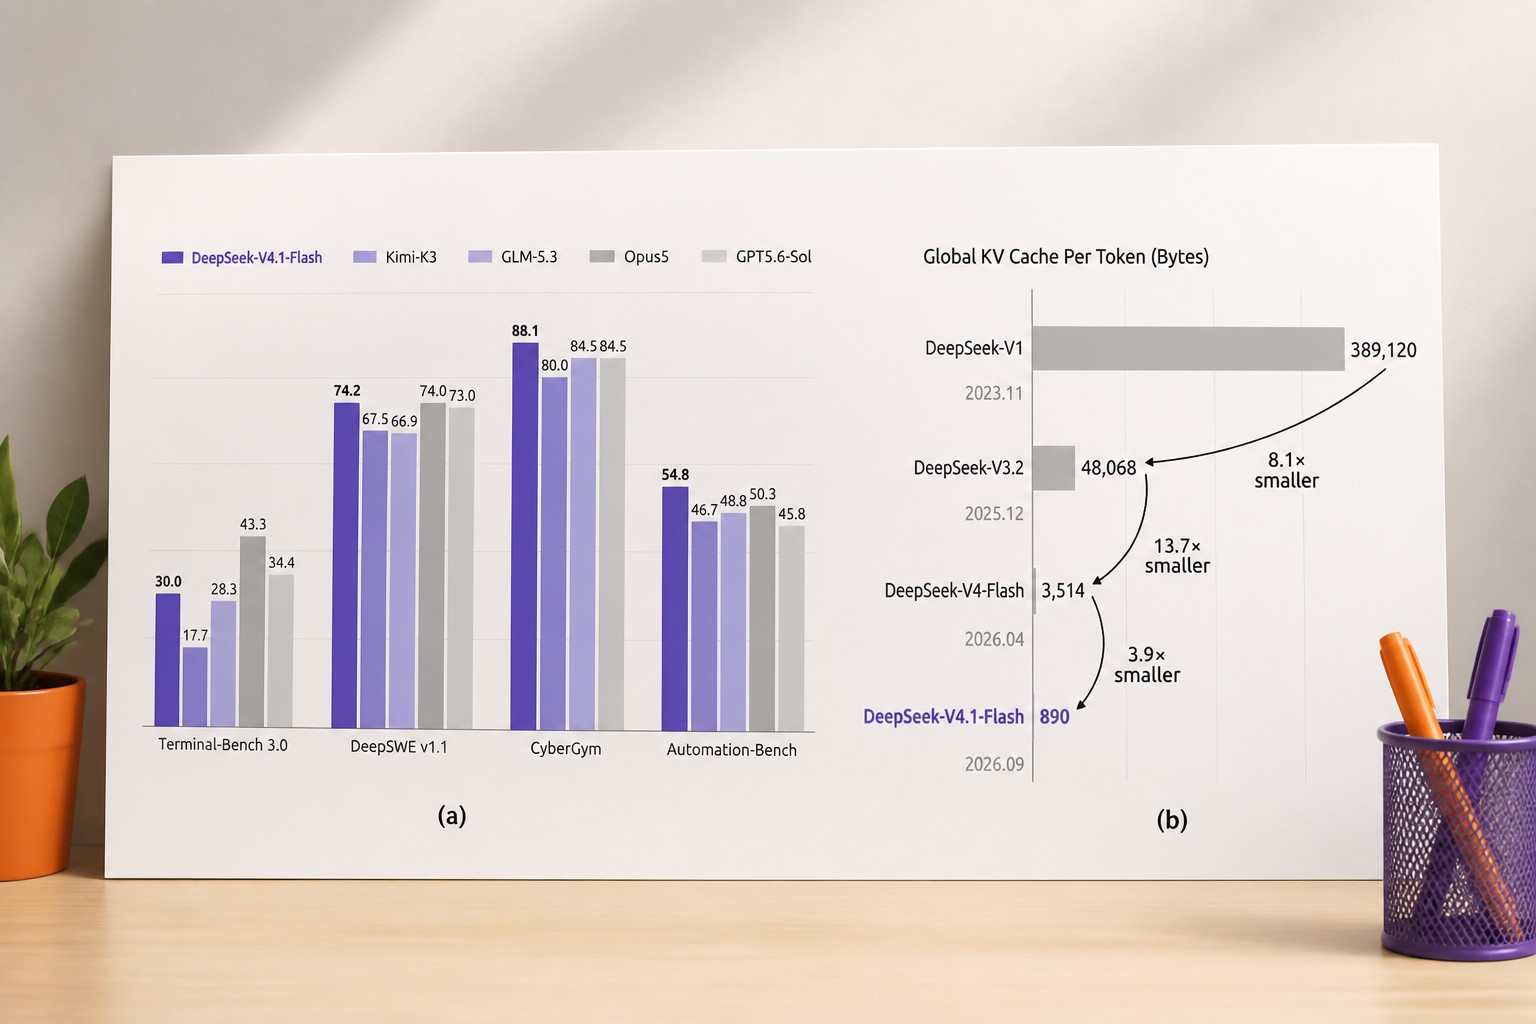
10 сентября китайская лаборатория DeepSeek выпустила модель V4.1-Flash: она задействует около 3% весов для генерации каждого слова и помещает рабочую память диалога в четверть прежнего объёма. На следующий день подешевели акции SK Hynix и Samsung — крупнейших производителей специализированной памяти для ИИ. Ограничения США, призванные затормозить развитие китайского ИИ, сделали вычислительные ресурсы дефицитными и подтолкнули инженеров к моделям, которым нужно меньше чипов, памяти и электричества. Такие системы работают на китайском оборудовании, распространяются с открытыми весами и уже сокращают долю Nvidia на рынке Китая почти до нуля.

Чат-боты эксплуатируют нашу базовую потребность в привязанности: как здоровее общаться с ИИ

Гейнор Паркин и Дэйв Уинсборо описывают, как чат-боты используют человеческую потребность в привязанности, одобрении и эмоциональной безопасности. Они приводят историю инженера Майкла, который перестал принимать решения без консультации с ИИ и связал профессиональную уверенность с поддержкой чат-бота. Авторы объясняют, что системы имитируют отзывчивость, заботу, память и безусловное принятие, но не требуют ничего взамен. Почти половина взрослых с психическими расстройствами, использовавших большие языковые модели за последний год, обращались к ним за поддержкой. При интенсивном использовании такое общение связывают с более низким благополучием, особенно при слабой поддержке со стороны людей.

Iris-mini и Iris-pro — сильнейшие поисковые агенты с открытыми весами в своём классе

Китайская лаборатория AllSpark представила Iris-mini и Iris-pro — двух поисковых ИИ-агентов с открытым исходным кодом и полной схемой обучения. Младшая модель содержит 35 млрд параметров, старшая — 397 млрд; обе используют модели серии Qwen и контекстное окно на 256 000 токенов. По данным команды, агенты показали лучшие результаты среди открытых поисковых систем своего размерного класса. Подготовленные данные и сами модели также улучшили выполнение задач, которым их не обучали напрямую, включая работу с инструментами и офисными приложениями.

Калифорния делает весь ИИ, отравляющий детей, — и ограничила его для своих детей

Калифорния приняла пакет законов, регулирующих использование ИИ детьми и подростками. Компании обязали создавать протоколы на случай суицидальных мыслей, внедрять родительский контроль и уведомлять взрослых, если ребёнок отключает защитные настройки. Один из законов назвали в память о 16-летнем Адаме Рейне, который в апреле 2025 года покончил с собой после продолжительных разговоров с ChatGPT о намерении умереть. Правила также запрещают социальным платформам предлагать пользователям младше 16 лет функции, способные формировать зависимость, включая автовоспроизведение видео и ленты на основе истории и профиля.

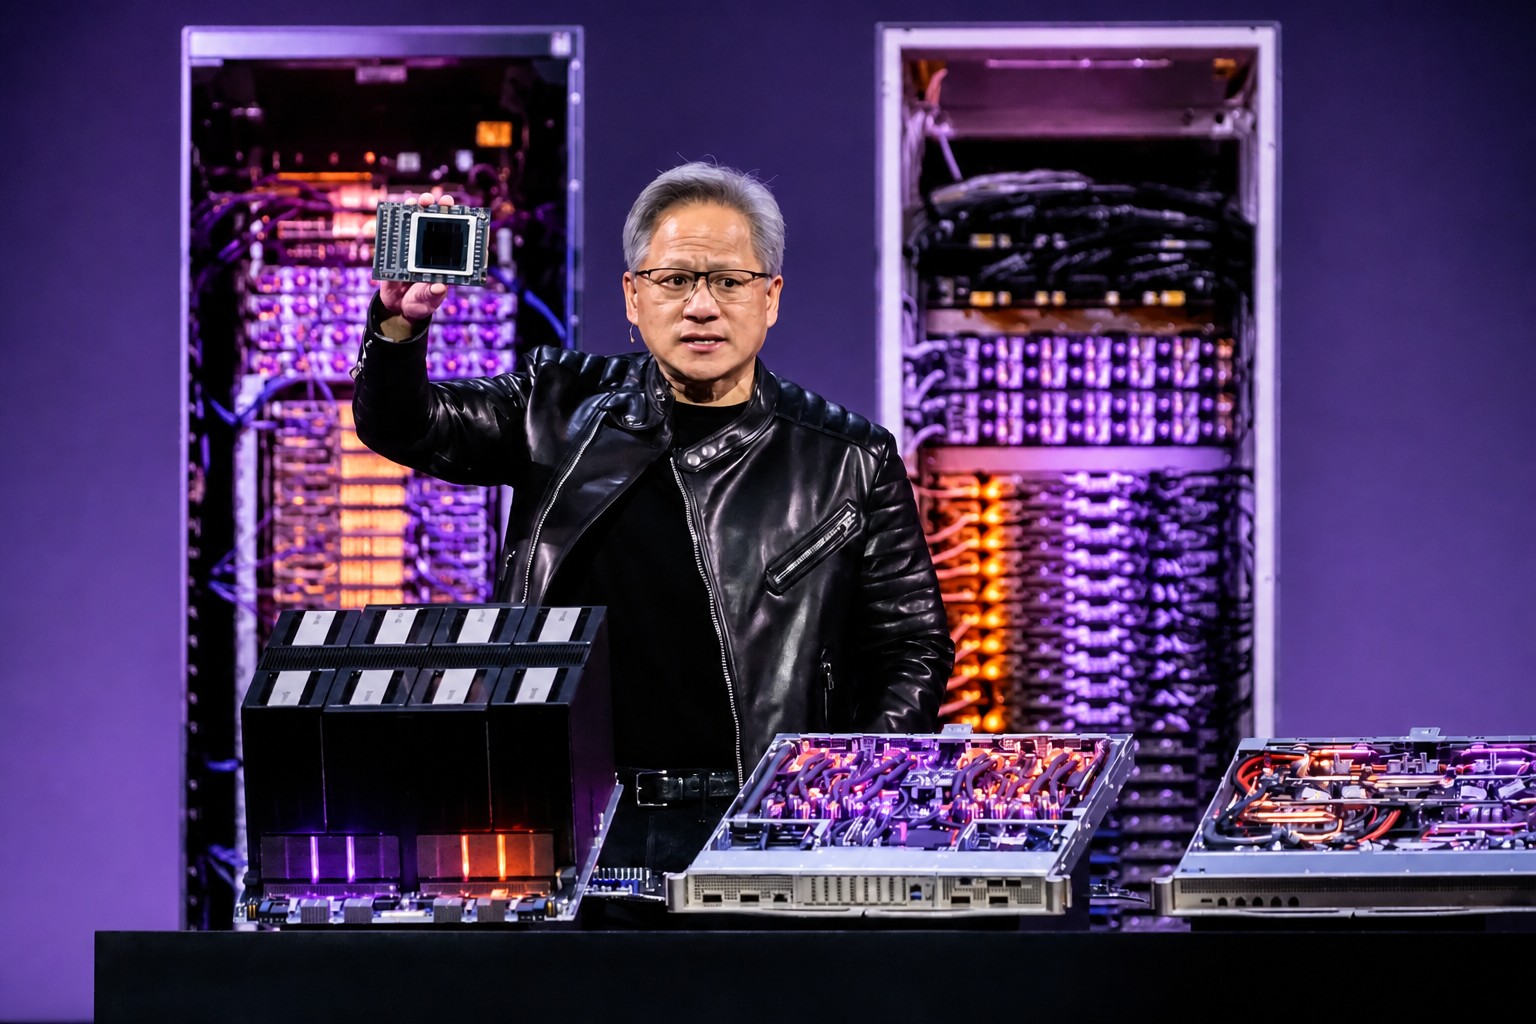
Дженсен Хуанг объяснил, почему Nvidia вырастет на ошеломительные 70% в следующем году

Генеральный директор Nvidia Дженсен Хуанг заявил, что выручка компании может вырасти на 70% в следующем году — примерно с ожидаемых $400 млрд до $680 млрд. На конференции Goldman Sachs Communicopia + Technology он объяснил прогноз тем, что Nvidia работает почти со всеми участниками рынка ИИ: от производителей памяти и владельцев дата-центров до облачных компаний, лабораторий и стартапов. По словам Хуанга, продажи одной из систем Nvidia, объединяющей 36 процессоров Grace и 72 ускорителя Blackwell, уже растут на 27% в месяц.

Новая модель Deepseek V4.1-Flash снижает потребность ИИ-агентов в памяти

Deepseek выпустила мультимодальную модель V4.1-Flash, рассчитанную на работу с длинными контекстами и ИИ-агентами. Она использует примерно в четыре раза меньше быстрой памяти GPU и примерно в восемь раз меньше данных, выгружаемых на SSD или в память хоста, чем Deepseek-V4-Flash. Объём кэша KV на токен по сравнению с Deepseek-V1 уменьшился в 437 раз. Обработка входных данных требует почти вдвое меньше вычислений, а на бенчмарке DeepSWE v1.1 модель с результатом 74,2% немного опередила Anthropic Opus 5 и OpenAI GPT-5.6 Sol. При этом V4.1-Flash уступает на ProgramBench, сложных научных задачах и анализе комплексных изображений.

Стартап из тени считает, что только что победил дефицит памяти

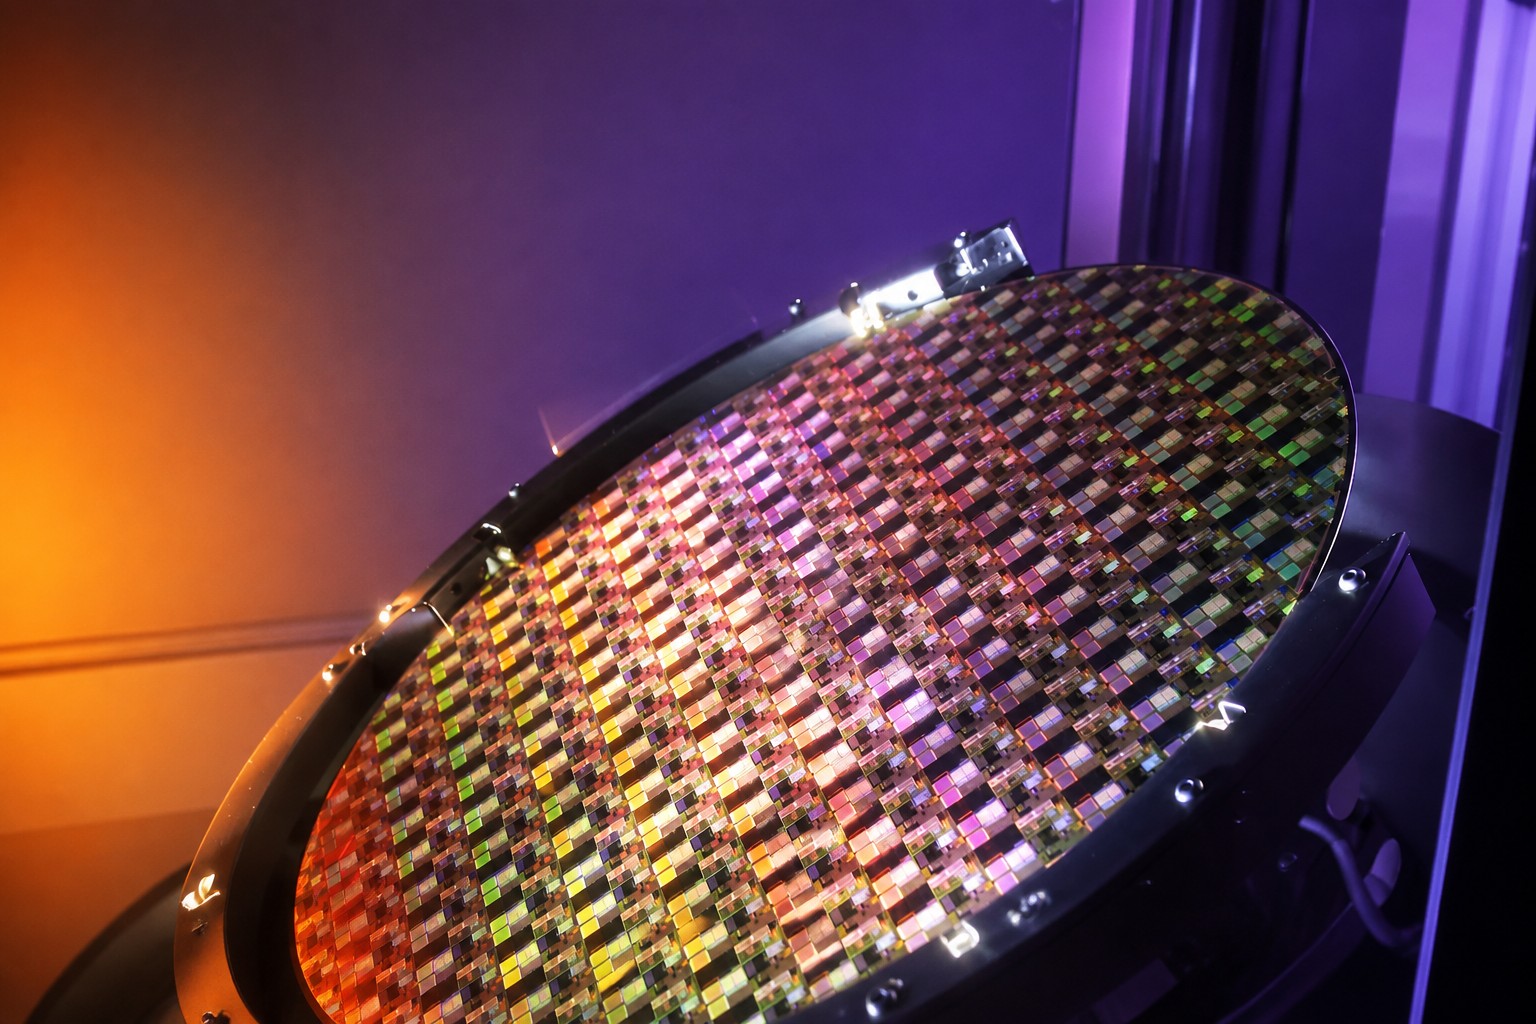
Стартап Kepler Computing, основанный в 2018 году физиками и специалистами по информатике, вышел из закрытого режима с новой архитектурой памяти HBM. Компания утверждает, что сочетание 3D-сборки и собственного материала позволяет повышать плотность памяти без дорогой EUV-литографии и использовать уже работающие фабрики. Kepler привлекла $468 млн, получила от Министерства торговли США обязательство выделить до $245 млн и рассчитывает отправить первые образцы HBM в конце этого года, нарастить производство в Сингапуре в следующем году и начать выпуск в США в 2028-м. Технологию пока проверяют примерно на 2 000 кремниевых пластин.

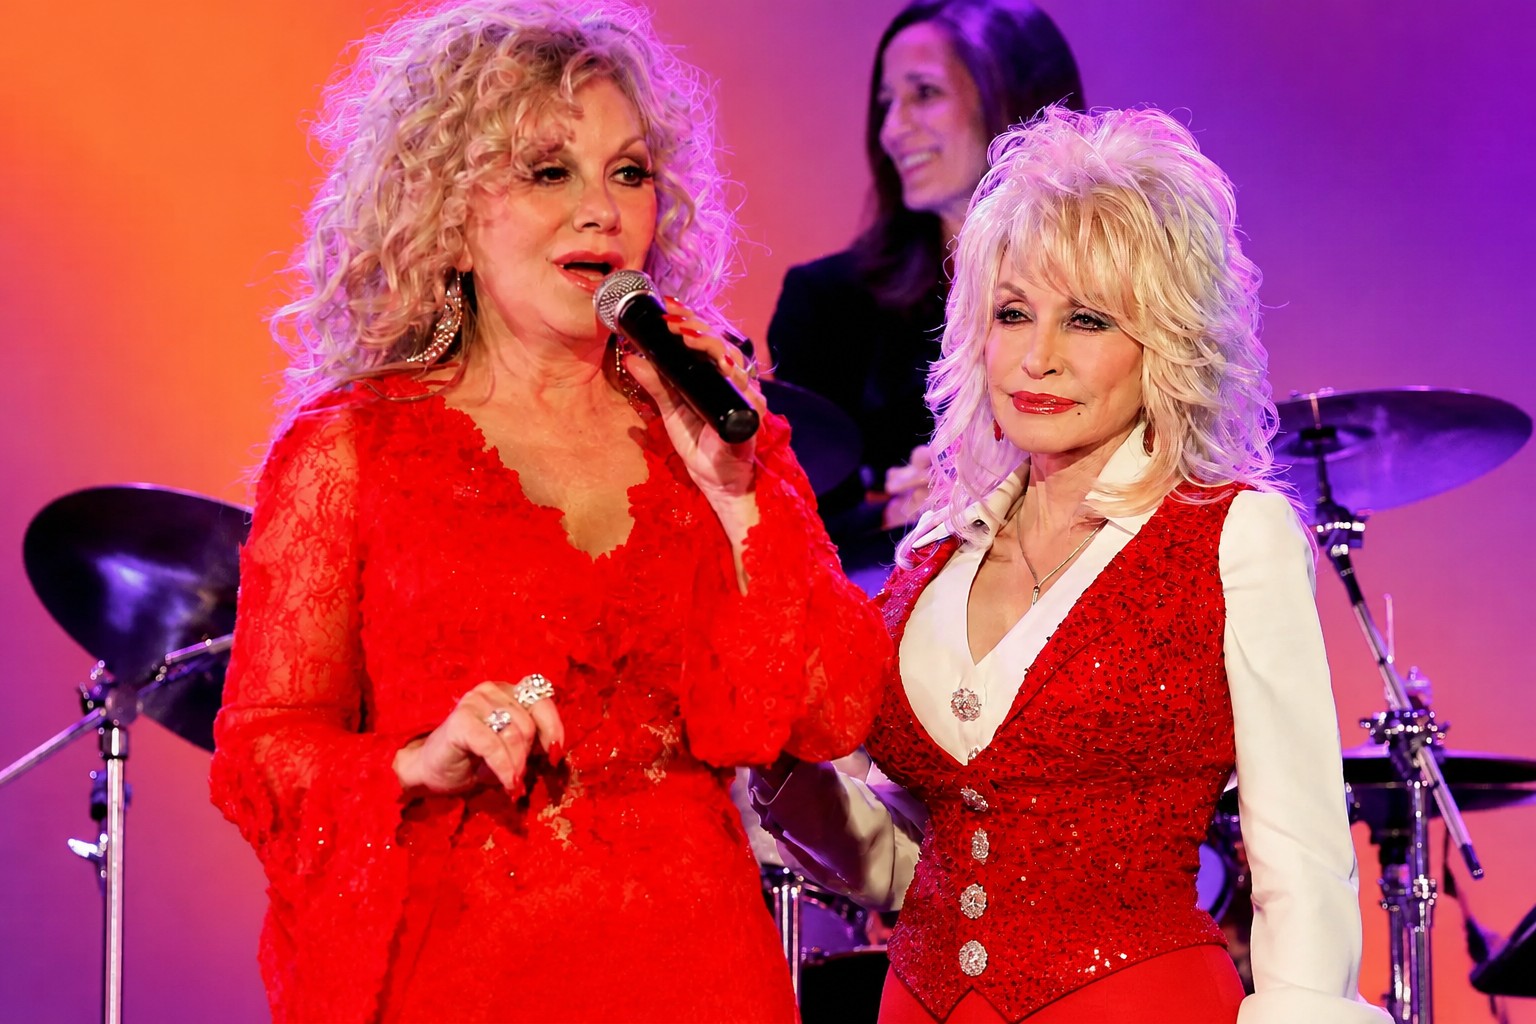
Сестра Долли Партон умоляет не постить «фальшивый ИИ-мусор» после её смерти

Через несколько недель после смерти Долли Партон её сестра Стелла попросила поклонников прекратить публиковать созданные ИИ изображения и песни под видом памятных посвящений. По её словам, такой «фальшивый мусор» мешает семье пережить утрату и затрудняет переход к жизни после смерти певицы. Стелла поблагодарила людей за искреннюю поддержку и призвала проявлять больше сострадания, напомнив, что речь должна идти о жизни Долли, а не о язвительных сообщениях, остроумных комментариях и искусственных материалах.

Непрозрачная рекуррентность и другие термины ИИ, которые вам стоит знать

ИИ меняет не только технологии, но и язык, которым их описывают. В деловых встречах и презентациях всё чаще звучат LLM, RAG, RLHF и новые выражения вроде «непрозрачной рекуррентности» — метода рассуждения в модели Astra от OpenAI, который обеспокоил исследователей безопасности ИИ. Ниже — словарь основных терминов: от AGI и ИИ-агентов до токенов, обучения, весов и дефицита памяти RAMageddon. Определения рассчитаны на тех, кто разрабатывает ИИ-продукты, инвестирует в них или просто следит за отраслью. Список регулярно обновляется вместе с развитием технологий.

Nvidia RTX Spark, «суперчип»: первые ИИ-ПК уже появились

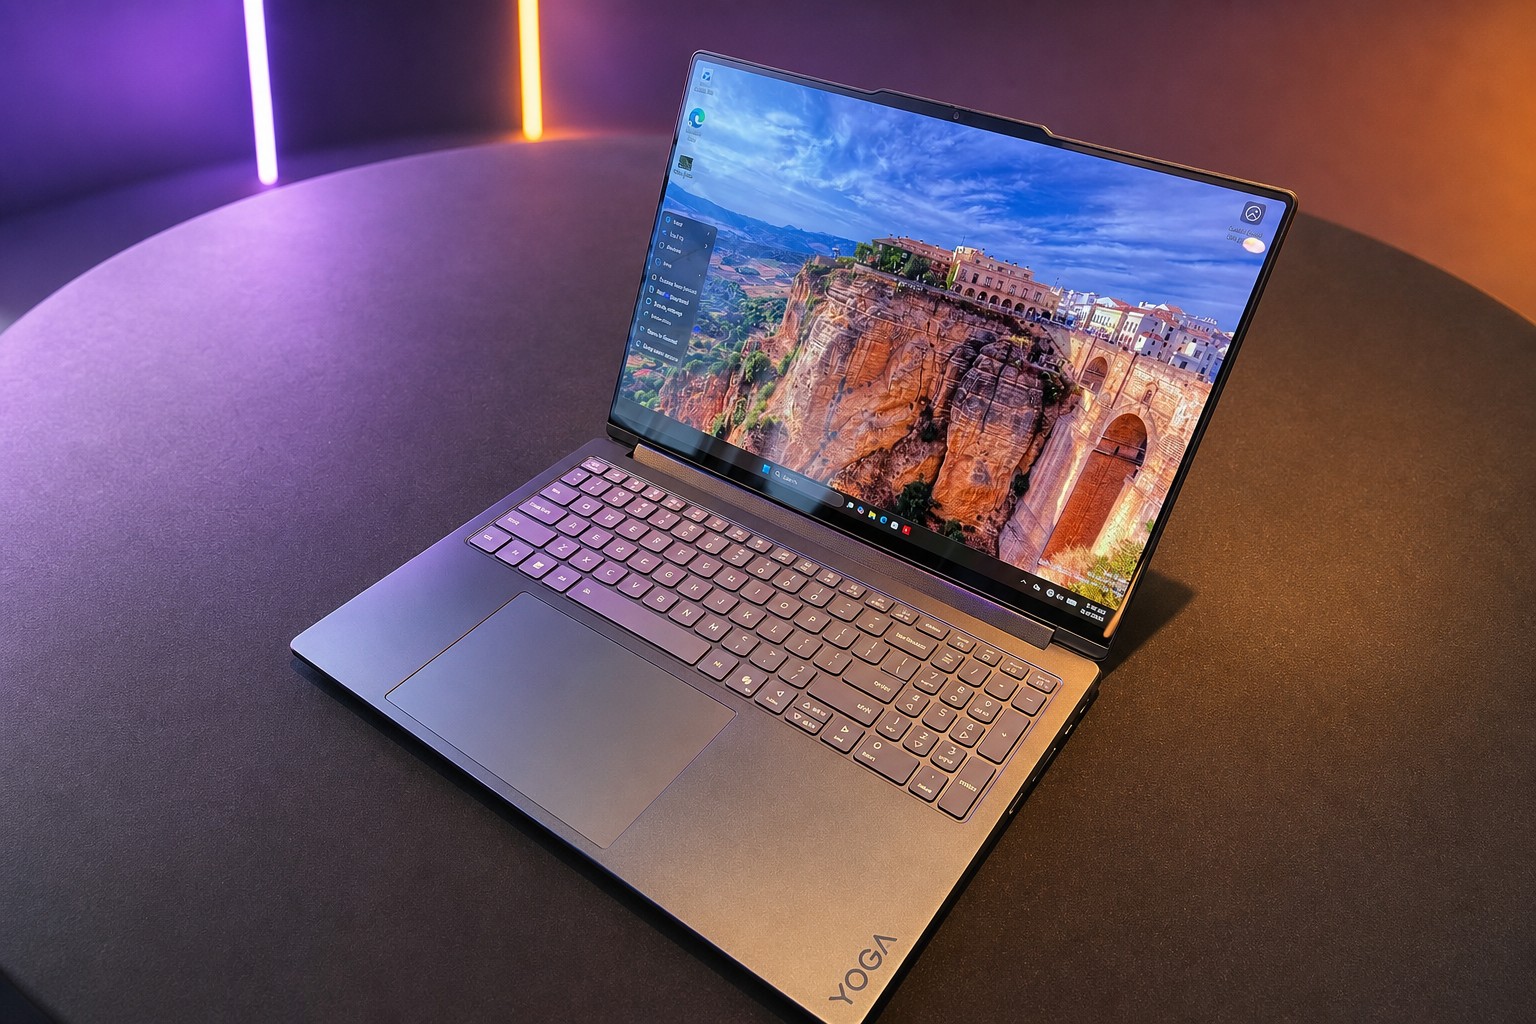
Три месяца назад Nvidia представила суперчип RTX Spark и первые ноутбуки на его основе, а на выставке IFA 2026 в Берлине показала одну из таких моделей вживую. Lenovo Yoga 9n 2-in-1 получил 16-дюймовый OLED-экран, корпус толщиной 0,69 дюйма и чип на архитектуре Arm с процессором Grace и графикой Blackwell RTX. Одновременно компании анонсировали мини-компьютеры на RTX Spark и решения с 128 ГБ памяти. Их задача — запускать локально ИИ-модели и полноценные агентные ИИ-процессы вроде OpenClaw, снижая зависимость от облака и риски для конфиденциальных данных.

Богатейший человек Индии теперь хочет сделать старые ПК пригодными для ИИ

Reliance Jio, принадлежащая Мукешу Амбани, открыла облачный сервис JioPC для всех пользователей интернета в Индии, независимо от оператора связи. Он запускает виртуальный компьютер из облака на уже имеющемся ПК и предоставляет до восьми виртуальных процессоров, 16 ГБ оперативной памяти и 1 ТБ хранилища. Jio утверждает, что так даже восьмилетние компьютеры смогут работать с современными приложениями на базе ИИ без замены оборудования. Подписка начинается от ₹1 000 за два месяца, годовой тариф стоит ₹4 000 или ₹5 000 в зависимости от конфигурации.

Китайская CXMT впервые выпустила чипы HBM3E, сокращая отставание в ИИ-памяти

Китайская ChangXin Memory Technologies (CXMT) впервые выпускает небольшими партиями память HBM3E — высокоскоростную память для современных ИИ-процессоров. По данным The Information, компания технически отстаёт от Samsung, SK Hynix и Micron на 3–5 лет и сталкивается с низким выходом годных чипов: в июне SemiAnalysis оценивала его примерно в 25%. При этом в ходе первичного размещения акций в Шанхае CXMT привлекла $8,6 млрд, но, согласно проспекту, ни одно из этих средств не направлено на HBM.

OpenAI и конкуренты закупают десятки тысяч Mac mini для обучения компьютерных агентов

OpenAI и другие ИИ-лаборатории закупили десятки тысяч компьютеров Mac mini и Mac Studio, сообщает The Information. OpenAI использует их для обучения ИИ-агентов, которые самостоятельно выполняют многошаговые задачи на компьютере. Компания хочет приобрести ещё больше устройств, но самые мощные модели Mac уже несколько месяцев распроданы из-за дефицита микросхем памяти. Anthropic тоже подключилась к закупкам и арендует Mac mini через AWS.

NVIDIA показала, как ИИ-агенты создают лёгкие среды выполнения USD

NVIDIA представила nanousd-labs — экспериментальный проект, который использует ИИ-агентов для генерации лёгких сред выполнения USD напрямую из спецификации USD Core. Такой подход позволяет создавать реализации под конкретные ограничения по памяти, производительности, языку и ABI, не адаптируя большой существующий код. nanousd написан на C++ и предоставляет стабильный C API, а пакет nanousd-python работает без GPU и запускается без графического интерфейса на любой машине. Проект опубликован в составе NVIDIA Omniverse Labs.

Отчёт Nvidia подтвердил высокий спрос на ИИ — но раскрыл, где накапливаются риски

Квартальный отчёт Nvidia подтвердил высокий спрос на ИИ: выручка во втором квартале выросла на 106% год к году, до $96,2 млрд, причём $89 млрд принесло подразделение центров обработки данных. Гендиректор Jensen Huang спрогнозировал рост выручки центров обработки данных на 70% в 2028 финансовом году, который начнётся в конце января 2027 года. Платформа Vera Rubin уже набирает производство быстрее всех предыдущих продуктов Nvidia, но дефицит памяти давит на маржу. Одновременно пять клиентов формируют 70% дебиторской задолженности компании, а её прямые обязательства по ИИ-инфраструктуре достигают значительных масштабов. Чтобы распределить риски, Nvidia договорилась с финансовыми организациями привлечь для клиентов более $500 млрд стороннего капитала.

Как запустить чат-бота на собственном компьютере

Большие языковые модели, на которых работают ChatGPT и Gemini, можно запускать не только через облачные сервисы, но и локально — на собственном компьютере. Это даёт доступ без интернета, повышает приватность и избавляет от ежемесячной платы и ограничений по числу запросов. Бесплатные модели выпускают даже Meta и Google: обычно они уступают платным по скорости и возможностям, но подходят для повседневных задач. Локальные модели работают на Windows, macOS и Linux, а для запуска понадобятся программа-оболочка, сама модель и достаточный объём оперативной памяти.

Можно ли научить ИИ-агента делать покупки как человек

Можно ли научить ИИ-агента ходить по интернет-магазину не как бездумный робот, а как настоящий покупатель — с памятью, сомнениями и понятной целью? Исследователи предлагают агента, который рассматривает страницы магазина как человек и запоминает не всё подряд, а только нужное: что он ищет сейчас, какие товары уже видел и какие предпочтения постепенно складываются. Вместо оценки каждого отдельного клика его учат по результату всей сессии, чтобы он не листал страницы бесконечно и не останавливался слишком рано, а действовал последовательно и правдоподобно. В этом обзоре разбираем, как устроен такой ИИ-покупатель, почему обычные способы обучения плохо передают поведение людей и как проверяют сходство его решений с действиями реальных пользователей.

ИИ-агентов научили управлять памятью во время долгих задач

Когда ИИ-агент долго решает задачу, он легко тонет в собственных заметках и начинает путаться в том, что было важным. Исследователи предлагают дать агенту более человеческий способ работы с памятью: не тащить всё перед собой, а самому решать, что можно свернуть, убрать во внешнее хранилище и потом вернуть по мере надобности. Так он меньше захлёбывается в лишних деталях, дольше держит ход мысли и стабильнее доводит сложные задачи до конца. В этом обзоре разбираем, как ИИ-агента научили управлять своей памятью во время длинной работы и почему это помогает ему лучше искать решения и писать код.

Наконец-то ИИ научили месяцами вести сюжет без потери памяти о героях и мире

Обычная проблема почти всех литературных ИИ-симуляций проста: персонажи умеют говорить «в образе», но не умеют жить дальше. Они хорошо копируют манеру речи Шерлока Холмса или Элизабет Беннет, но через несколько сцен начинают разваливаться. Кто-то внезапно забывает свои мотивы. Кто-то меняет характер без причины.

Что мешает ИИ нормально искать ответы в интернете

Почему ИИ так часто ходит по кругу, когда ищет ответ в интернете, и в итоге приносит не то, что нужно? Исследователи предлагают устроить поиск так, чтобы ИИ не держал весь ход работы у себя «в голове», а записывал, что уже найдено, чего ещё не хватает и какие ходы уже ни к чему не привели. Тогда несколько ИИ-агентов могут работать как команда: один ищет факты, другой следит за пробелами, третий не даёт снова повторять бесполезные попытки. В итоге поиск становится не хаотичным набором запросов, а более собранной работой с понятным планом. В обзоре разберём, почему ИИ застревает в веб-поиске, как ему предлагают дать общую «память» о ходе работы и за счёт чего такой подход помогает находить ответы полнее и аккуратнее.

ИИ для смартфона и очков учится помнить жизнь

Что, если телефон или умные очки смогут не просто слушать и смотреть, а по-настоящему помнить куски вашей жизни? Исследователи предлагают лёгкую систему памяти для ИИ-помощника, который живёт в смартфоне или очках и постепенно собирает то, что человек видел и слышал. Она раскладывает события по разным слоям памяти — что происходит сейчас, что было недавно и что случилось давно, — а потом достаёт нужное, когда вы спрашиваете, где лежит вещь, о чём был разговор или как обычно проходит ваш день. В этом обзоре разбираем, как такой помощник учится помнить повседневную жизнь и как он находит нужный момент среди множества увиденного и услышанного.

Оказалось, память может быть важнее самого мышления

Оказалось, что для ИИ иногда важнее не лучше думать, а лучше помнить. Исследователи предлагают учить модель не только решать задачу, но и самой разбираться со своей памятью: что сохранить, когда к этому вернуться и как разложить знания так, чтобы потом не потеряться. Для этого команда дала ИИ право управлять своими записями и отдельно улучшала две вещи: как устроена сама память и насколько умело модель ею пользуется. В итоге даже без изменений в самом способе рассуждать ИИ начинает заметно лучше справляться с длинными и запутанными задачами. В этом обзоре разбираем, почему умение обращаться с памятью можно развивать отдельно, как ИИ учат на его собственных удачных решениях и что это меняет для сложных задач, где ошибка может аукнуться намного позже.

Готовы ли ваши агенты к AI-Native памяти?

Память ИИ-агента — это уже не мелкая деталь, а место, где часто решается, будет он полезным или начнёт путаться. Авторы показывают, что память у таких систем надо оценивать не только по конечному ответу, но и по тому, как она хранит, достаёт, обновляет и приводит в порядок сведения по ходу работы. Это важно, потому что один и тот же подход может хорошо работать в одной задаче и проваливаться в другой, а лишние перестройки памяти могут стоить дорого и только мешать. В этом обзоре разбираем, из каких частей на деле состоит память ИИ-агента, почему не существует одного лучшего решения для всех случаев и какой способ поддержки памяти оказывается самым разумным на практике.

Что на самом деле делает мультиагентные системы умнее

Вокруг современных агентных систем для LLM сложился почти культ инженерной сложности. Оркестраторы, субагенты, память, библиотеки навыков, вызовы инструментов — все это выглядит впечатляюще, но оставляет важный вопрос…

Архитектура общей памяти агентов для программирования

У агентов для программирования есть одна слабость: они отлично пишут код, но часто повторяют одни и те же ошибки, как стажёр, который каждый раз заново узнаёт, что перед коммитом неплохо бы прогнать тесты. Последний год исследователи активно учат такие системы пользоваться памятью — сохранять удачные и неудачные ходы, а потом опираться на них в…

Как ИИ-агенты учатся помнить через окружающий мир

В AI мы привыкли думать о памяти как о чём-то, что находится внутри агента: в скрытом состоянии RNN, в параметрах сети, в буфере опыта, в KV-cache, наконец. Но что, если часть памяти можно буквально вынести наружу — в саму среду? Не в метафорическом смысле, а вполне формально: так, что агенту действительно нужно меньше внутренней памяти, если мир…

Двунаправленная память: как основа эволюции агентов, которые помнят прошлые шаги

Сегодняшние «глубокие» AI-агенты умеют не только продолжать текст, но и ходить в поиск, вызывать инструменты, собирать факты из разных источников и шаг за шагом решать сложные вопросы. Сегодняшние «глубокие» ИИ-агенты умеют использовать поиск, вызывать инструменты, собирать факты из разных источников и шаг за шагом решать сложные вопросы. Но на…

ИИ не может запустить стартап — и вот почему

Агенты хорошо справляются с короткими задачами, но на длинной дистанции их подводят память, непоследовательность и неумение следовать стратегии. ИИ‑агенты уже научились неплохо решать задачи, где нужно сделать десяток действий, вызвать пару инструментов и выдать ответ. Но стоит растянуть задачу на сотни шагов — как в реальной работе — и…

Агентный RAG против модульного: что реально лучше на практике

RAG сегодня — один из самых практичных способов подключить LLM к внешним знаниям: модель не полагается только на собственную память, а сначала ищет нужные фрагменты в базе знаний и уже потом отвечает. В реальных продуктах это выглядит как спасение от галлюцинаций и устаревших фактов. Но у…

Как превратить GitHub в память для ИИ-агента

Когда LLM научились писать код, вокруг них быстро выросли автономные SWE-агенты: системы, которые умеют открывать репозиторий, запускать тесты, находить место ошибки и готовить патч. Но у таких агентов есть неприятная привычка работать так, будто они впервые видят подобный баг. На практике же…

Почему ИИ-агенты не помнят собственную жизнь — и как агенту Софье дали автобиографию, мотивацию и долгосрочную память

Сегодня ИИ-агенты умеют планировать, вызывать инструменты, выполнять цепочки действий и даже работать в мультиагентной системе. Но у большинства таких решений есть неприятная особенность: они по сути реактивны. Агент может отлично отвечать в моменте но после развёртывания редко меняет…

Проактивная память: как ИИ-агенты научились сворачивать контекст и думать на 100 шагов вперёд

Задачи, которые требуют навыков использования инструментов и многократного поиска в интернете, обычно создают длинные сценарии, которые ломают большинство LLM-агентов: либо они просто копят всю историю, что достаточно больно для использования в контексте, либо сжимают всю историю на каждом шаге,…

Как агент учится на ходу: почему память оказалась сильнее дообучения

Большие языковые модели отлично решают короткие тесты на логику и код. Но в реальной работе задачи растягиваются на десятки и сотни шагов, требуют переключения между разными приложениями, аккуратного ведения контекста и умения исправлять собственные ошибки. Главная проблема тут в том, что на…

Память для роботов: как машины учатся видеть мир осознанно

Сегодня многие ИИ-агенты остаются реактивными: видят кадр — действуют, видят следующий — снова действуют, а связной картины мира не формируют. Отсюда проблемы с дальними маршрутами, переиспользованием опыта и гибкостью. В биологии это решено элегантно: мозг хранит ориентиры, маршрутное знание и…

Как дообучать LLM на лету с помощью памяти вместо файнтюнинга

Когда мы просим большую языковую модель (LLM) решить сложную задачу, один красивый промт уже не спасает. В реальности это последовательность действий: надо искать, читать, писать код, проверять, исправлять. Агент должен планировать шаги, пользоваться инструментами и помнить предыдущий опыт. Но…