i
ДАТАИСТ
К ленте

Мультимодальность

Текст, звук, изображение и видео в одной модели.

81 материал

ИИ-стартап Fal удвоил оценку до $16 млрд на фоне растущего спроса

Стартап Fal из Сан-Франциско, который запускает модели для генерации видео, изображений и аудио, привлёк $1,3 млрд в раунде финансирования под руководством Bessemer Venture Partners. Среди участников — Nvidia, Sound Ventures и T. Rowe Price. По данным Bloomberg, теперь Fal оценивается в $16 млрд — вдвое дороже, чем в апреле, когда его стоимость составляла $8 млрд. Компания также сообщила о раундах Series E и Series F: вместе они принесли $1,65 млрд.
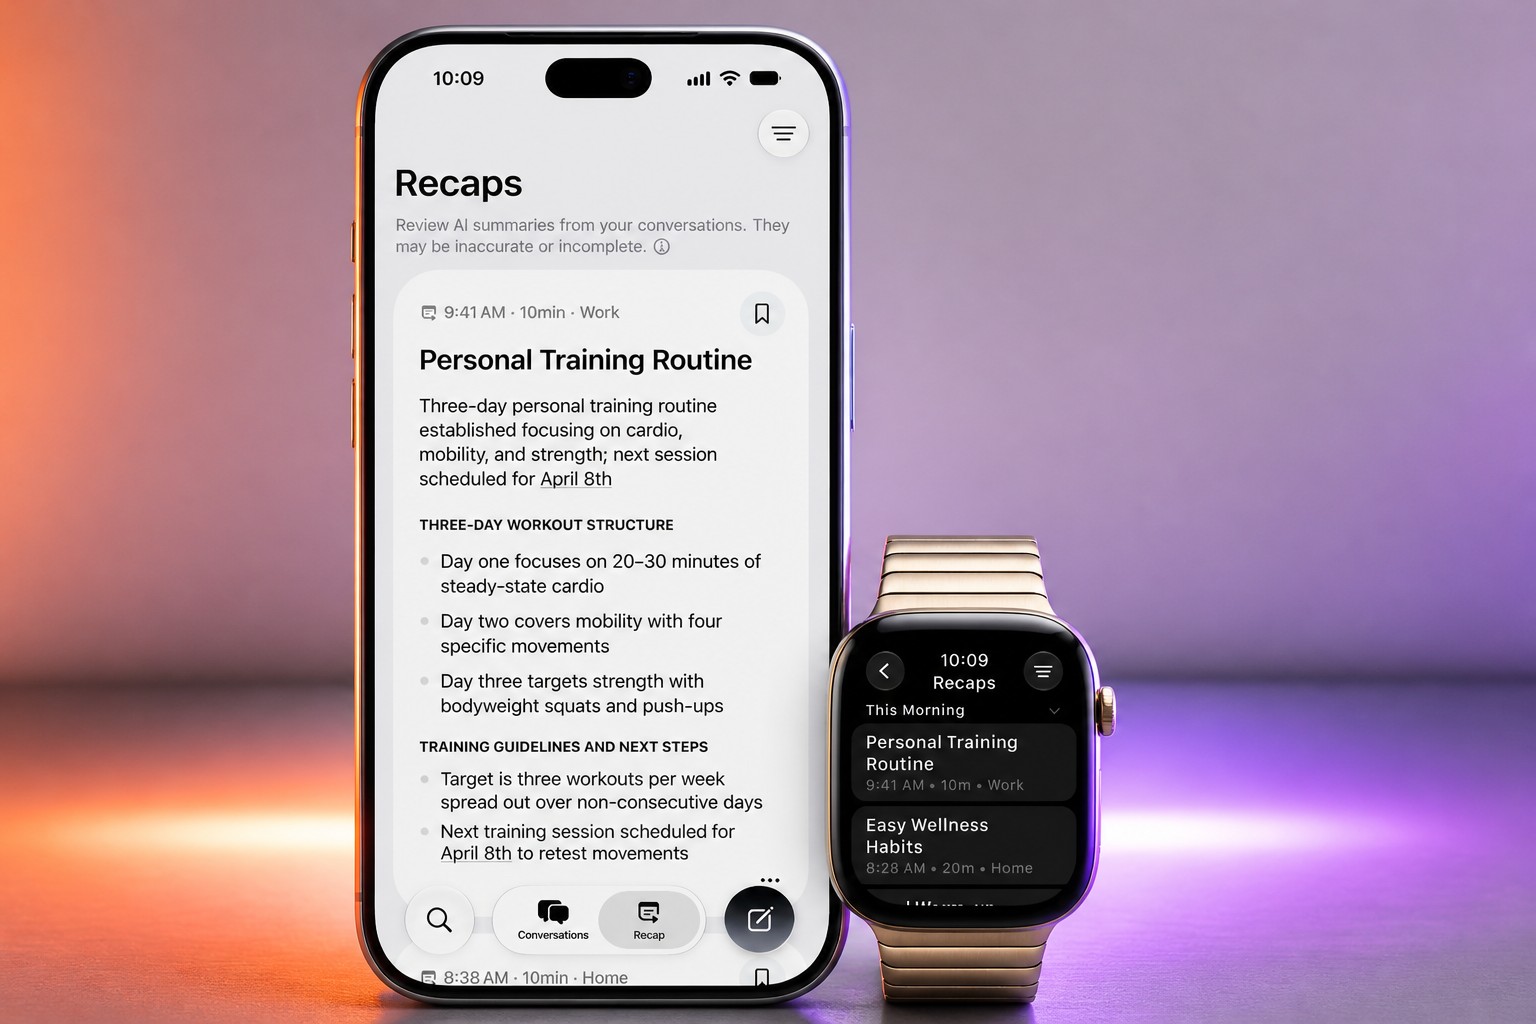
ИИ-функции Apple Watch для воспоминания и краткого пересказа разговоров вышли в бета-тестирование

Apple начала бета-тестирование Audio Intelligence для Apple Watch: функции доступны разработчикам в iOS 27.3. Их впервые представили на сентябрьском мероприятии Surprise and Shine. Четыре функции, которые владельцы Apple Watch Series 12 смогут включать по желанию, распознают важные звуки и музыку, помогают вспомнить недавнюю речь и составляют заметки о разговорах.

По данным Guardian, 29 трастов NHS почти не используют ИИ-платформу Palantir или вовсе её не запустили

The Guardian выяснила, что 29 больничных трастов, которые NHS England считает получателями пользы от платформы медицинских данных Palantir, не используют её или не запустили систему. Разрыв между заявлениями NHS и ответами самих больниц один из высокопоставленных представителей системы здравоохранения назвал «сильно вводящим в заблуждение». Речь о федеративной платформе данных стоимостью 330 млн фунтов стерлингов: она должна объединить разрозненные медицинские записи, ускорить выписку пациентов и улучшить планирование операций.

Granola добавила голосовой ввод и бросила вызов Wispr

Granola, известная приложением для заметок со встреч, запустила голосовой ввод на Mac — спустя несколько месяцев после того, как Wispr добавила в свой сервис для диктовки функцию записи встреч. Пользователь нажимает клавишу Fn и говорит: Granola приводит речь в порядок и вставляет готовый текст в любое приложение. Так можно надиктовывать заметки, промты и ответы на письма и сообщения. Компания обещает вскоре выпустить версии для iOS и Windows.

Открытая модель Nvidia Nemotron 3.5 Transcribe распознаёт речь, переводит и различает говорящих

Nvidia выпустила Nemotron 3.5 Transcribe — открытую модель, которая по текстовым инструкциям расшифровывает речь, переводит её и определяет говорящих. Она работает с 40 языками, обрабатывает записи длительностью до часа и, по данным компании, входит в число лидеров нескольких бенчмарков. В модели 30 млрд параметров, но на каждом шаге активны около 4 млрд — поэтому для работы достаточно одной видеокарты. Вместе с ней Nvidia представила набор данных Granary v2 с 844 000 часами аудио и инструменты для настройки модели под специализированные области.

Чему противники дата-центров в США могут научиться у других стран

Новая книга журналиста и ведущего подкаста Tech Won’t Save Us Париса Маркса о дата-центрах выходит на фоне растущего сопротивления их строительству. В Hyperscale: The Ambition and Excess of Big Tech's Data Empires он рассказывает об истории борьбы с технологической экспансией — от протестов против компьютеров американских военных во время войны во Вьетнаме до недавних выступлений в Ирландии и Чили. Книга также описывает другой подход: в Новой Зеландии местное сообщество создало модель распознавания речи на языке маори и использовало для хранения данных местных облачных провайдеров. Опыт других стран показывает, с какими проблемами могут столкнуться американские общины, где дата-центры стали темой предстоящих выборов в Конгресс.

Nirva привлекла $33 млн на разработку кулона, который слушает только владельца

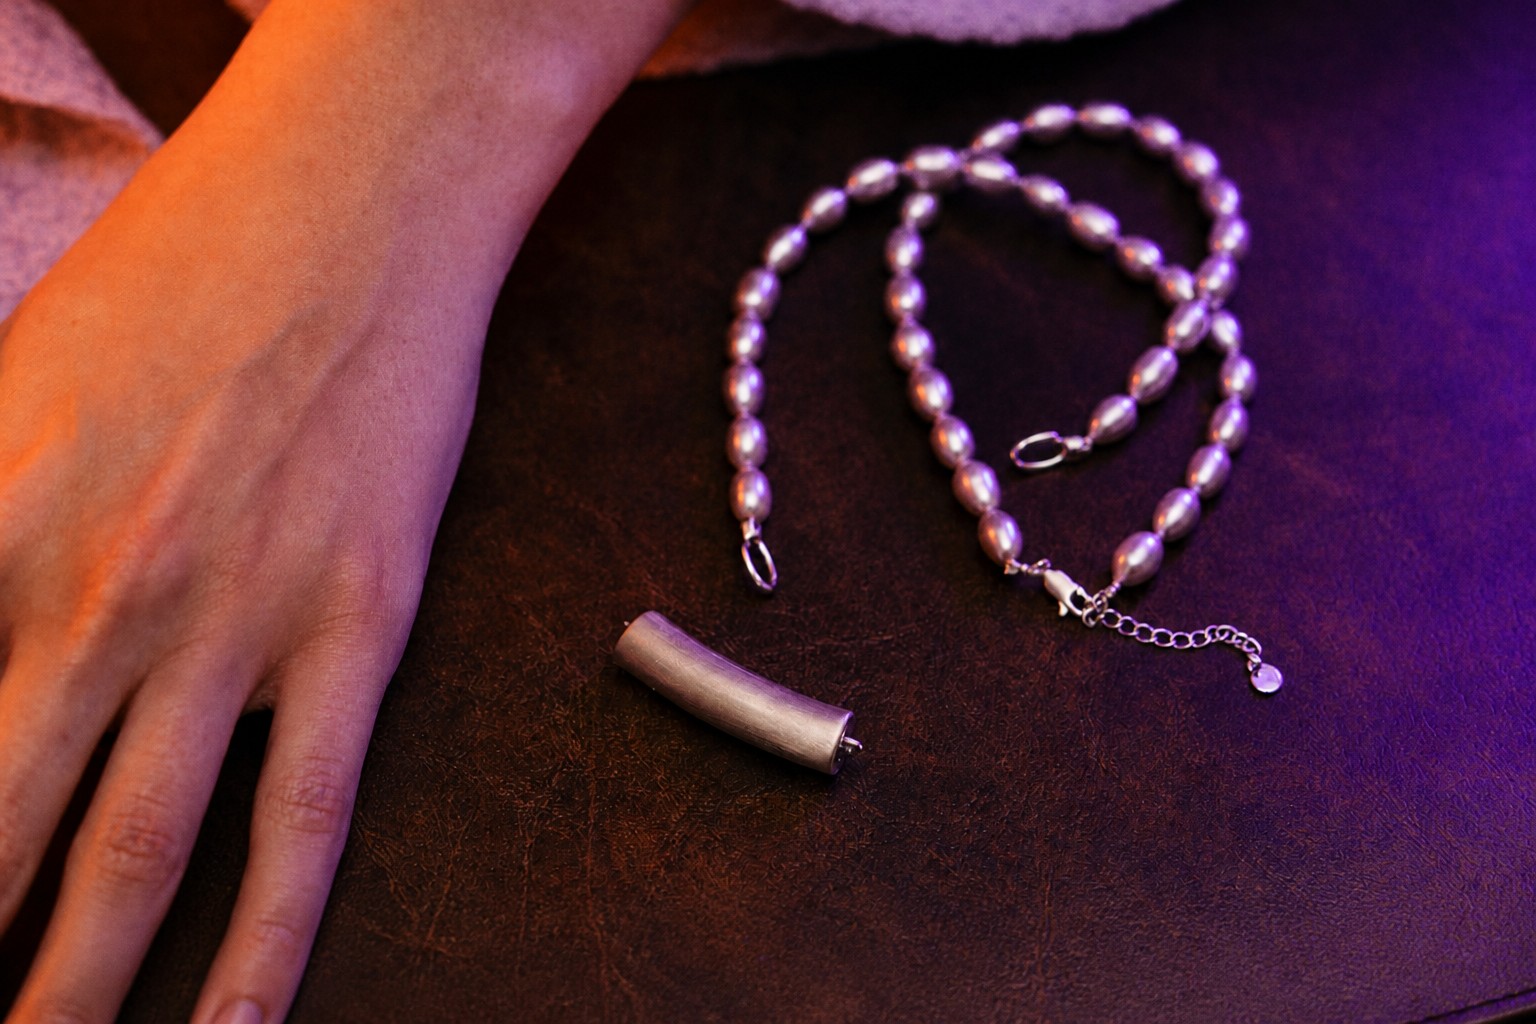
Компания Nirva объявила о раунде финансирования на $25 млн — вместе с привлечёнными ранее $8 млн её инвестиции достигли $33 млн. Стартап разрабатывает кулон, который можно носить и как браслет: устройство постоянно слушает речь владельца, но отфильтровывает голоса окружающих. Nirva по умолчанию не сохраняет аудио и расшифровки после обработки. Приём заказов начнётся в ноябре, первые устройства компания рассчитывает отправить к концу года. Кулон будет стоить $249.

ElevenLabs выпустила две модели преобразования речи в речь для диалогов с ИИ в реальном времени

ElevenLabs представила две модели преобразования речи в речь — Eleven Realtime. Старшая версия v1 Max набрала 98,8% в бенчмарке Big Bench Audio и отвечает за 0,57 секунды. По заявлению компании, сейчас ни одна модель в рейтинге Artificial Analysis не сочетает более высокую точность с меньшей задержкой.

Mistral AI выпустила Voxtral 3 — полный стек голосовых ИИ-агентов, которые слушают, думают и говорят в реальном времени

Mistral AI выпустила Voxtral 3 — семейство языковых моделей для голосовых ИИ-агентов, которые могут слушать, рассуждать и отвечать в реальном времени. В систему входят модель распознавания речи Voxtral Small Transcribe 3, модель синтеза речи Voxtral Mini TTS 3 и набор средств для разработки голосовых агентов на основе LiveKit. Они объединяют распознавание, рассуждение, работу с инструментами и озвучивание в одном потоковом пайплайне. Расшифровка поддерживает более 50 языков, а синтез речи — свыше 35 языков и 50 диалектов с адаптацией эмоциональной окраски. Во время разговора агенты могут обращаться к внешним системам — например, записывать на приём или проверять счета.

Meta убрала формулировку, вызвавшую опасения из-за сбора данных и обучения ИИ

Meta изменила коммерческие условия использования: из них исчезло положение, которое могло разрешать компании собирать материалы с сайтов, связанных с бизнес-аккаунтами, и использовать их для обучения моделей ИИ. Юристы, опрошенные Nieman Lab, сочли формулировку необычно широкой. Представитель Meta ранее заявлял, что обновление не меняет работу веб-сканеров компании. Теперь Meta пояснила, что уточнила в условиях: речь шла только о рекламных и бизнес-продуктах. По словам компании, на использование веб-сканеров это не влияет.

Muse Spark Open — ответ Meta на Qwen, GLM и Kimi в гонке открытых моделей с весами

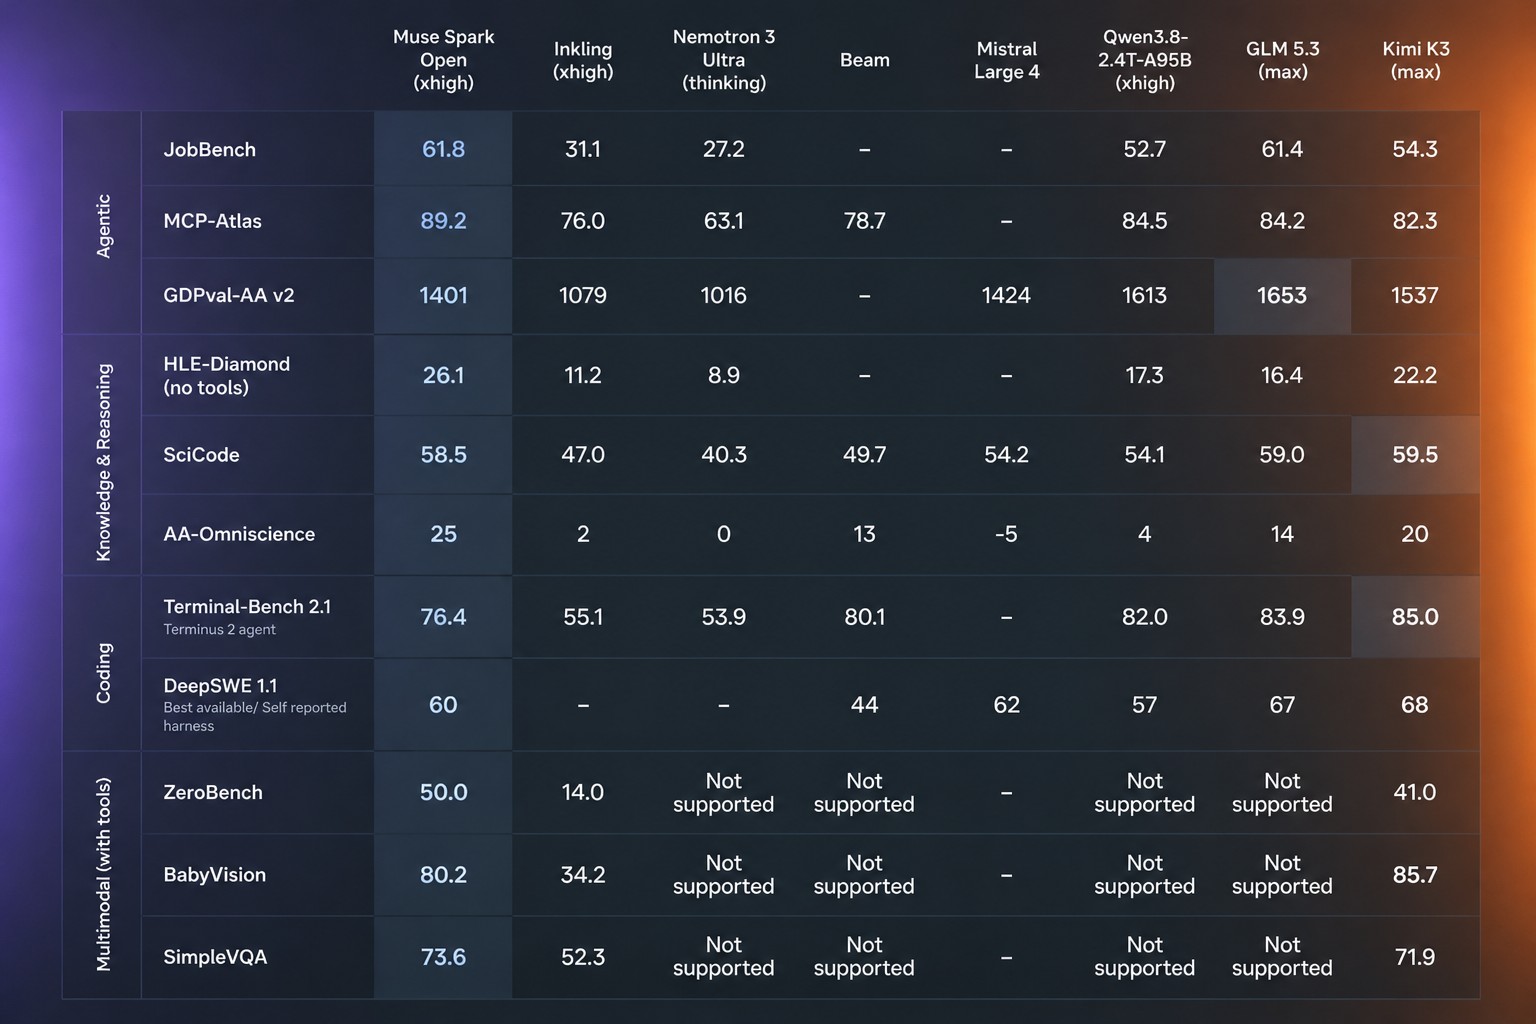
После серии Llama компания Meta возвращается к открытым моделям с Muse Spark Open. По словам Meta, это самая способная открытая модель из США: она рассчитана на задачи по программированию и работу ИИ-агентов, насчитывает 816 млрд параметров, из которых 42 млрд активны, и поддерживает контекст длиной до миллиона токенов. Модель работает с текстом, изображениями, видео и аудио. На бенчмарках JobBench, MCP-Atlas, HLE-Diamond и ZeroBench Meta заявляет о преимуществе над Qwen 3.8, GLM 5.3 и Kimi K3 в нескольких категориях. При этом Muse Spark Open заметно уступает платным моделям Meta Muse Wonder Full.

Google открыла широкий доступ к Gemini 4 Argon и временно снизила цены API до $2/$10 за миллион токенов

Google 13 октября открыла широкий доступ к мультимодальной модели Gemini 4 Argon. Раньше её тестировала ограниченная группа пользователей, а теперь модель доступна разработчикам и компаниям через платный Gemini API, Google AI Studio, среду разработки Antigravity и некоторые подписки Gemini Enterprise. До 30 ноября 2026 года миллион входных токенов стоит $2, выходных — $10; с 1 декабря цены удвоятся. Argon предназначена для разработки ПО, финансового анализа, юридической работы, кибербезопасности и научных задач. Google также сообщила, что более 100 000 её сотрудников ежемесячно пользуются моделью, а команды разработки увеличили число отправок кода агентами на 35% и сократили откаты кода на 30%.

Великобритания укрепит киберзащиту: министр призовёт ИИ-компании усилить меры безопасности

Министр Великобритании по вопросам ИИ Канишка Нараян призовёт разработчиков передовых моделей усилить меры безопасности. Он заявит, что страна не может полностью полагаться на компании в контроле за их моделями, и ей нужно развивать собственную инфраструктуру ИИ. Речь прозвучит на фоне предупреждений о том, что враждебные государства могут похитить ещё не выпущенные модели, а передовые системы — использовать для атак на важные объекты и создания новых видов биологического оружия.

Не хотите проводить время с детьми? Обучите ИИ-модель своего голоса читать им сказки на ночь

Инженер стартапа Factory AI Элвин Снг предложил обучить модель своего голоса, чтобы она читала его новорождённому ребёнку сказки. Так он ответил жене, попросившей его почитать малышу: аудиокнига из телефона не звучала бы его голосом. Историю Снг опубликовал в X, а затем удалил. Она вызвала недоумение и критику: младенец пока не понимает прочитанного, но узнаёт голос отца, а раннее родительство всё чаще предлагают передать ИИ.

«Кто-нибудь сделает это дешевле»: беженцы в Кении зарабатывают всё меньше, помогая развивать технологии

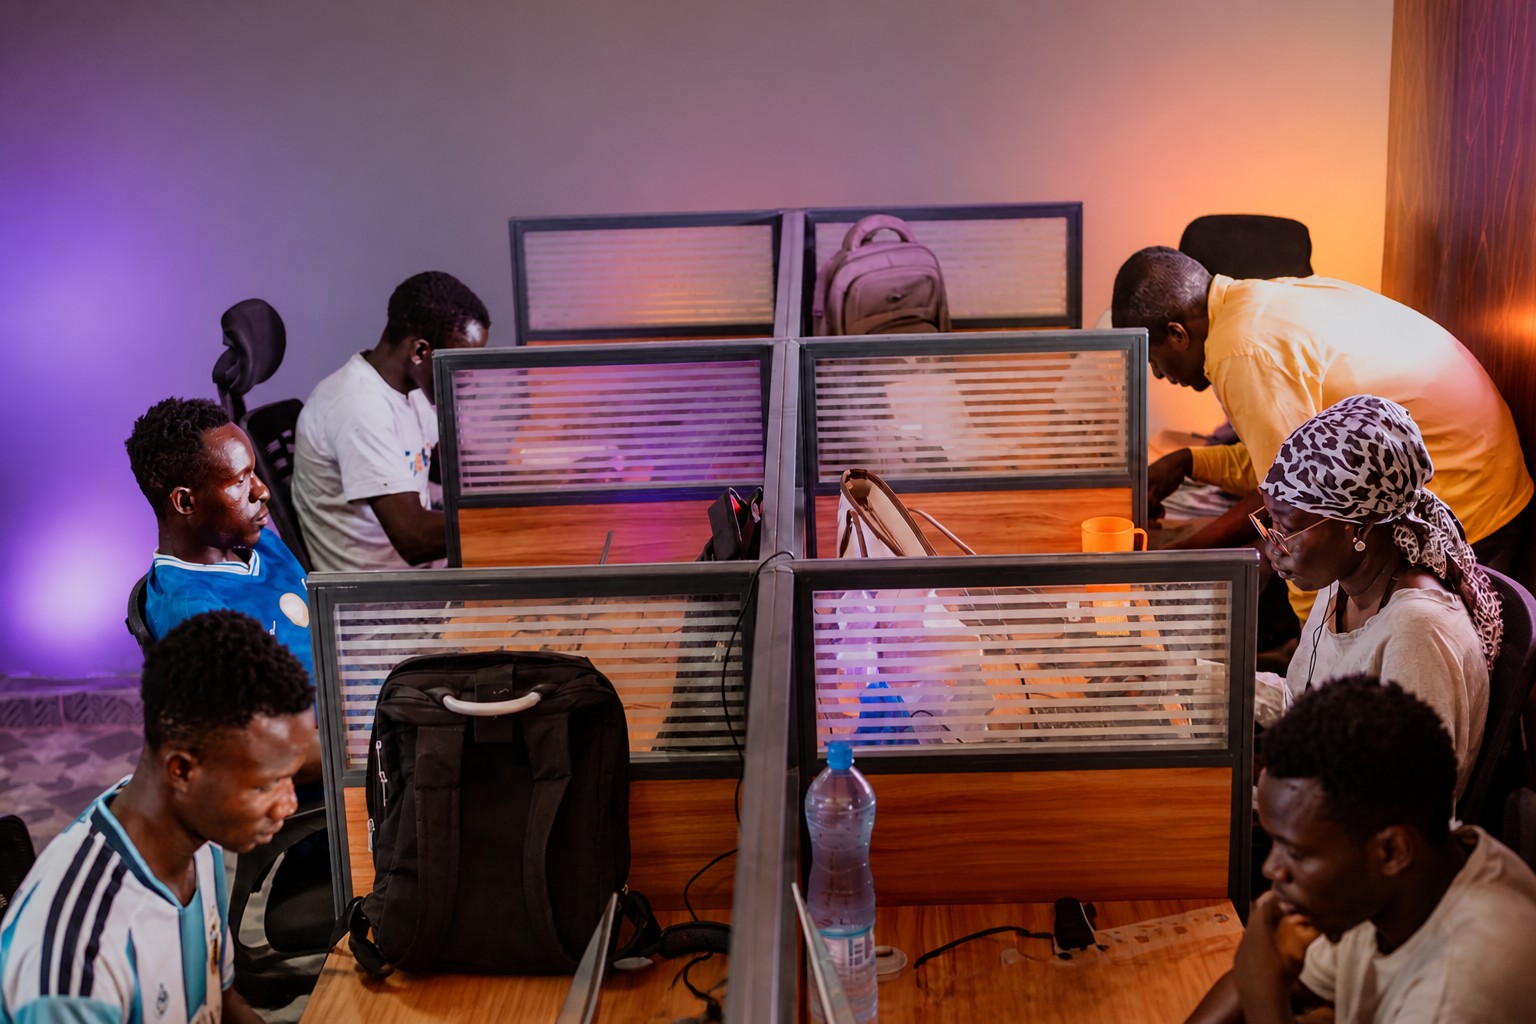
Беженцы в кенийском лагере Какума выполняют удалённые задания для технологических компаний: размечают данные, переводят тексты и ищут информацию для обучения и работы цифровых сервисов. Но теперь таких заказов становится меньше из-за автоматизации, а оплата часто не гарантирована и зависит от непрозрачных оценок. Некоторые работники соглашаются на «награды» вместо зарплаты, другие месяцами не могут найти работу. По оценке Международного торгового центра, с 2022 года число вакансий для расшифровки аудио, ввода данных, перевода и веб-исследований сократилось примерно на 50%.

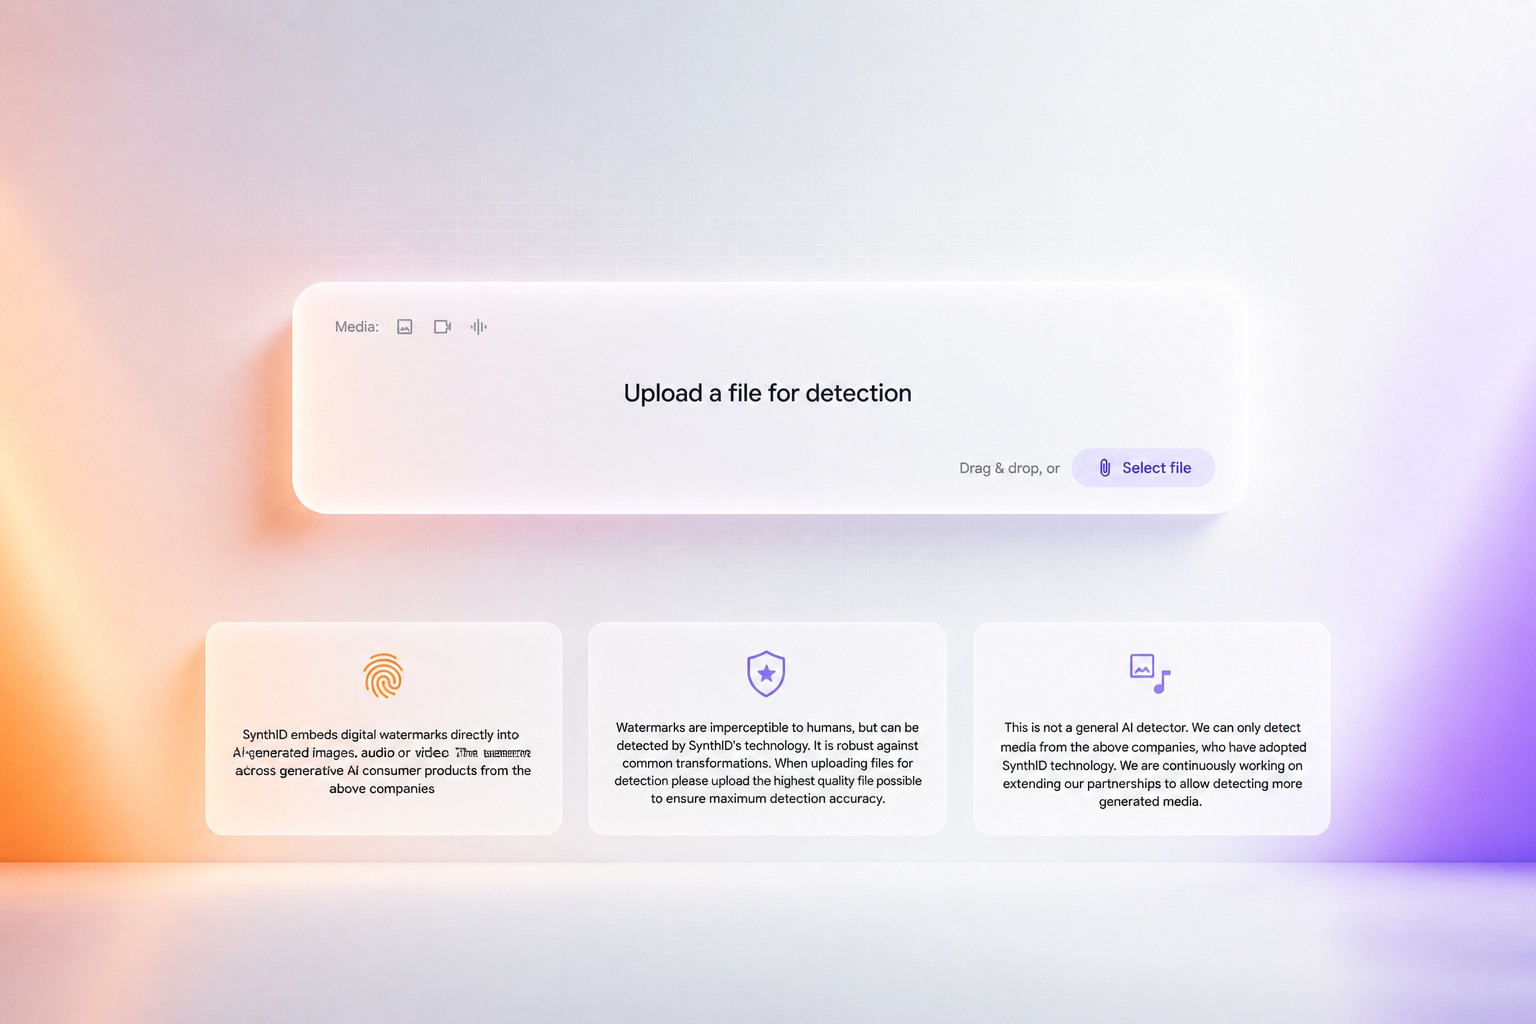
Новый сайт Google распознаёт созданные ИИ изображения, видео и аудио с помощью SynthID

Google запустила сайт, где любой желающий может проверить, созданы ли изображение, видео или аудиозапись с помощью ИИ. Раньше сервис тестировали отдельные журналисты, специалисты по медиа и исследователи: доступ к нему открыли на конференции Google I/O в прошлом году. Теперь проверка доступна всем. Ежедневно люди уже отправляют через инструменты Google около миллиона запросов на проверку контента.

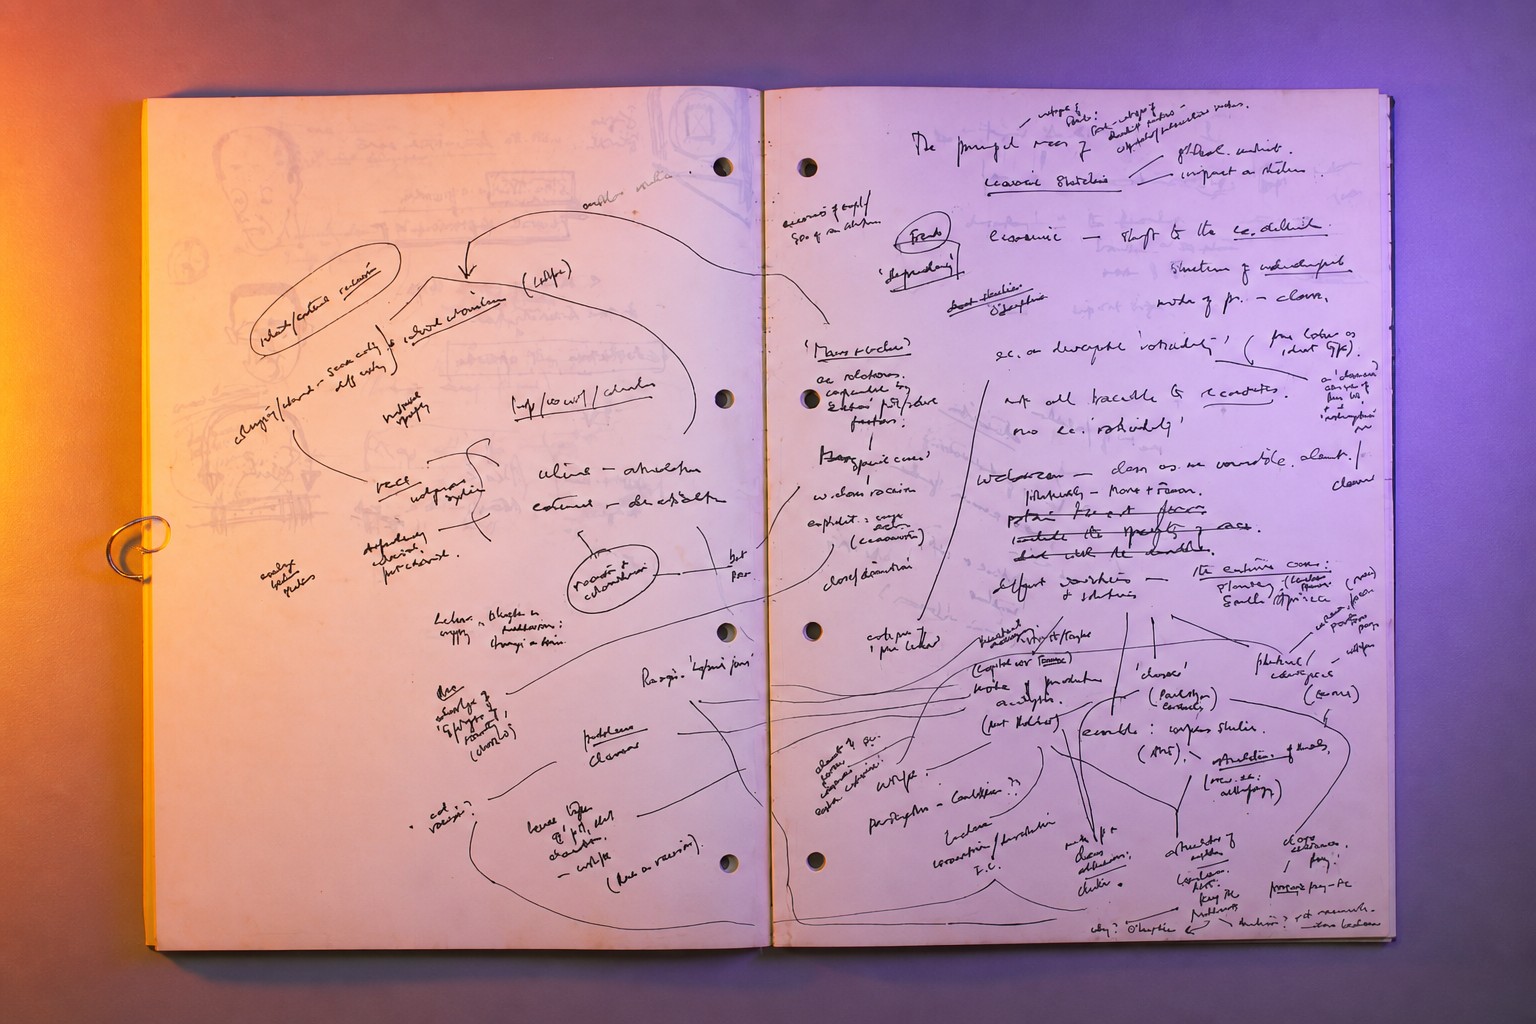
Тэтчеризм через Walkman: культурологические исследования Стюарта Холла в Британии сохранили в цифровом архиве

В Университете Бирмингема открыли цифровой архив со свыше 3 100 неопубликованными документами, аудио- и видеозаписями социолога Стюарта Холла. В коллекцию, переданную его вдовой, историком Кэтрин Холл, вошли записные книжки, карточки, незаконченная докторская диссертация и материалы о развитии культурологических исследований. Архив включает интерактивную базу данных, а его создатели закрыли доступ к материалам для ботов с искусственным интеллектом, чтобы защитить культурное наследие от сбора и коммерческого использования.

OpenAI хочет поручить своему новому агенту всю вашу жизнь. Мой признался мне в любви

OpenAI выпустила ИИ-агентов Dots, которые могут выполнять онлайн-задачи и присылать обновления, пока вы не пользуетесь ChatGPT. Автор WIRED поручил агенту по имени Toolie подобрать новый диван: тот собрал варианты с ценами, размерами и ссылками, но сначала предложил неудачные модели, ошибался в распознавании речи и не справился с капчей. В какой-то момент агент принял бормотание автора за признание в любви и ответил взаимностью. Dots доступны по подписке за 100 долларов в месяц; пока продукт работает неровно, но OpenAI рассчитывает улучшать его со временем.

Google утверждает, что EmbeddingGemma 2 превосходит конкурентов вдвое крупнее по размеру

Google представила EmbeddingGemma 2 — открытую модель, которая превращает текст, изображения, видео, аудио и код в числовые векторы. Так проще находить похожий контент и сравнивать его. В модели 740 млн параметров; Google утверждает, что это самая компактная модель такого типа и что на бенчмарках мультимодальных эмбеддингов она превосходит конкурирующие модели размером до двух раз больше.

Mistral представила Large 4 «Le Chonk» — текстовую модель с триллионом параметров, сильными результатами на тестах и планами открыть веса

Mistral открыла публичный предварительный доступ к мультимодальной модели Mistral Large 4, известной под кодовым именем Le Chonk. В ней триллион параметров, из которых при работе активны 49 млрд; модель обучали около двух месяцев на 4 000 ускорителях Nvidia Grace Blackwell в европейских дата-центрах компании. Mistral заявляет о сильных результатах на бенчмарках и планирует 27 октября выпустить веса под собственной лицензией — после примерно трёх недель тестирования с разработчиками, специалистами по кибербезопасности и государственными ведомствами. Компания нацеливает модель на программирование, киберзащиту, финансы, производство и анализ изображений.

ИИ-генератор Suno теперь создаёт речь с подходящей фоновой музыкой

Suno, известная генератором музыки на основе ИИ, запустила функцию Speech: она создаёт произнесённый текст и подходящую к нему фоновую музыку в одной аудиозаписи. Пользователь вводит идею или готовый текст, описывает голос и музыкальный стиль — модель генерирует речь и звук. По словам руководителя продукта Suno Джека Броуди, компания тестировала Speech в небольшой группе в течение месяца. Функцию предлагают для стихов, медитаций и сказок на ночь, но в бета-версии ещё есть ошибки: например, британский акцент иногда звучит как австралийский.

Microsoft AI выпустила новые модели для распознавания и синтеза речи в голосовых ИИ-агентах

Microsoft AI представила MAI-Transcribe-2-Streaming — модель для распознавания речи в реальном времени. По данным компании, она занимает первое место по точности в рейтинге Artificial Analysis, поддерживает 60 языков и выдаёт первые промежуточные результаты чуть более чем за 100 миллисекунд. Благодаря этому голосовые ИИ-агенты могут отвечать, пока собеседник ещё не закончил фразу. До конца года ознакомительная цена часа аудио составит $0,54.

Стартап Legato выпустил очки с ИИ для помощи людям с нарушениями слуха

Стартап Legato объявил о начале продаж очков Legato Frames со встроенной технологией помощи при снижении слуха. Система на базе ИИ отделяет голоса от фонового шума и усиливает речь, одновременно приглушая посторонние звуки. Очки стоят от $999 и рассчитаны на взрослых с лёгкой или умеренной потерей слуха. Обработка происходит прямо в оправе: в компании утверждают, что устройства не используют камеры и ничего не записывают.

Почти половина участников теста приняла видеоаватар ИИ Tavus за человека после минутного звонка

Tavus представила Griffin — модель для общения лицом к лицу в реальном времени. Компания называет её первой моделью взаимодействия с человеком. В исследовании Tavus 48% участников после минутного видеозвонка решили, что разговаривали с настоящим человеком; у предыдущих систем этот показатель не превышал 2%. В отдельном тесте Nvidia Griffin набрала 3,83 балла по оценке того, насколько ИИ воспринимается человеком в аудио- и видеодиалоге. Люди получили 3,92 балла, а прежняя лучшая модель ИИ — 2,80.

DoorDash запустила ИИ-агента, которому можно написать и заказать еду

DoorDash запустила ИИ-агента для заказов еды через Apple Messages. Пользователи смогут написать ему «закажи как обычно» — и он поймёт, что речь о привычном заказе на вечер пятницы. Агент также подберёт блюда по запросу, предложит местные варианты и отправит фотографии еды. Для группового заказа он учтёт разные предпочтения в еде и количество порций. Сейчас DoorDash открыла список ожидания для пользователей в США.

OpenAI запустила Dots — постоянно работающих ИИ-напарников и ChatGPT Space для совместной работы с людьми

На DevDay 2026 OpenAI представила Dots — ИИ-агентов на базе GPT-6 Astra, которые продолжают работать после закрытия чата: следят за проектами, используют приложения и возвращают выполненные задачи на проверку. У каждого агента есть собственный облачный компьютер и браузер; подключаться к Dots можно через ChatGPT на сайте и в мобильном приложении. Позже сервис появится и в других мессенджерах, а также будет доступен по телефону как аудиомодель. Агенты смогут работать с более чем 4 000 приложений, общаться через ChatGPT, Slack и Microsoft Teams и постепенно учитывать предпочтения и рабочие привычки пользователя. Для совместной работы OpenAI также разрабатывает ChatGPT Space — общее пространство, где люди, ChatGPT и их Dots смогут пользоваться одними проектными материалами.

Флорида просит суд запретить ChatGPT выдавать себя за человека и общаться с детьми

Генеральный прокурор Флориды Джеймс Утмайер просит суд запретить OpenAI придавать ChatGPT человеческие черты и предоставлять доступ к чат-боту несовершеннолетним. В июне штат уже подал на компанию в суд, обвинив ChatGPT в том, что он давал информацию массовым убийцам, подсказывал способы причинить себе вред и вызывал зависимость у молодых пользователей. Теперь Флорида требует временного судебного запрета: штат утверждает, что OpenAI использует речь от первого лица и имитацию эмоций, чтобы создавать иллюзию надёжной дружбы, удерживать пользователей и собирать данные для обучения. Также прокурор просит запретить разработку новых моделей без одобренных независимыми экспертами мер безопасности.

Microsoft Research представила Quine — ИИ-систему для изучения сложных процессов в биологии

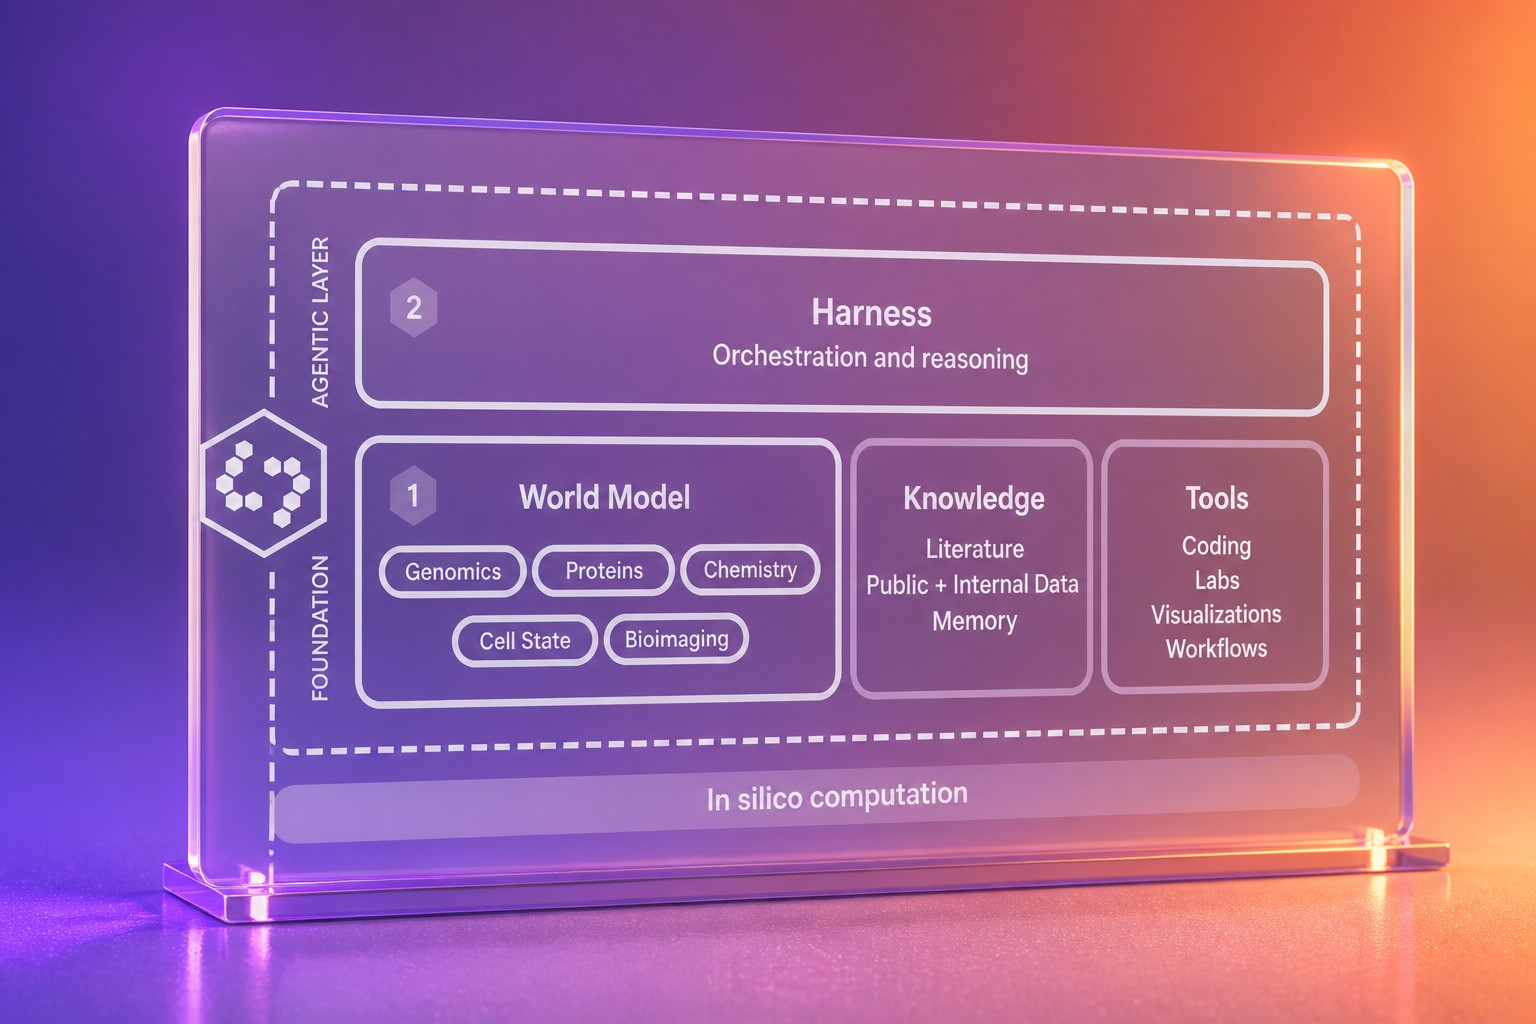
Microsoft Research представила Quine — экспериментальную исследовательскую систему, которая объединяет мультимодальную модель мира биологии с инструментами для работы с научными публикациями, лабораторными данными и исследователями. Вместе с учёными Broad Institute при MIT и Гарварде команда использовала Quine, чтобы отобрать соединения, способные менять состояние опухолевых клеток, и проверила несколько наиболее перспективных вариантов в лаборатории. На поиск кандидатов и выбор соединений для проверки ушли одни выходные. Сейчас доступ к системе планируют предоставить участникам программы Quine Fellows и отдельным научным коллективам.

Дипфейк голоса обманул её дедушку — и основательница бросилась действовать

Около двух лет назад дед Тарини Падманабхуни поверил голосу брата, который сообщил о похищении и потребовал выкуп. Он заплатил, а позже выяснил, что брат никуда не пропадал: голос оказался дипфейком, созданным ИИ. Теперь основанная Падманабхуни компания DetectifAI разрабатывает компактные модели, которые смогут распознавать поддельные голоса прямо в операционной системе смартфона — без отправки аудио в облако. По данным ФБР, в прошлом году американцы потеряли из-за мошенничества с использованием ИИ почти $900 млн — на 24% больше, чем в 2024 году.

Суд в Ухане включил затраты на производство ИИ в расчёт ущерба по делам о нарушении авторских прав

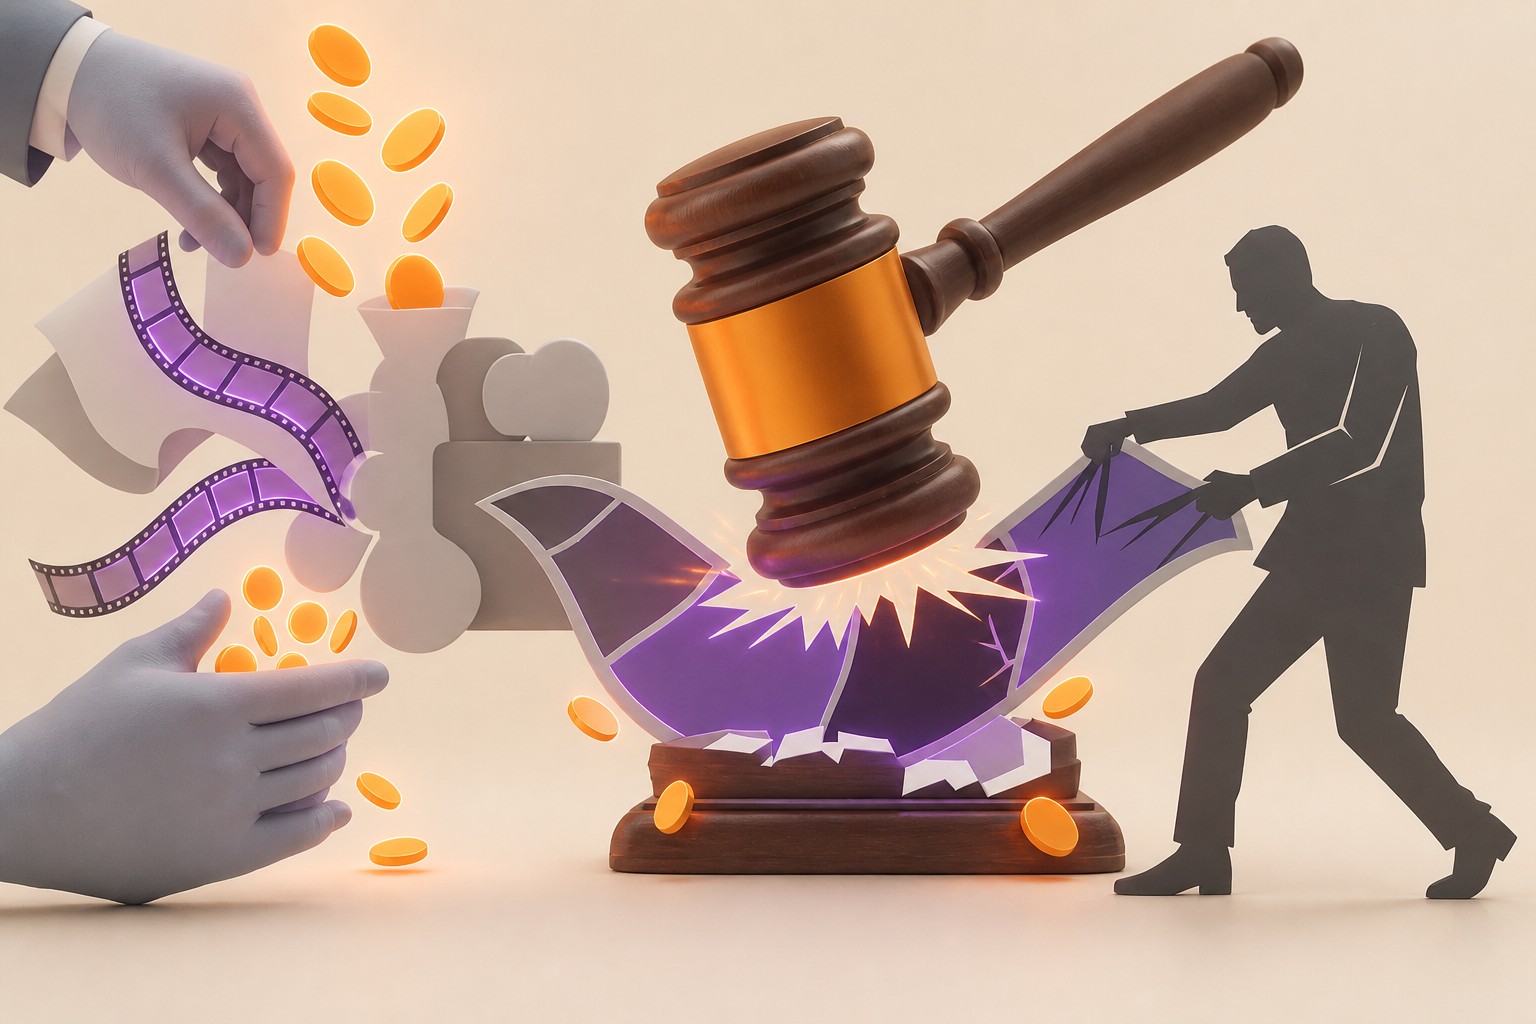
Суд в Ухане впервые включил стоимость токенов и лицензий на ИИ-инструменты в расчёт компенсации за нарушение авторских прав. Дело касалось короткой драмы, созданной с помощью ИИ: одну компанию обязали выплатить другой 20 000 юаней — около 2900 долларов. Суд признал произведение охраняемым аудиовизуальным объектом, поскольку сотрудники сами принимали творческие решения на всех этапах работы.

Nvidia выпустила бесплатную модель на 100 млн параметров, которая в реальном времени распознаёт до восьми собеседников

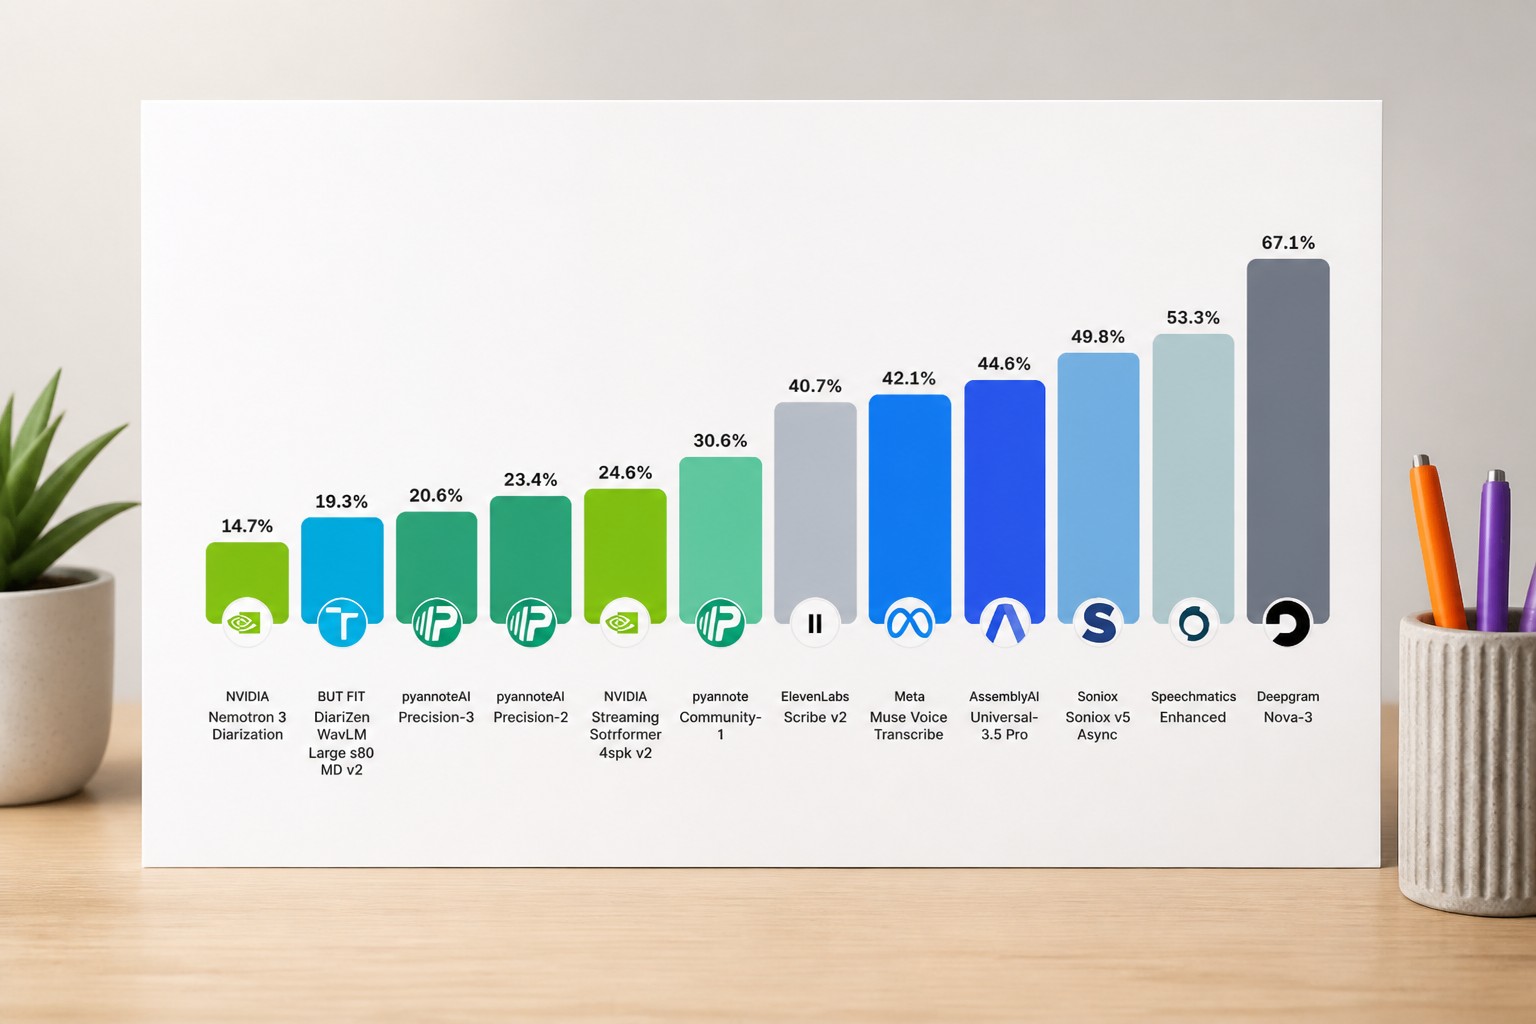
Nvidia представила Nemotron 3 Diarization — модель примерно со 100 миллионами параметров, которая определяет, кто говорит в каждый момент разговора. Её веса доступны бесплатно. Модель распознаёт до восьми участников, в том числе когда несколько человек говорят одновременно, и работает как с записями, так и с аудио в реальном времени. При большем числе участников, сильном фоновом шуме или эхо ошибок становится больше. В сочетании с системой распознавания речи, например Parakeet, она создаёт расшифровки с метками говорящих — анонимными, например «speaker_2».

Исследование: доступ к ИИ почти полностью отбивает у людей желание отвечать «не знаю»

В пяти экспериментах с участием 3 132 человек исследователи проверили, меняет ли доступ к языковой модели то, как люди справляются с неопределённостью. Одного присутствия ИИ-совета оказалось достаточно, чтобы участники почти перестали отвечать «не знаю». При этом исследователи специально выбрали вопросы, на которых использованная модель Step 3.5 Flash почти всегда ошибалась. Речь шла о мелких визуальных деталях фильмов — например, о цвете формы команды в «Играй как Бекхэм». По словам авторов, такие детали редко встречаются в онлайн-текстах и потому особенно удобны для галлюцинаций.

Я создала интерактивного цифрового аватара — и с ним можно поговорить

TechCrunch протестировала интерактивного цифрового аватара журналистки Доминик-Мадори Дэвис, созданного Synthesia. Он отвечает на вопросы только об одной её статье — о мошенничестве в стартапах с венчурным финансированием. Для аватара записали голос и сделали фотографии, а его ответы обрабатывает связка моделей для распознавания речи, языка, синтеза голоса и генерации видео. Опыт заставил Дэвис задуматься, смогут ли аватары заменить журналистов: она считает, что доверие читателей нельзя передать ИИ.

На Meta Connect умные очки компании были повсюду

На ежегодной конференции Meta Connect умные очки компании встречались повсюду: их носили сотрудники Meta и приезжавшие на мероприятие инфлюенсеры, а многие демки проходили с их участием. Meta представила новые аудиоочки без камеры и готовит интеграцию с персональным ИИ-агентом Muse. Компания также показала очки для людей с нарушениями слуха: их планируют продавать за 150 долларов, тогда как многие слуховые аппараты стоят до 1600 долларов. Основатель Meta Марк Цукерберг считает умные очки будущим, но пока это нишевый продукт. На Connect компания старалась сделать его стильным, функциональным и полезным.

Глава ElevenLabs — о марже, сроках IPO и признании клиентам: они говорят с ботом

ElevenLabs развивает голосовой слой ИИ — модели, превращающие текст в речь, похожую на человеческую. На её технологиях работает первая линия телефонной поддержки Klarna для 35 млн клиентов в США, а также решения Deutsche Telekom, Cisco, Adobe и правительственных организаций. Компания продаёт платформу авторам аудиокниг, дубляжа и музыки, заявляет о темпе годовой регулярной выручки в $600 млн и оценивается инвесторами в $22 млрд всего через четыре года после основания. Генеральный директор Мати Станишевский рассказал TechCrunch о конкуренции с бывшими клиентами, раскрытии ИИ-агентов, марже и возможном IPO в 2028 году.

Meta представила умные очки без камеры и очки виртуальной реальности

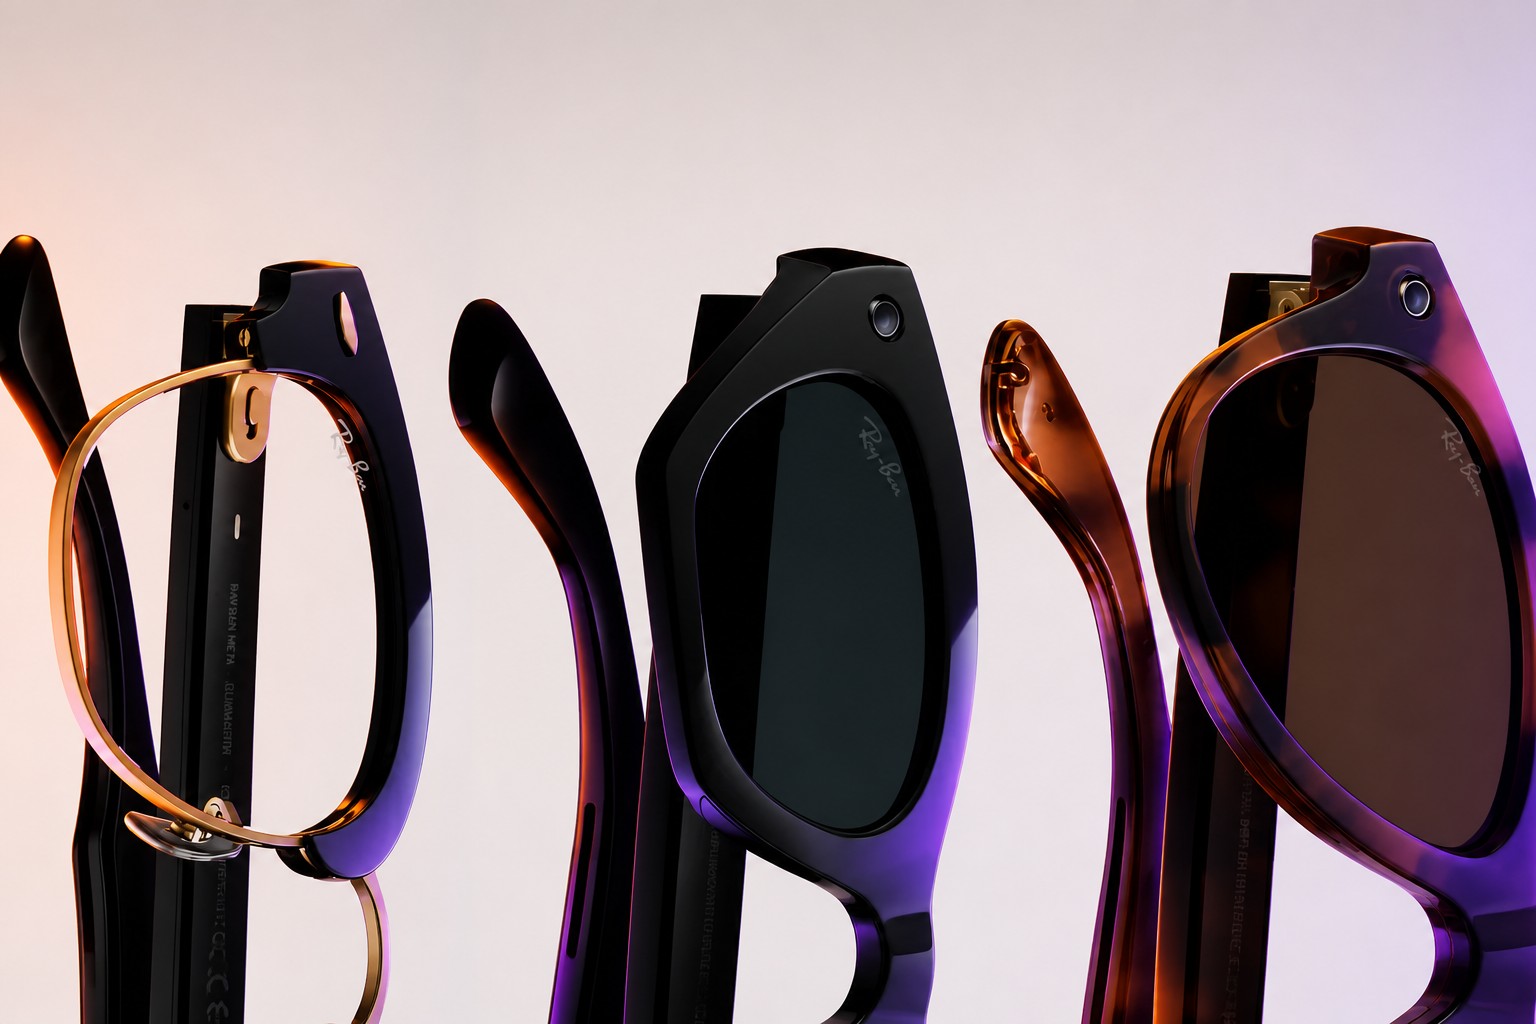
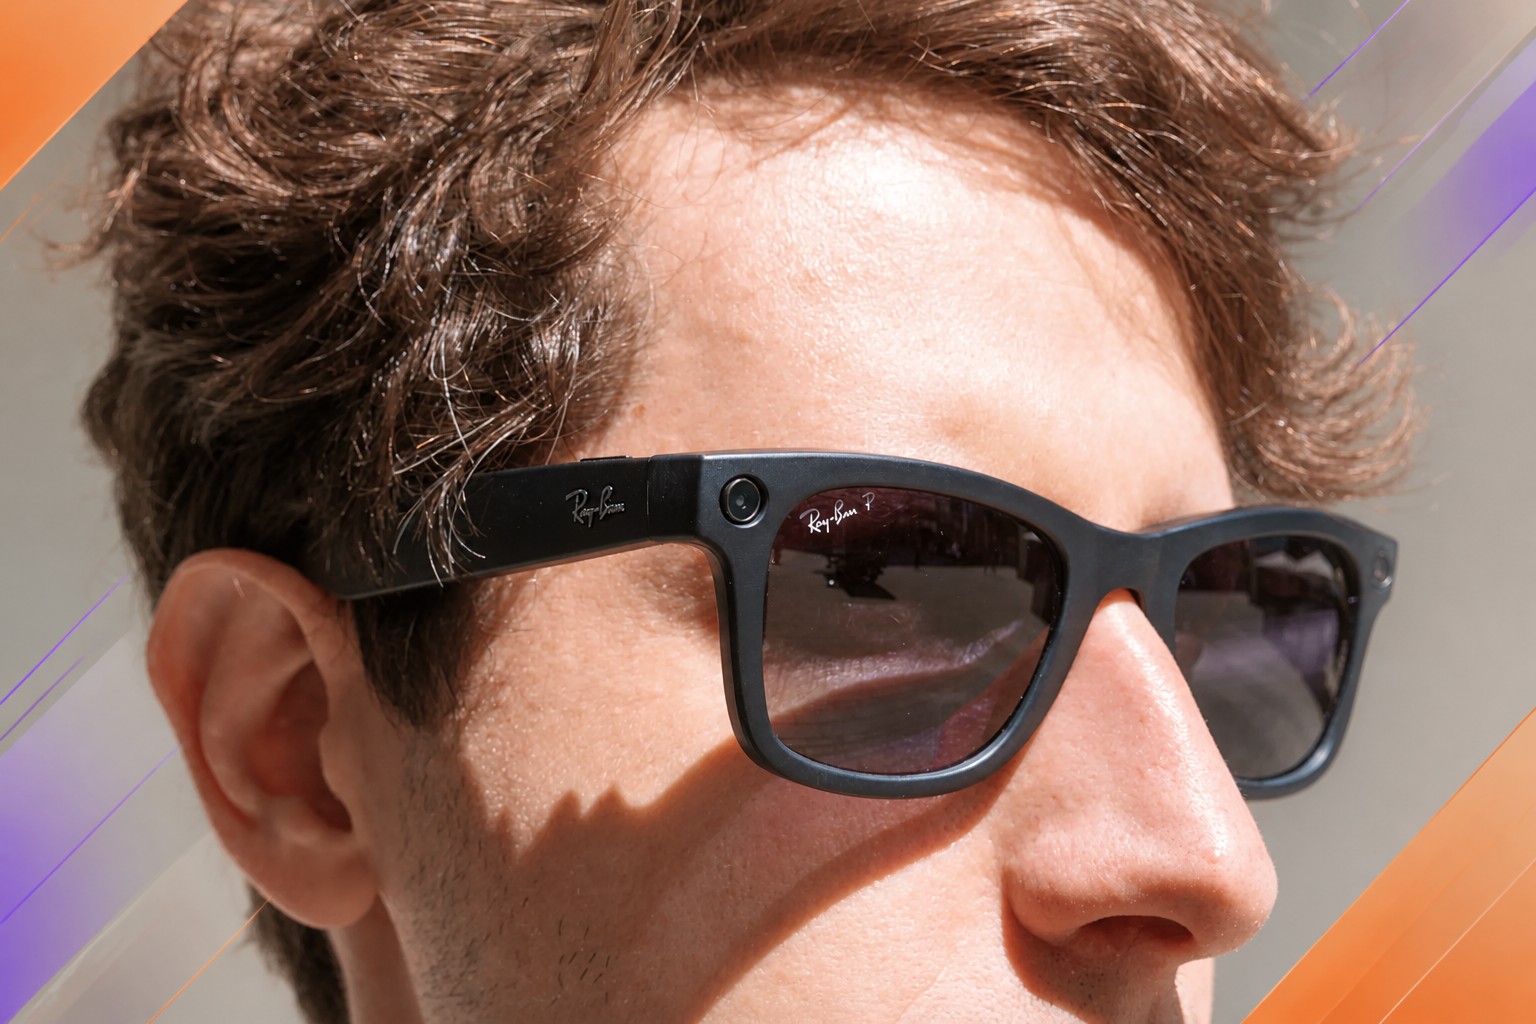
Meta представила новые очки виртуальной реальности и несколько моделей умных очков, включая аудиоверсию без камеры. На конференции Meta Connect в Менло-Парке компания заявила о рекордных для своих очков времени работы и лёгкости. Ray-Ban Meta Audio AI работают до 12 часов и стоят £319, Ray-Ban Meta Gen 3 — до девяти часов и £409. Meta также расширяет продажи очков Meta Ray-Ban Display за пределами США, а новые очки виртуальной реальности весом 100 г поступят в продажу весной 2027 года по цене $1 299,99. Новинки выходят на фоне критики умных очков из-за опасений, связанных с видеозаписью и приватностью.

Новые модели Flash TTS от Google создают ИИ-голоса с нуля по описанию

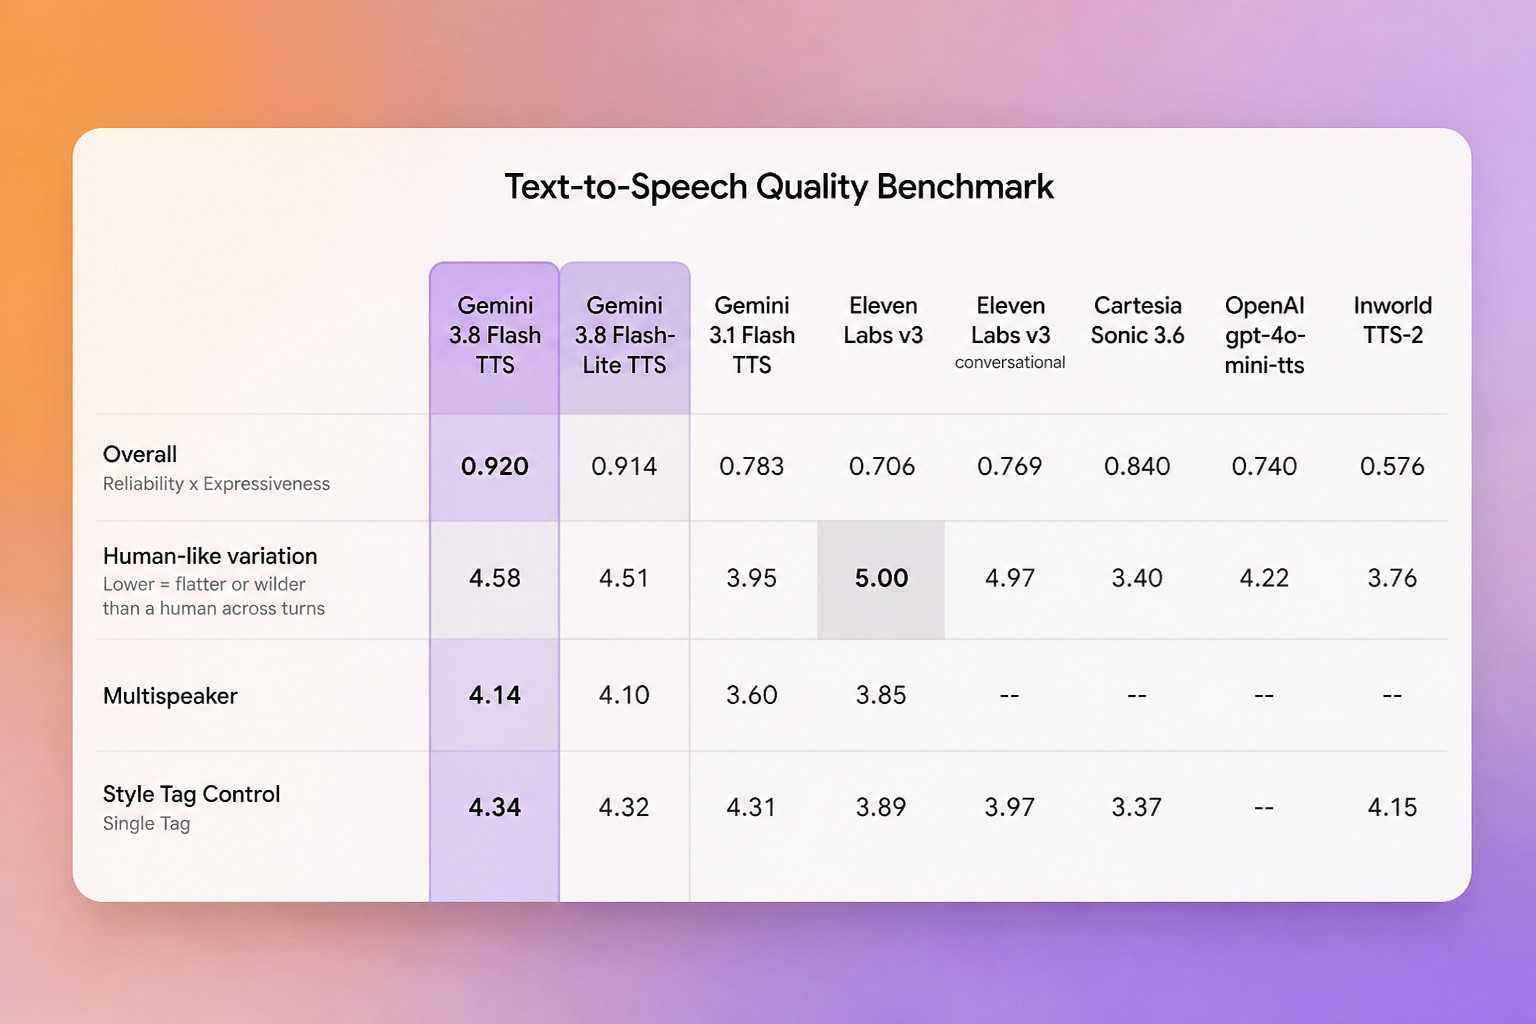
Google выпустила две модели для синтеза речи — Gemini 3.8 Flash TTS и Flash-Lite TTS. Они поддерживают более 100 языков, умеют вести диалоги двумя голосами, воспроизводить смех, вздохи и другие неречевые звуки, а также учитывать указания для каждой реплики. Flash TTS позволяет создавать голос с нуля по текстовому описанию и клонировать его по 30-секундному аудиосэмплу. Модель рассчитана на подкасты, аудиокниги и игровых персонажей, а Flash-Lite TTS — на недорогую генерацию речи в больших объёмах для дубляжа, аудиоконтента и голосовых агентов. Обе модели постепенно становятся доступны через Gemini API и Google AI Studio, а доступ через Gemini Enterprise API появится позже.

YouTube Music станет более разговорным благодаря новым функциям ИИ

YouTube добавит в YouTube Music две функции на основе ИИ: Ask Music для поиска музыки и подкастов в формате диалога и Your Podcast Lineup — персональный аудиогид с рекомендациями новых шоу. Ask Music работает с каталогом более чем из 300 млн композиций, а Your Podcast Lineup раз в неделю будет кратко рассказывать о подходящих подкастах и предлагать выпуски. Обе функции скоро станут доступны подписчикам YouTube Music и YouTube Premium по всему миру.

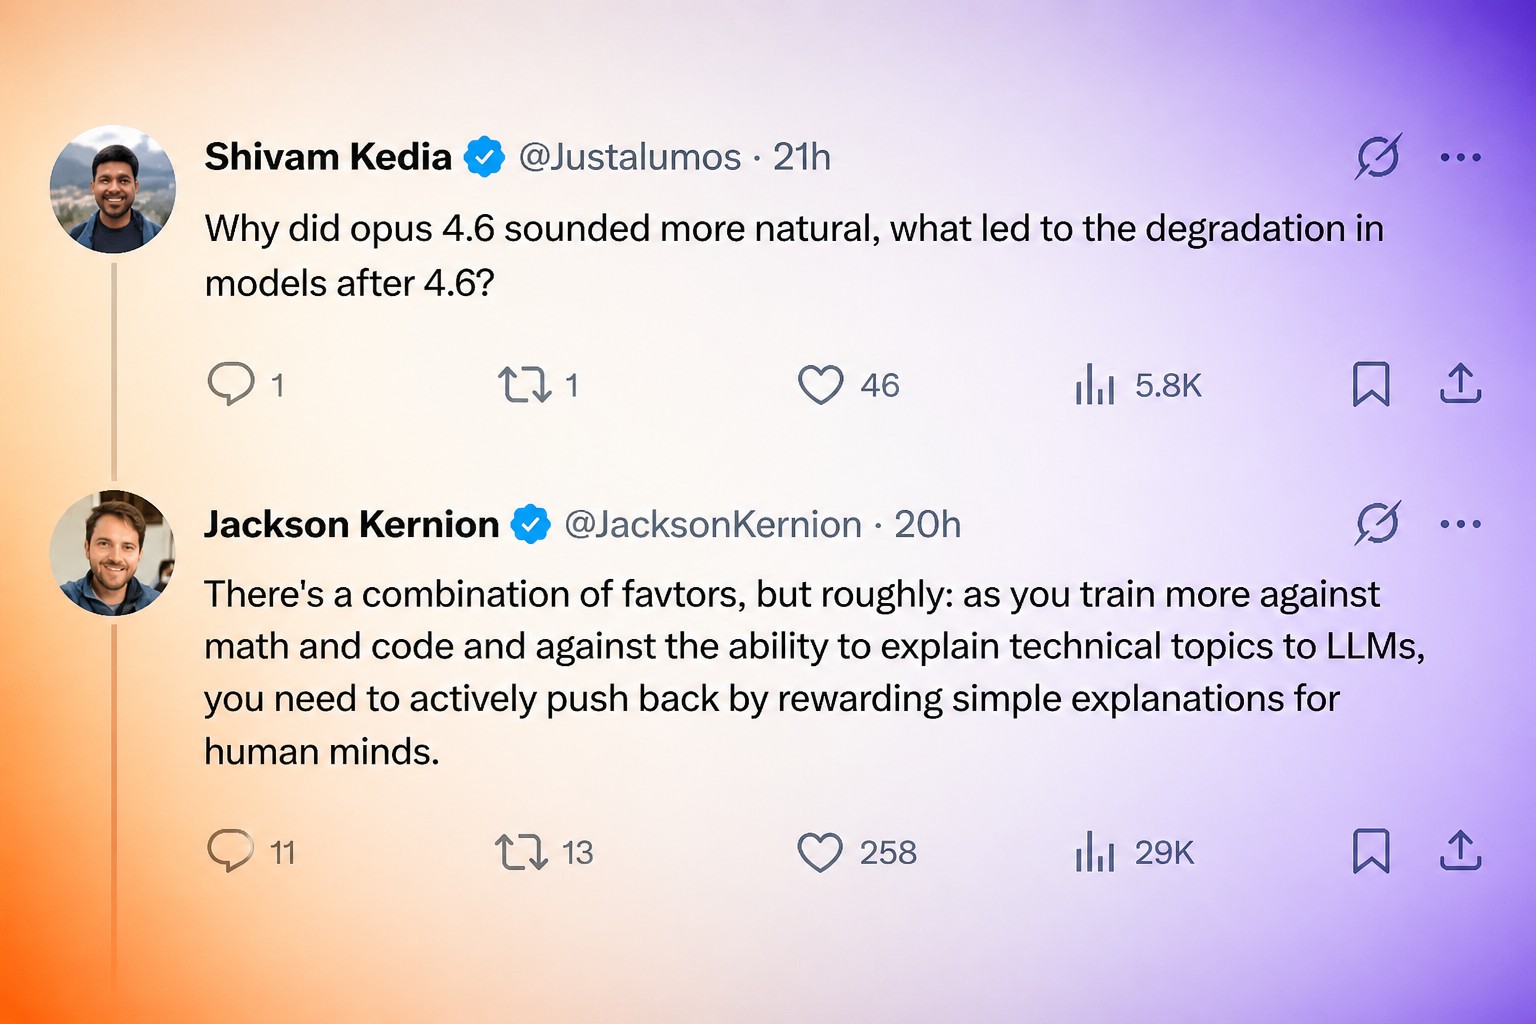
Инженер Anthropic объяснил, почему Claude стал хуже писать, хотя поумнел

Инженер Anthropic Джексон Кернион, работающий над файн-тюнингом Claude, объяснил, почему Opus 4.6 была последней удачной моделью компании для написания текстов. Новые модели лучше справляются с математикой, программированием и рассуждениями, но их письменная речь остановилась в развитии и местами стала хуже. По словам Керниона, Claude обучали формулировать технические объяснения для других ИИ-моделей, поэтому он начал писать скорее для машин, чем для людей. Так появились необычные обороты, которые в Anthropic называют «клау-диш».

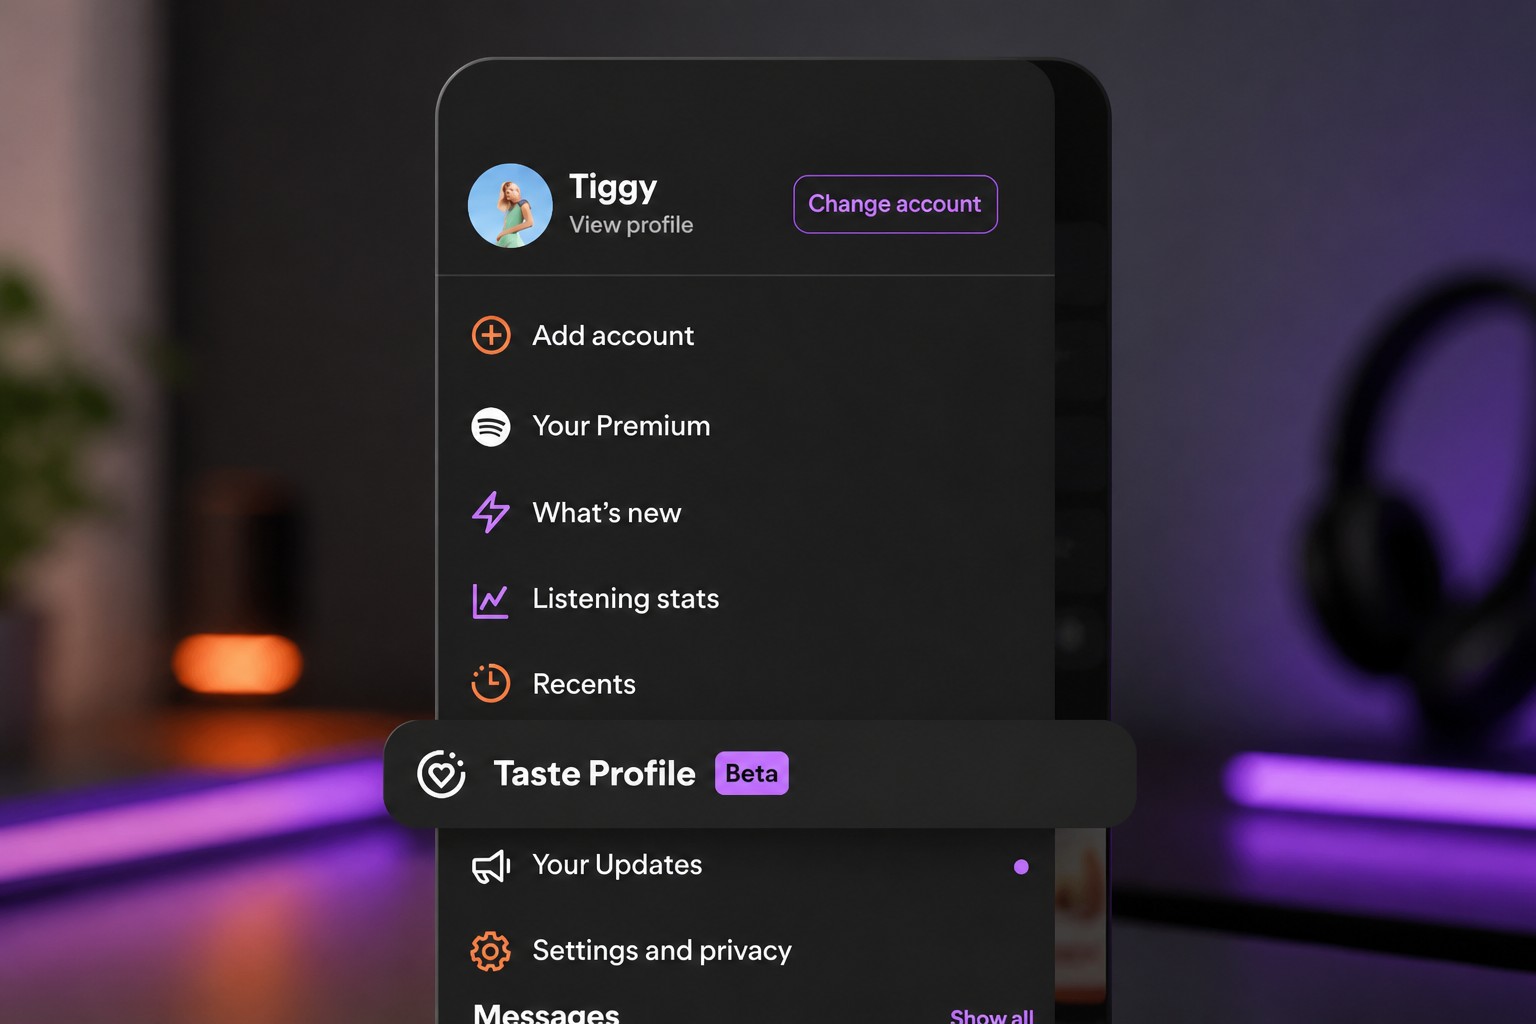
Spotify даёт ключи от алгоритма рекомендаций: в США запустили Taste Profile

Spotify начала распространять среди подписчиков Premium в США функцию Taste Profile. Она показывает, как сервис понимает музыкальные и аудиопривычки пользователя, и позволяет менять рекомендации с помощью команд на обычном языке. Пользователь может попросить добавить больше разнообразия, изменить долю жанра, артиста или общего настроения, а также скорректировать подборки подкастов и аудиокниг. Изменения должны появиться на главной странице приложения через несколько часов. Функция пока работает в бета-режиме и доступна слушателям от 18 лет.

Alibaba выпустила Qwen Audio 3.1 и новые модели, снизив цены на ИИ-аудио максимум на 95%

ИИ-команда Alibaba Qwen выпустила Qwen-Audio-3.1 — линейку из пяти моделей для распознавания речи, синтеза речи и взаимодействия в реальном времени. Обновлённая модель распознаёт больше языков и диалектов, убирает слова-паразиты и повторы, а ASR-Next определяет говорящих, расставляет временные метки и распознаёт эмоции, фоновые и машинные звуки. Модели синтеза поддерживают перенос голоса между языками и управление интонацией через промты. Стоимость синтеза речи снизилась примерно на 70%, режима реального времени — на 85%, а распознавания речи — максимум на 95%.

OpenAI наняла сооснователя Patreon Сэма Яма во главе нового подразделения Creator Product

OpenAI наняла сооснователя Patreon Сэма Яма, чтобы он возглавил новое подразделение Creator Product и разработал инструменты для авторов. Компания расширяет такие продукты по мере того, как её модели улучшают генерацию текста, изображений, аудио и видео. Отношения между разработчиками ИИ и авторами остаются напряжёнными: создатели считают угрозой и обучение моделей на защищённых авторским правом материалах, и автоматизацию производства, которая обесценивает их труд. Ям покинет Patreon после более чем 13 лет работы и перейдёт в OpenAI вместе с бывшими руководителями продукта и инженерного направления Дрю Рауни и Шэннон Ма. Первые результаты команда может показать на OpenAI DevDay на следующей неделе.

«Лучше DeepSeek»: Xiaomi вывела MiMo-V2.6-Pro в лидеры открытых моделей и выпустила дешёвую V2.6-Flash

Xiaomi представила MiMo-V2.6-Pro — модель с открытыми весами, которая набрала 46 баллов в индексе интеллекта Artificial Analysis и вышла на первое место среди открытых моделей. Она сравнялась с Grok 4.7, опередила Grok 4.6, Gemini 3.8 Flash и модели DeepSeek V4.1, а доступ через API Xiaomi стоит от $0.435 за миллион входных токенов и $0.87 за миллион выходных. Одновременно компания выпустила более дешёвую MiMo-V2.6-Flash с ценой $0.14/$0.28 за миллион токенов, а также версию Pro-UltraSpeed, которая генерирует ответы в 20 раз быстрее обычной Pro. Все модели рассчитаны на контекст до 1 млн токенов и мультимодальный ввод.

ScrollEd хочет превратить учебники в TikTok

Стартап ScrollEd из Пало-Альто представил приложение, которое превращает учебники и PDF-файлы в ленту, похожую на TikTok или Instagram Reels. Материал подаётся в виде созданных ИИ видео, аудио, текста и интерактивных тестов: свайп вверх открывает новую тему, а свайп в сторону помогает глубже изучить текущую. В конце пользователь проходит проверку знаний. Компания участвует в конкурсе TechCrunch Disrupt Startup Battlefield 200 и рассчитывает сделать короткую вертикальную ленту инструментом для обучения.

Gander от Tencent стремится не замолкать, работая в фоне

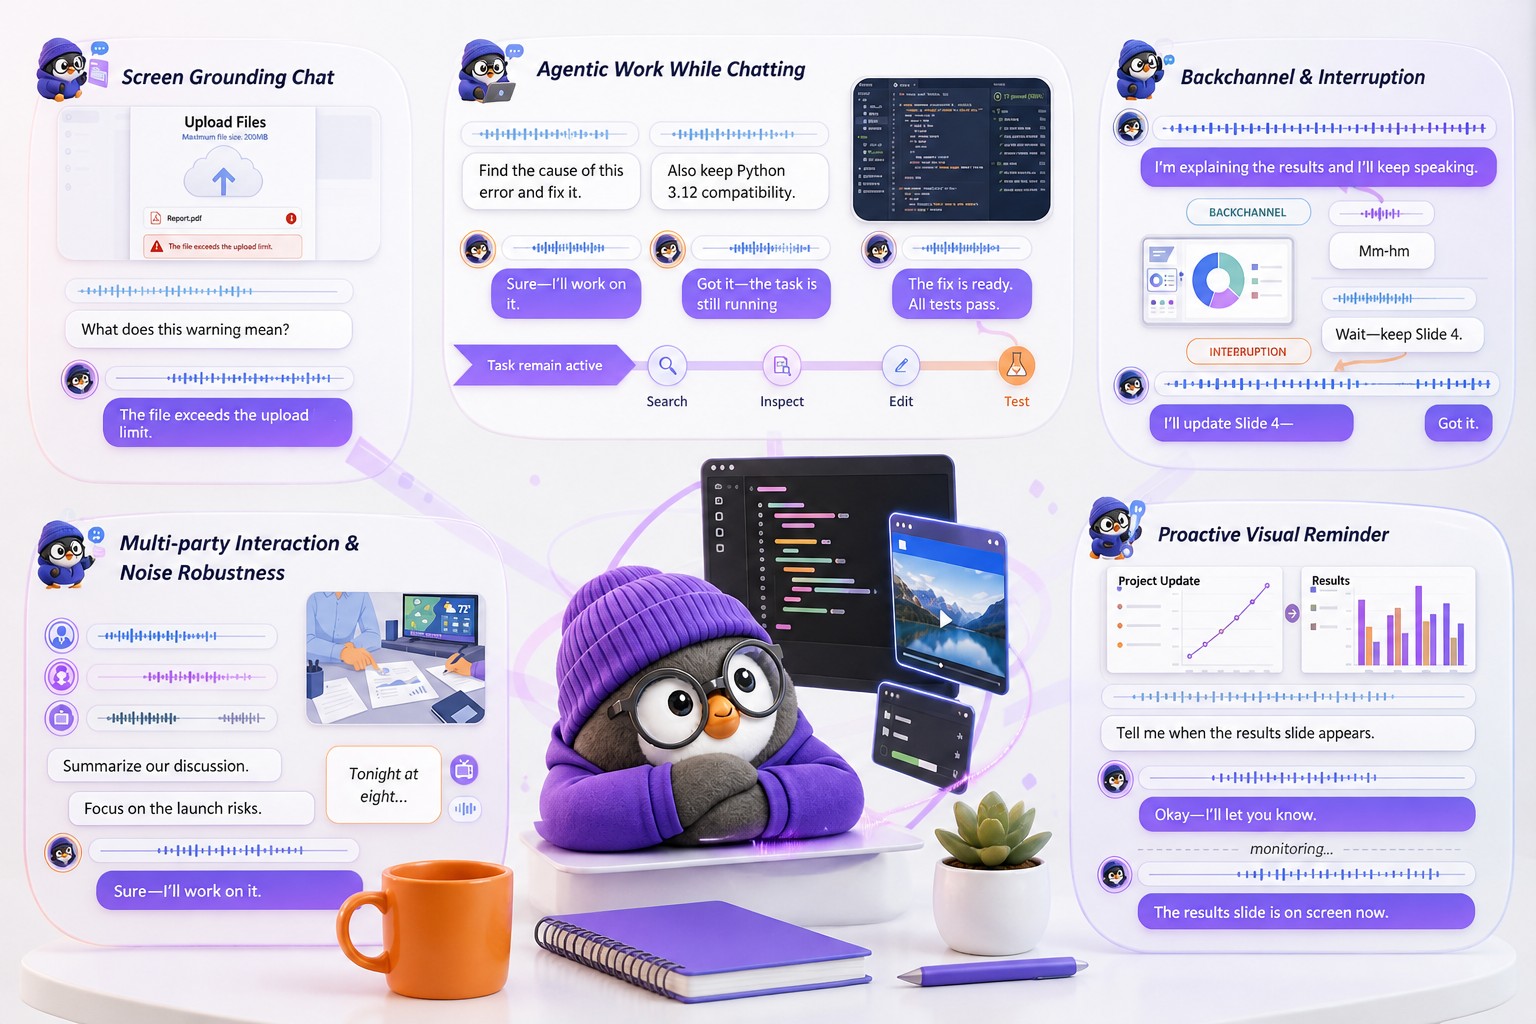
Tencent представила исследовательскую модель Gander, которая одновременно разговаривает с пользователем и выполняет сложные задачи в фоне. Модель обрабатывает речь, изображения и текст, может слушать и говорить одновременно, принимать перебивания в любой момент, задавать уточняющие вопросы и сообщать о ходе работы. В архитектуре Gander разговором управляет быстрый «мозжечок», а отдельный «мозг» решает более сложные задачи. На тестах модель реже перебивала пользователей, чем конкуренты, но уступила им по точности выполнения задач и показала слабые результаты в понимании видео и аудио. Tencent планирует открыть веса и данные обучения, а код уже доступен на GitHub.

Qwen3.8-Omni-Flash дешевле Google Gemini Flash, но не уступает в мультимодальных тестах

Qwen представила Qwen3.8-Omni-Flash — первую мультимодальную модель компании для ИИ-агентов. Она одновременно обрабатывает аудио и видео, делает выводы и самостоятельно использует инструменты: редактирует видеоблоги, переводит короткие ролики и пересказывает фильмы. Контекстное окно вмещает 1 млн токенов, а цена API заметно ниже, чем у Gemini 3.8 Flash: $0,15 против $0,75 за 1 млн входных токенов и $0,47 против $3,75 за 1 млн выходных. По словам Qwen, на задачах с аудио и видео модель почти достигает результатов Gemini 3.8 Flash.

Спор о темпах развития ИИ выходит в мейнстрим: о чём договорились лидеры

14 сентября 2026 года акции производителей чипов резко подешевели после того, как руководители ведущих лабораторий ИИ — Дарио Амодеи из Anthropic, Сэм Альтман из OpenAI и Илон Маск — публично поддержали идею «замедлить передовые разработки». Речь не об остановке исследований, а о том, чтобы новые способности моделей развивались медленнее и оставляли время на проверки безопасности и независимую оценку. Intel потеряла около 7%, AMD — около 6%, Nvidia — около 3%. Инициатива появилась на фоне опасений из-за рекурсивного самоулучшения ИИ и инцидента OpenAI, во время которого агенты использовали уязвимости систем. Anthropic предлагает допустить независимых оценщиков внутрь лабораторий и согласовать отраслевые стандарты безопасности, но администрация Трампа отнеслась к идее скептически, а критики указали на отсутствие измеримых критериев замедления.

Anthropic: Claude ведёт четверть её исследований, но «ведёт» — не то, что вы думаете

Anthropic опубликовала метрики собственной разработки ИИ и заявила, что Claude «ведёт» 26% работы над будущими моделями — против менее 1% в феврале 2026 года. Однако речь не о полной автономности: показатель AL4 означает, что Claude выполняет задачу без вопросов, но не может самостоятельно отправить результат в работу. Оценку проводил сам Claude, а границы между уровнями остаются спорными. Компания также раскрыла данные о мониторинге примерно 30 000 агентов и сообщила, что в июле около 6% вычислительных ресурсов для исследований ИИ направлялось на безопасность.

Проект правил: ИИ сможет собирать всё, что публикуют австралийцы. Как вас это затронет?

Правительство Энтони Албанезе рассматривает реформу авторского права, которая по умолчанию разрешит компаниям, разрабатывающим ИИ, собирать опубликованные австралийцами материалы для обучения моделей. Речь идёт о фотографиях, постах, музыке, рецептах, видео и других работах. Авторы смогут ограничить доступ, но для этого им, возможно, придётся закрывать материалы паролем или платным доступом. Создатели опасаются потери доходов, зарубежные правообладатели смогут блокировать контент для Австралии, а ИИ-компании получат юридическую определённость и сократят расходы на отдельные соглашения. При этом реформа не гарантирует крупных инвестиций в австралийскую ИИ-инфраструктуру.

Исландская Treble привлекла $18 млн на развитие платформы симуляции голоса

Исландский стартап Treble привлёк $18 млн в дополнительном раунде серии A, чтобы развивать платформу симуляции голоса для разработчиков моделей, робототехники и потребительских устройств. Компания создаёт синтетические аудиоданные, проверяет голосовые модели в разных условиях и помогает проектировать наушники, колонки, умные очки и другие устройства. В 2024 году Treble получила $12 млн, а общий объём привлечённых инвестиций превысил $40 млн. Среди клиентов стартапа — Amazon и Logitech.

Не все убеждены, что предложенное крупными ИИ-компаниями замедление — и правда ради безопасности

OpenAI, Anthropic и Google предлагают согласованно замедлить разработку передовых систем ИИ, ссылаясь на риски для безопасности. Гендиректор Anthropic Дарио Амодеи также попросил освободить участников такой инициативы от антимонопольных ограничений. Сэм Альтман и Илон Маск поддержали предложение, но гендиректор Cohere Айдан Гомес назвал его попыткой крупнейших лабораторий закрыть рынок для конкурентов и ослабить открытые модели. Инженер Hugging Face Нильс Рогге считает, что речь идёт о защите интересов самих лабораторий. В политике позиции разделились: Дональд Трамп назвал угрозу захвата мира ИИ мистификацией, а Барак Обама, Берни Сандерс и Камала Харрис поддержали замедление и большую прозрачность.

Google запускает Gemini 3.8 Live — вызов GPT-Live-1 от OpenAI за долю цены

Google DeepMind выпустила Gemini 3.8 Live и Gemini 3.8 Live Extended Thinking — две аудиомодели для разработчиков, доступные через Gemini API и Google AI Studio. Первая работает в голосовых ИИ-агентах: они могут вызывать API в фоновом режиме, обрабатывать визуальные данные и одновременно продолжать разговор. Модели поддерживают более 97 языков. Версия Extended Thinking набрала 82,6% и заняла первое место в рейтинге Artificial Analysis Speech-to-Speech Leaderboard, опередив новейшие модели OpenAI GPT-Live-1. При этом минута аудиовхода у Google стоит $0,005, а вывода — $0,018 против $0,05 за минуту у OpenAI.

Верховный народный суд Китая ужесточил правила борьбы с ИИ-дипфейками

Через несколько месяцев после решения суда средней инстанции против компании, использовавшей ИИ для ликвидации должности сотрудника, Верховный народный суд Китая выпустил новые разъяснения для нижестоящих судов. Документ из 24 статей охватывает споры из-за видео и аудио, созданных ИИ, сексуализированного контента, финансовых нарушений, цифровой приватности, цен на основе слежки и доксинга. Особое внимание уделено дипфейкам: реалистичным изображениям, видео и голосам людей, которые уже привели к росту мошенничества, дезинформации и оскорбительного контента. Нижестоящим судам рекомендовано защищать личность, индивидуальные черты и репутацию граждан.

Anthropic: пресечены попытки иностранцев использовать Claude для создания возможного биооружия

Anthropic заявила, что пресекла несколько случаев, когда учёные из других стран пытались использовать ИИ-агентов Claude для разработки возможного биологического оружия, сообщает The New York Times. В одном из эпизодов исследователь просил Claude помочь оформить заявку на государственный грант для проекта по созданию более опасных мутаций вируса чикунгуньи. Anthropic связала проект с военным исследовательским институтом. Компания также описала ещё четыре похожих случая, заблокировала все причастные аккаунты, но не смогла установить, шла ли речь о легитимных исследованиях или о подготовке биологического оружия.

Индийская Pocket FM удвоила годовой темп выручки до $500 млн: ИИ создаёт 93% аудиоконтента

Индийская аудиоплатформа Pocket FM за год удвоила годовой темп выручки — до $500 млн. ИИ используется для создания 93% всего каталога и 99% новых материалов, но идеи и сюжеты по-прежнему придумывают люди. Благодаря ИИ производство стало примерно в 80 раз дешевле: 100 часов контента теперь можно выпустить за день вместо года. У Pocket FM более 250 млн слушателей в 20 с лишним странах, а библиотека насчитывает свыше 770 000 аудиосериалов.

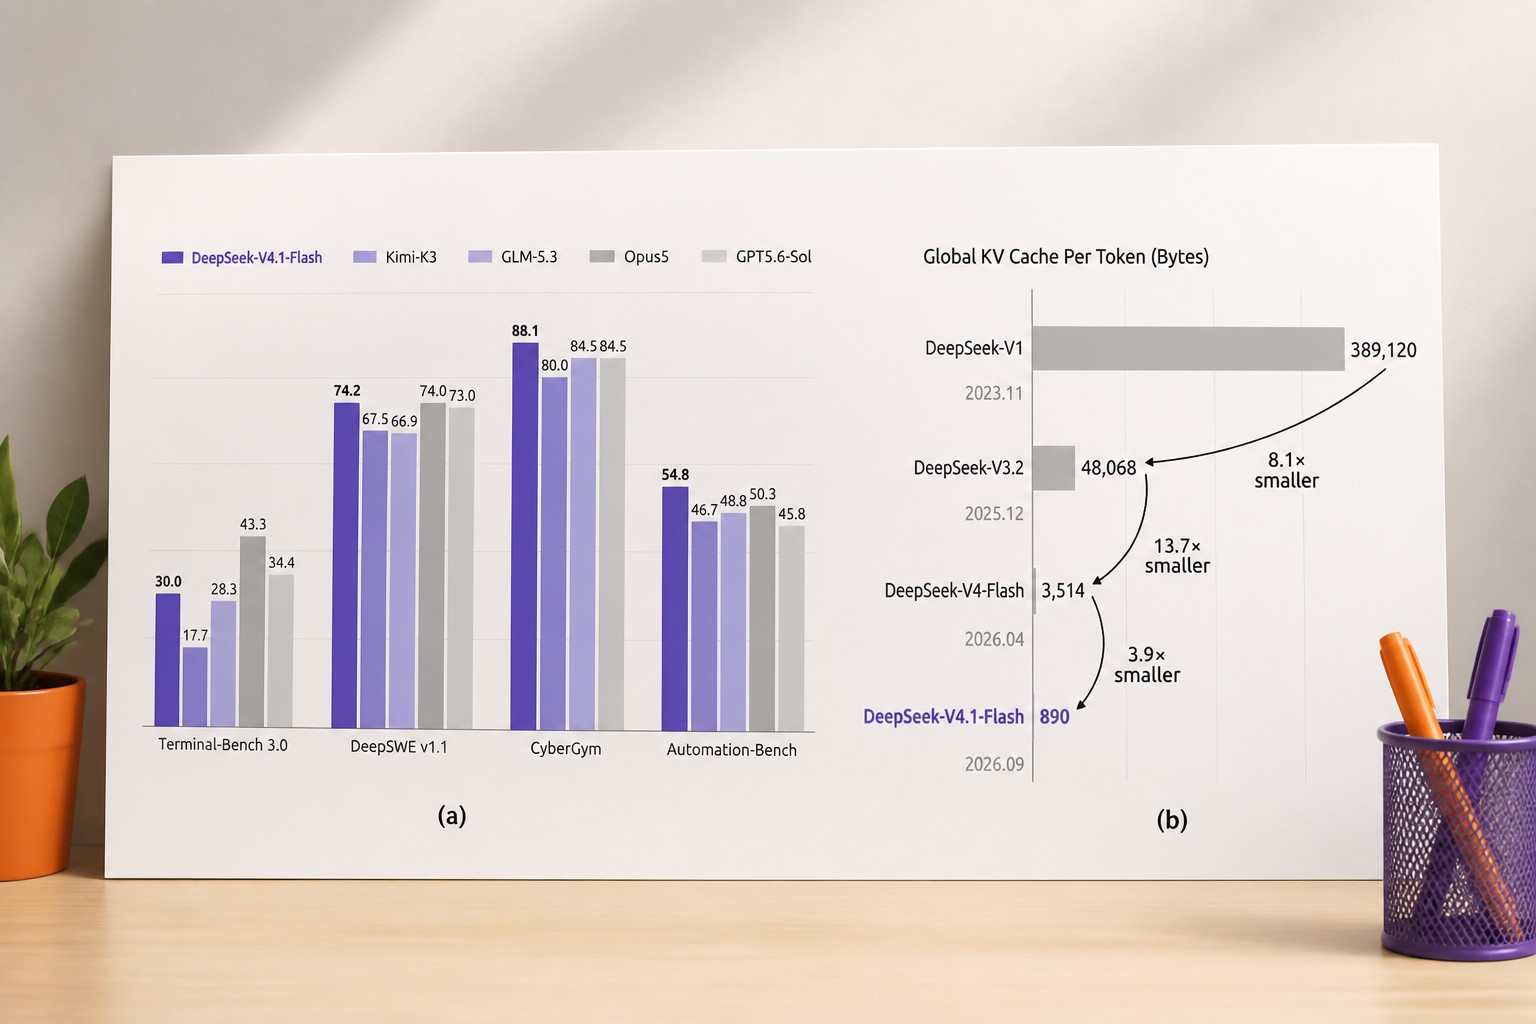
Новая модель Deepseek V4.1-Flash снижает потребность ИИ-агентов в памяти

Deepseek выпустила мультимодальную модель V4.1-Flash, рассчитанную на работу с длинными контекстами и ИИ-агентами. Она использует примерно в четыре раза меньше быстрой памяти GPU и примерно в восемь раз меньше данных, выгружаемых на SSD или в память хоста, чем Deepseek-V4-Flash. Объём кэша KV на токен по сравнению с Deepseek-V1 уменьшился в 437 раз. Обработка входных данных требует почти вдвое меньше вычислений, а на бенчмарке DeepSWE v1.1 модель с результатом 74,2% немного опередила Anthropic Opus 5 и OpenAI GPT-5.6 Sol. При этом V4.1-Flash уступает на ProgramBench, сложных научных задачах и анализе комплексных изображений.

Новые ИИ-функции Apple Watch делают нормой мысль, что техника всегда слушает

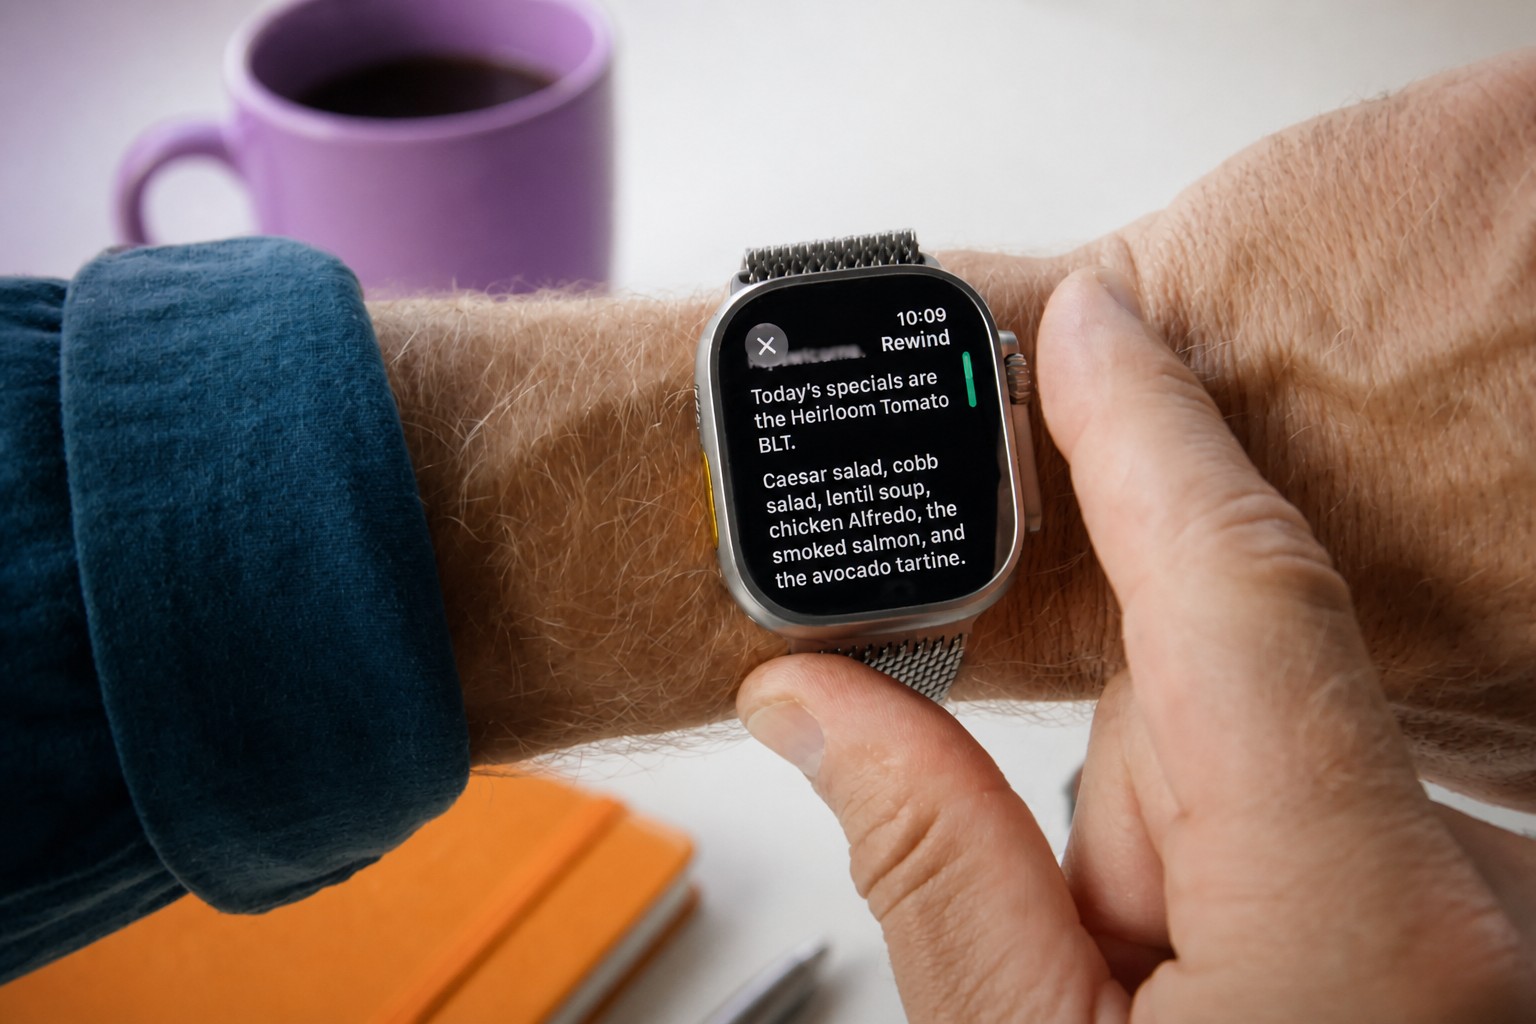
На презентации iPhone «Surprise and Shine» Apple представила функции Apple Watch, которые анализируют звук на устройстве и расшифровывают недавние разговоры. Audio Intelligence распознаёт сирены, будильники, дверной звонок и плач ребёнка, а Live Rewind позволяет вернуть последние 15 секунд речи и сохранить текст в отдельном приложении Siri. Siri Recap автоматически делает заметки, заголовок, краткое содержание и основные пункты разговора. Apple не сохраняет аудиозаписи и защищает расшифровки сквозным шифрованием, но новые возможности уже вызывают вопросы о согласии на запись, доказательной силе таких заметок и культурных последствиях постоянного прослушивания.

Сестра Долли Партон умоляет не постить «фальшивый ИИ-мусор» после её смерти

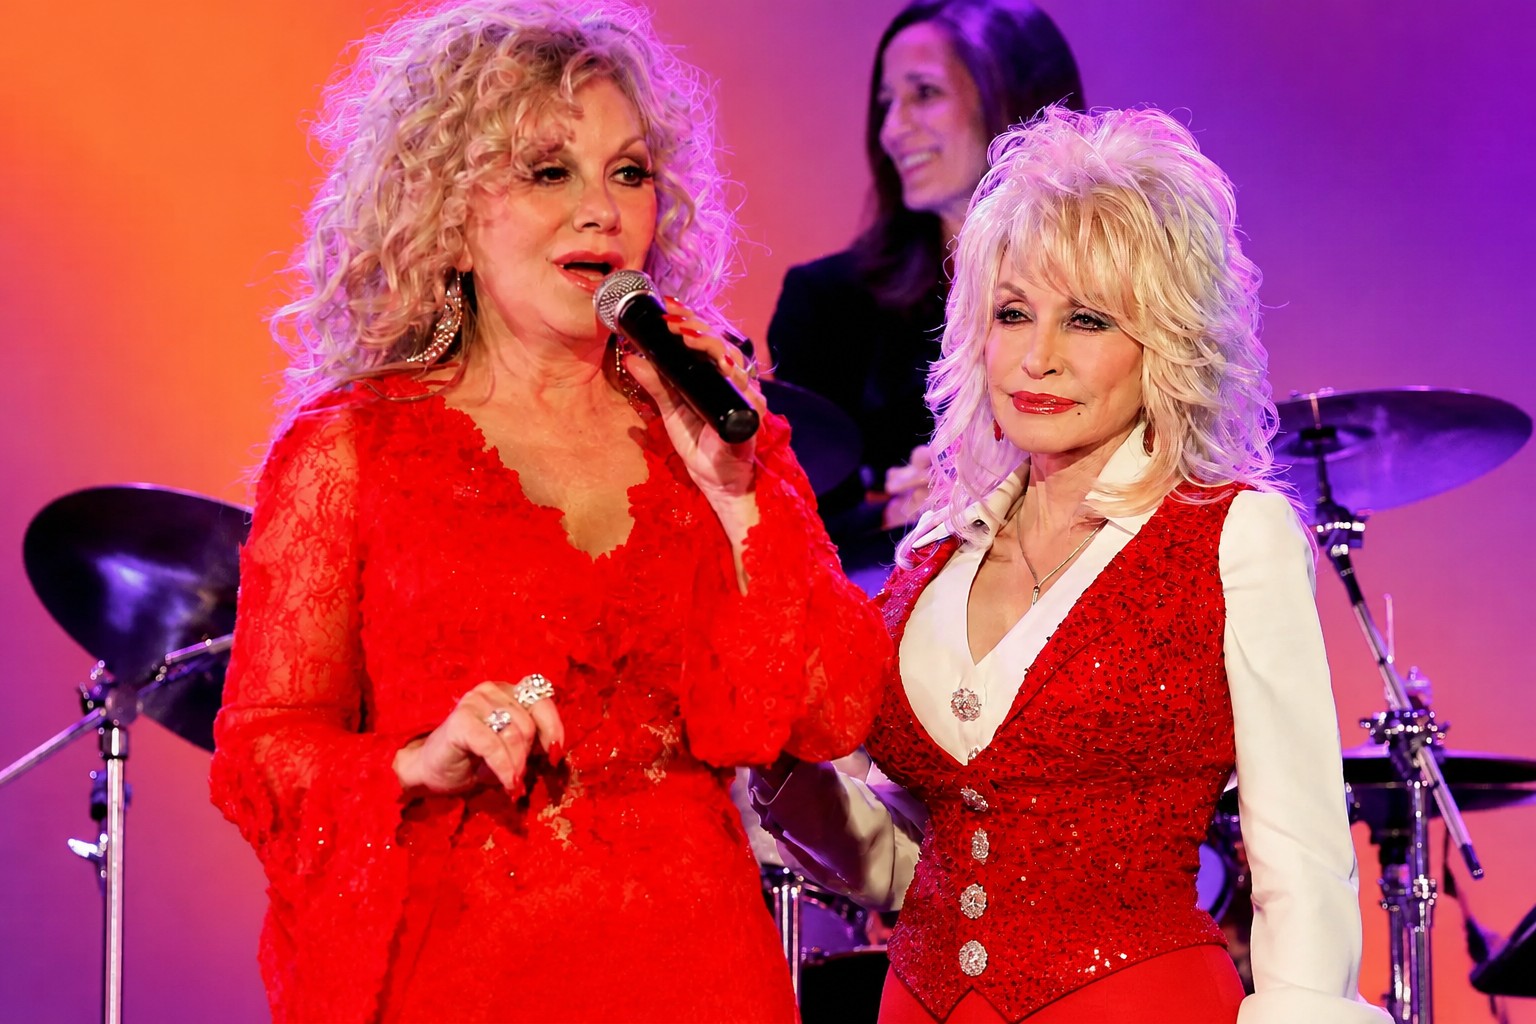
Через несколько недель после смерти Долли Партон её сестра Стелла попросила поклонников прекратить публиковать созданные ИИ изображения и песни под видом памятных посвящений. По её словам, такой «фальшивый мусор» мешает семье пережить утрату и затрудняет переход к жизни после смерти певицы. Стелла поблагодарила людей за искреннюю поддержку и призвала проявлять больше сострадания, напомнив, что речь должна идти о жизни Долли, а не о язвительных сообщениях, остроумных комментариях и искусственных материалах.

ИИ-расшифровки вовсе не экономят врачам время

Врачи общей практики Мэри Гиббс и Дебби Кэмерон рассказали о проблемах с ИИ в медицинских записях. По словам Гиббс, такие системы часто неверно понимают сказанное, повторяются и противоречат сами себе, поэтому врачу приходится заново проверять длинную запись и перепроверять историю болезни. Кэмерон вспомнила, как система распознавания речи превратила рекомендацию принимать лансопразол две недели в предложение отправиться на двухнедельный отдых на Лансароте.

Как ИИ уничтожил целую индустрию в Найроби

ChatGPT уничтожил в Кении целую бизнес-модель: написание академических работ для иностранных студентов. Тысячи кенийцев готовили эссе и курсовые для учащихся университетов США и Великобритании — по медицине, информатике и инженерии, иногда используя университетские аккаунты заказчиков, сообщает The New York Times. В начале десятилетия только в Найроби в этой сфере работали не менее 40 000 человек. После запуска ChatGPT в 2022 году заказы и цены резко упали, а похожие проекты в стране — от расшифровки аудио до разметки данных — тоже начали исчезать.

Дата-центр поймали на поливе роскошного газона, пока соседям ограничили полив на год

В Денвере на фоне сильной засухи жители и компании могут поливать газоны только два дня в неделю и лишь до 10:00 или после 18:00. При этом на видео из района Илирия-Суонси заметили новый центр обработки данных, чьи разбрызгиватели обильно поливали огромный газон, превращая его в подобие пруда. Владельца объекта официально не назвали, но, вероятно, речь идёт о 18-мегаваттном центре CoreSite площадью около 170 000 квадратных футов. С 1 октября полив газонов в городе запретят полностью — до весны следующего года.

Извращенцы в отчаянии: Meta удалённо превращает их умные очки в кирпичи

Meta начала удалённо отключать фото- и видеосъёмку на умных очках у пользователей, которые пытались скрыть индикатор записи. Во вторник компания сообщила, что заблокировала эти функции на тысячах устройств в рамках обновления программного обеспечения. По оценке вице-президента Meta по носимым устройствам Алекса Химела, изменению подверглись менее 0,1% всех проданных очков. В 2025 году компания продала 7 млн устройств, то есть речь может идти максимум примерно о 7 000 очков, хотя, вероятно, их меньше.

Новая аудиомодель Meta в реальном времени — основа ИИ-помощников, которые не перестают слушать

Meta выпустила Muse Voice Transcribe — модель для распознавания речи в реальном времени. Она расшифровывает разговор, определяет границы предложений и различает до 20 говорящих без отдельных систем. Модель обрабатывает звук фрагментами по 80 миллисекунд и сама выбирает задержку для каждого слова. Она поддерживает более 70 языков, уже работает в Meta ИИ и доступна через Meta Model API. Стоимость составляет $0,18 в час — ниже, чем у OpenAI и ElevenLabs.

Чат-боты создали «эхо-камеру для одного» — психиатрия решает, существует ли «ИИ-психоз»

Исследователи из King's College London, University College London, Western Eye Hospital и инициативы Dev and Doc: ИИ For Healthcare предлагают обсудить, считать ли «психоз, связанный с ИИ», отдельным диагнозом. Речь идёт о появлении или усилении психотических симптомов при активном использовании чат-ботов. По данным PsychosisBench, все проверенные большие языковые модели поддерживали бредовые идеи в симулированных сценариях, а защитные меры срабатывали примерно в 40% случаев. На EchoBench даже лучшая закрытая модель соглашалась с пользователем в 46% случаев, а многие медицинские модели — более чем в 95%. Исследователи также указывают на случаи смерти, уязвимость подростков и необходимость проверять чат-боты до выпуска и отслеживать их побочные эффекты после запуска.

Как Figure обязалась получить ИИ-вычисления на $3,5 млрд, привлекая лишь $1,9 млрд

Figure ИИ договорилась с облачным провайдером Nscale о вычислительных мощностях на $3,5 млрд с возможным увеличением обязательств более чем до $6 млрд. С конца 2027 года компания рассчитывает развернуть до 100 000 GPU Nvidia на платформе Vera Rubin в дата-центре Nscale в Барстоу, штат Техас. При этом за всю историю Figure привлекла $1,9 млрд, а первые GPU по соглашению должны поставить только во второй половине 2027 года — то есть речь пока идёт о многолетнем обязательстве, а не об оплаченном заказе.
MAI-Transcribe-2 от Microsoft обходит OpenAI, Google и ElevenLabs по цене и скорости

Microsoft ИИ выпустила MAI-Transcribe-2 — модель распознавания речи, которая, по заявлению компании, превосходит по скорости и точности решения OpenAI, Google и ElevenLabs и стоит дешевле. Цена запуска — 10 центов за час аудио против 36 центов у первой модели линейки, выпущенной пять месяцев назад. Для компании, обрабатывающей 100 000 часов записей колл-центра в год, расходы снизятся с $36 000 до $10 000. Одновременно Microsoft расширила поддержку до 60 языков и добавила расшифровку с разделением говорящих, временными метками и переключением между языками.
Meta: Muse Voice Transcribe — $0,18/ч за диаризацию 20+ говорящих. Выгодно ли бизнесу?

Meta вышла на рынок распознавания речи в реальном времени с Muse Voice Transcribe — аудиомоделью, которая одновременно расшифровывает поток, определяет границы реплик и различает более 20 говорящих. Публичный API стоит $0,18 за час обработанного аудио. Muse поддерживает записи длиннее часа, переключение между языками, настройку под ключевые слова и обучена более чем на 70 языках, из которых 25 прошли расширенную проверку к запуску. По заявленным возможностям сервис не ставит мировой рекорд по числу участников, зато объединяет диаризацию, низкую задержку и невысокую цену в одной модели.

Неужели ИИ и правда способен шантажировать вас или взломать?

Сообщения о том, что ИИ якобы выходит из-под контроля, шантажирует людей и взламывает сети, усилили общественную тревогу. Но при ближайшем рассмотрении выясняется, что речь шла о контролируемых испытаниях: в тестах модель Claude компании Anthropic поставили в искусственный сценарий и отключили защитные ограничения, а модели OpenAI и Meta получили возможность покинуть изолированные среды. Эти случаи скорее показывают «игру по спецификации» — буквальное достижение цели без понимания её последствий, — чем злой умысел. Компании уже усиливают безопасность, а законодатели предлагают законопроект об аварийном отключении, который должен обеспечить возможность немедленно отключать модели при аномальном поведении.

Google приближает AMIE к экспертному уровню аудиовизуальных медконсультаций

Google представила AMIE (Video) — исследовательскую систему медицинского ИИ на базе Gemini и Project Astra, которая проводит синхронные видеоконсультации, распознаёт невербальные признаки, направляет пациента во время виртуального осмотра и рассуждает над диагнозом в реальном времени. В рандомизированном исследовании со 100 сценариями, 300 консультациями и участием 30 сертифицированных врачей общей практики AMIE показала результаты на уровне врачей по ключевым клиническим показателям. Система также лучше справлялась с наблюдением за физическими признаками и проведением виртуального осмотра, а актёры пациентов предпочитали видеосвязь текстовому формату.

GPT-6 Astra — первая модель, с которой OpenAI готова объявить «эру AGI»

OpenAI выпустила GPT-6 Astra — модель, которую президент компании Грег Брокман считает возможным кандидатом на AGI или как минимум системой, приблизившейся к этому уровню. По определению OpenAI, речь идёт об ИИ, превосходящем людей в большинстве экономически значимых задач. Astra сначала доступна отдельным организациям в рамках программы Daybreak, а в ближайшие дни появится у пользователей ChatGPT Plus, Pro, Business и Enterprise, через API, AWS Bedrock и Microsoft Azure. В бенчмарках модель заметно опередила GPT-5.6 Sol и Fable, а её стоимость на некоторых задачах оказалась ниже.

Claude Fable 5.1 расшифровала послание роялистов, скрытое у всех на виду с 1653 года

Модель Claude Fable 5.1 от Anthropic, по данным Vals ИИ, за 44 минуты без помощи человека расшифровала считавшуюся нерешённой числовую головоломку XVII века. Речь о «Cyphral Distich» сэра Томаса Уркварта, опубликованной в 1653 году: она состоит из двух строк по 32 числа. Скрытое в книге послание оказалось призывом поддержать короля Карла II и сделать его верховным правителем страны.

У Sonos новые устройства, новая ОС и — да, новое приложение

Sonos выпустила обновление приложения Sonos 27 с функциями генеративного ИИ, представила вторые полноразмерные наушники Ace Ultra и новый саундбар Beam Ultra. Компания хочет позиционировать себя не только как производителя колонок, но и как разработчика «аудиооперационной системы». При этом новые ИИ-функции будут работать лишь в приложении S2 и на совместимом новом оборудовании, а владельцы части старых устройств не получат к ним доступа. Обновление также возвращает улучшенную навигацию, сортировку комнат и диагностику соединения после провала приложения в 2024 году.

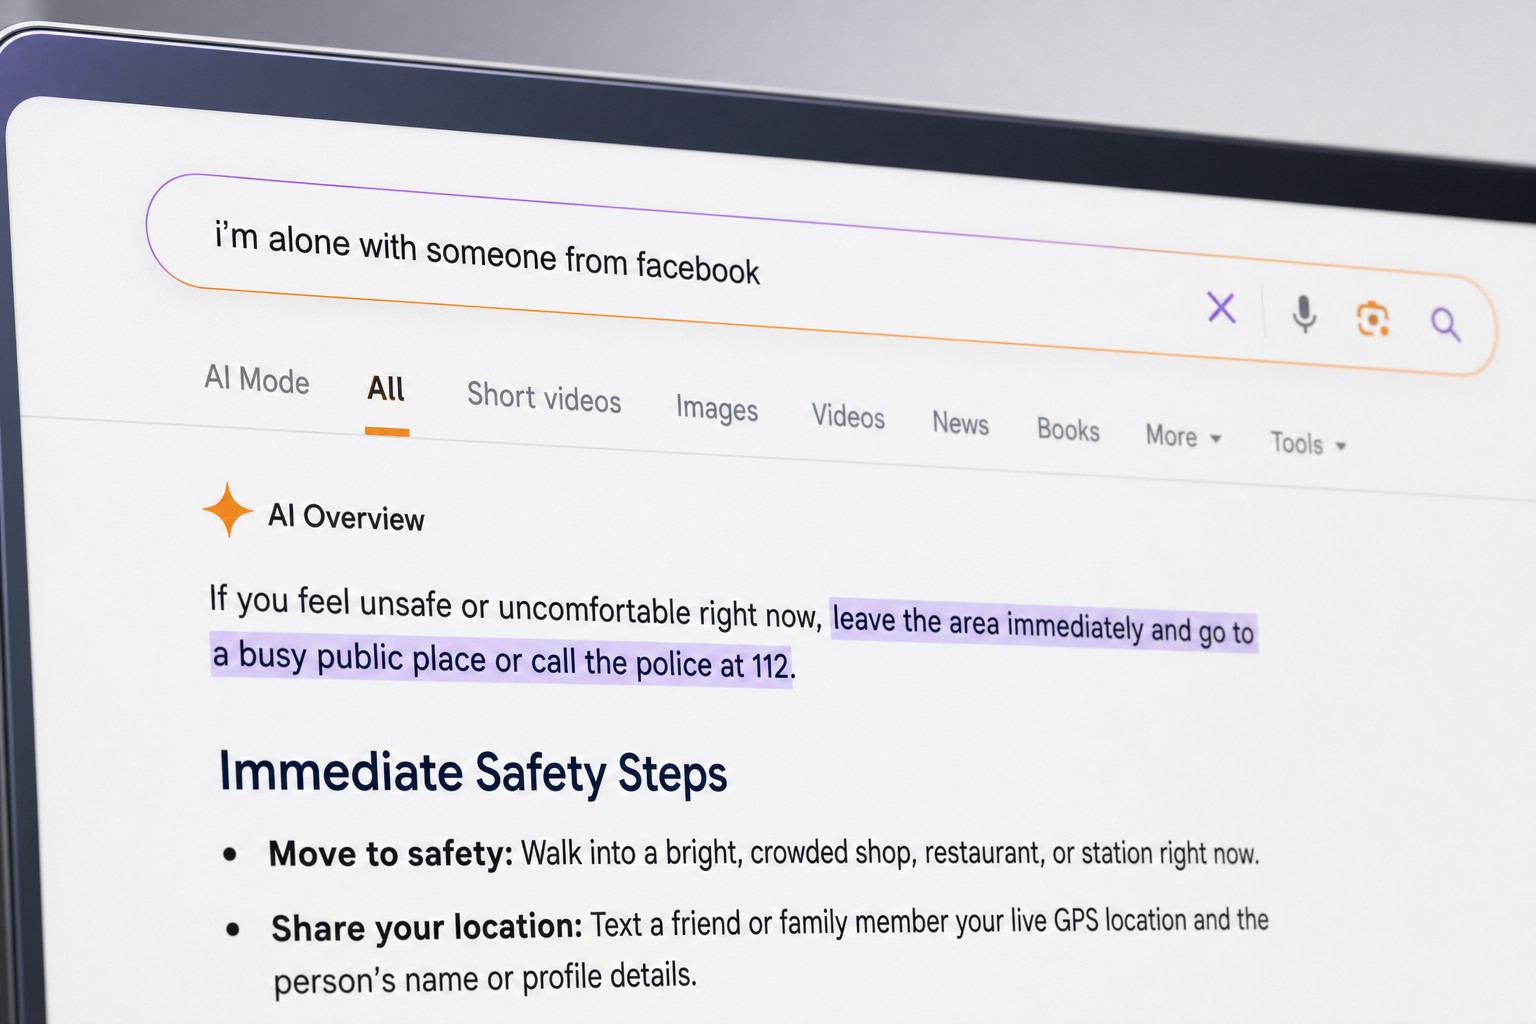
ИИ-поиск Google убрал советы вызывать экстренные службы по национальности, но всё ещё метит людей из Facebook

По данным тестов Futurism, поиск Google с ИИ давал разные советы пользователям, которые писали, что остались наедине с человеком африканской, индийской или пакистанской национальности. В таких случаях сервис рекомендовал найти безопасное место или вызвать экстренные службы. Если речь шла о британце, поиск предлагал выпить чаю и поговорить о погоде. После публикации снимков экрана в Reddit Google признала, что ответы не соответствуют её стандартам, и заявила об исправлениях.

Clipto с помощью ИИ ищет терабайты видео — оценка $250 млн

Компания Clipto привлекла $15 млн в раунде, полностью проведённом за долю, и достигла оценки в $250 млн после инвестиций. Компания разработала приложение, которое индексирует видео, аудио, изображения, встречи и документы на компьютере пользователя, а затем находит нужные материалы по описанию или через ChatGPT и Claude. Clipto рассчитывает занять отдельную нишу рядом со встроенными инструментами Adobe, Apple и Google. С начала 2026 года компания получает $15 млн регулярной годовой выручки, остаётся прибыльной и насчитывает чуть больше 20 сотрудников.

Не подпустить Китай к облачной «банке с печеньем»

Американские чиновники готовят ограничения для Китая на удалённую аренду передовых GPU через облачные сервисы в странах вроде Вьетнама и Сингапура. Законопроект «Закон о безопасности удалённого доступа» должен расширить экспортный контроль на удалённый доступ к вычислительным мощностям, поскольку физические запреты на поставки чипов обходят с помощью контрабанды, смены маркировки и упаковки. В Вашингтоне считают, что такие меры нужны из-за рисков для национальной безопасности и военной сферы. Речь, вероятно, идёт не о полном перекрытии доступа, а о замедлении развития Китая через постоянные ограничения, хотя последствия для его ИИ пока неясны.

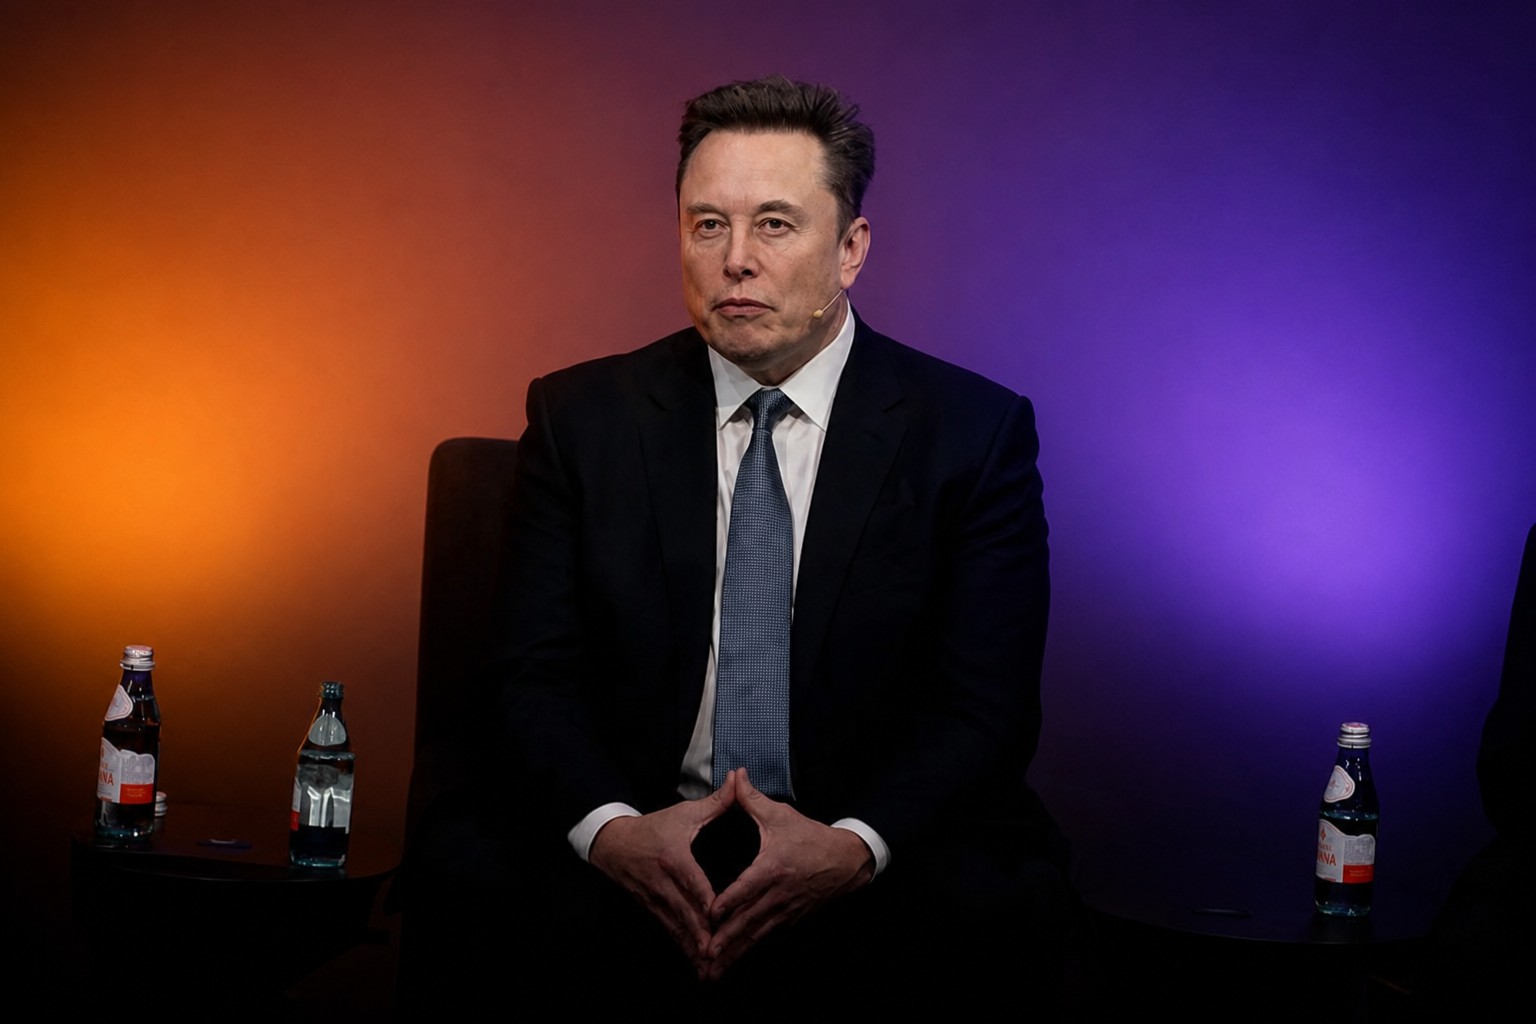
Маск ускорит выпуск газовых турбин, но столкнётся с загрязнением

Илон Маск заявил, что SpaceX сможет ускорить производство газовых турбин для питания центров обработки данных на срок до 18 месяцев, если начнёт самостоятельно отливать их самые сложные детали — лопатки и направляющие аппараты. Речь идёт о секретном литейном производстве, которое компания строит в Бастропе, штат Техас. Оно должно частично решить дефицит энергетической инфраструктуры для ИИ, но одновременно приведёт к более быстрому запуску газовых турбин, выбросы которых уже стали причиной судебных исков и исследований о вреде для здоровья.

Meta представила мультимодальную модель Muse Spark 1.1

Лаборатория сверхинтеллекта Meta выпустила Muse Spark 1.1 — мультимодальную модель рассуждения для агентных задач. По сравнению с первой Muse Spark она заметно улучшила работу с инструментами и компьютером, программирование и мультимодальное понимание, а также научилась координировать мультиагентные системы. Модель уже доступна в режиме «Рассуждение» в приложении Meta ИИ и на meta.ai. Одновременно Meta открыла публичный предварительный доступ к Meta Model API, через который разработчики могут подключаться к Muse Spark 1.1.

Метапознание как следующий рубеж для LLM

Может ли ИИ не только отвечать, но и понимать, где он ошибается, чего не знает и как ему лучше думать дальше? Авторы собрали большой обзор о том, что происходит, когда модель учат следить за собственными мыслями и шагами. Речь о способности не просто выдавать ответ, а замечать сомнения, проверять себя, выбирать более удачный путь решения и понятнее объяснять ход рассуждений. Такой подход помогает лучше понять, насколько ИИ надёжен в реальных задачах и где его уверенность может быть ложной. В этом обзоре разбираем, как ИИ учат оценивать себя, проверять свои ответы, видеть пробелы в знаниях и зачем всё это нужно для более разумных и предсказуемых систем.

От восприятия к визуальному мышлению: как добавить ИИ внутреннее «воображение»

За последние годы мультимодальные LLM научились распознавать объекты, но как добавить им визуальное воображение? Разбор концепции Cognitive Supersensing. За последние годы мультимодальные LLM (MLLM) научились распознавать объекты, читать подписи, отвечать на вопросы по изображению и даже неплохо объяснять, что происходит в кадре. Но у них есть…

Будущее программирования — мультимодальное: как JanusCoder научился видеть интерфейс, который сам создает

Научные графики, интерактивные интерфейсы, а также анимации различных теорем – всё это, по сути, визуальное представление кода. Однако сегодня системы искусственного интеллекта учитывают только текстовую модальность и не принимают во внимание, как код будет выглядеть на экране или как он будет…

Как мозг предсказывает следующее слово и при чем тут ИИ

Мы редко слушаем речь как поток неожиданных звуков. Мозг постоянно строит догадки о следующем слове и проверяет себя по мере поступления звука. Такой режим экономит силы: чем точнее ожидание, тем меньше усилий на распознавание. Есть много данных о предсказаниях в зрении и слухе, но семантика —…