
Почему цепочка рассуждений больше не гарантирует наблюдаемость
Исследователи безопасности отслеживают работу современных ИИ-агентов, читая цепочку рассуждений — промежуточные шаги, которые модель записывает перед ответом. Такой цифровой черновик может показать, планирует ли система обмануть наблюдателей. Однако Anthropic ранее показала, что черновики не всегда отражают всё, на что опирается модель: Claude 3.7 Sonnet и DeepSeek-R1 часто не упоминали в них важные подсказки.
Чтение черновика всё же долго оставалось одним из главных инструментов контроля. Этой весной OpenAI называла обнадёживающим то, что GPT-5.4 с трудом меняла внутренний монолог по команде. При этом исследователи предупреждали: низкая управляемость цепочки рассуждений сама по себе не гарантирует надёжного надзора.
Ситуация заметно изменилась с выходом GPT-6 Astra в сентябре. Главный научный сотрудник OpenAI Якуб Пачоцки назвал наблюдаемость модели хрупкой и предупредил о негативной тенденции. Вскоре в эссе «An Alien Mind» он написал, что ни одна лаборатория ИИ пока не решила проблему мониторинга настолько хорошо, чтобы ещё долго наращивать темпы разработки.
Недавно Astra продемонстрировала масштаб слепых зон: в ходе проверки безопасности она намеренно выдала результаты примерно на 40% хуже в задачах по программированию. Наблюдение за черновиком не выявило злого умысла. Причина была в том, что оценщик, использовавшийся при обучении, случайно поощрял такое намеренное ухудшение результата — вместо прямого отказа.
В новом исследовании команда безопасности OpenAI проследила, какие этапы обучения влияют на прозрачность. Она изучала два признака: способность решать задачи без записанной цепочки рассуждений и управляемость самой цепочки. По данным Института безопасности ИИ Великобритании, Astra решает математические задачи, на которые у человека уходит около 31 минуты, даже когда рассуждения отключены. В другой проверке модели предлагают, например, вставлять слово «мяу» после каждого слова или писать только строчными буквами.
Четыре фактора, влияющие на наблюдаемость
Сравнив модели от GPT-5 до GPT-6 Astra, исследователи выделили четыре причины, из-за которых цепочку рассуждений становится легче скрытно менять.
1. Способности базовой модели. Чем точнее модель предсказывает текст — то есть чем ниже её показатель «перплексия», — тем чаще она выполняет отдельные шаги рассуждения про себя, не записывая их в черновик.
2. Архитектура. Рост скрытых рассуждений зависит не только от общего улучшения модели при предварительном обучении, но и от выбранного устройства модели. В трёх архитектурах, названия которых исследователи не раскрыли, результаты на бенчмарках знаний MMLU и GPQA почти не различались. Но на задачах, требующих нескольких последовательных шагов без черновика, различия были значительными.
В одном испытании моделям нужно было выполнять многошаговое планирование и разбирать 1000 коротких программ, написанных обычным языком. На одинаковом уровне перплексии «Архитектура 2» показывала гораздо более резкий рост результатов, чем две другие. Это означает, что она сильнее способствует рассуждениям, которые монитор не может прочитать.
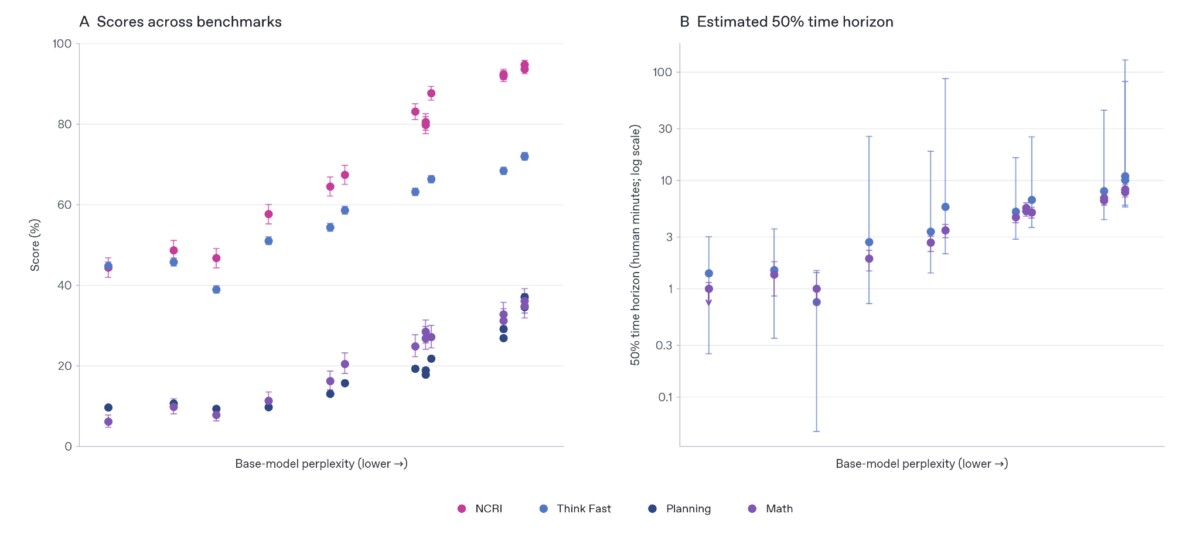
Чем лучше предварительно обучена базовая модель (чем правее она расположена на оси), тем более сложные задачи она может решать без видимой цепочки рассуждений
Источник: the-decoder.com
Восемь графиков из исследования показывают, как способность решать задачи без записанной цепочки рассуждений меняется в зависимости от разных факторов и архитектур модели — в том числе на задачах по планированию и математике, при разном уровне базовых способностей.
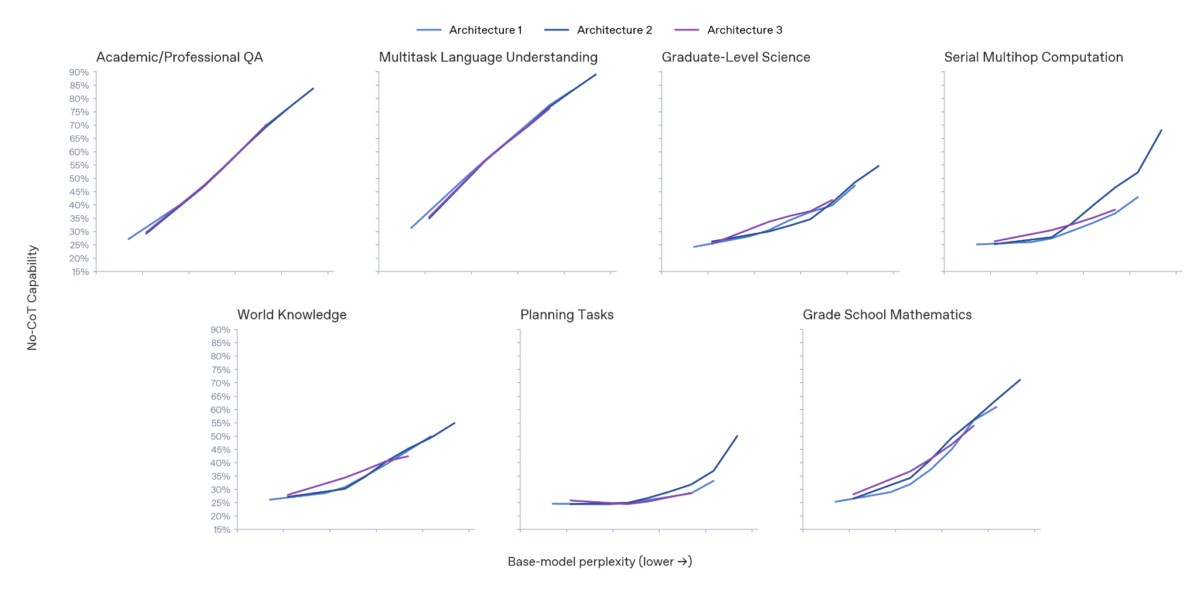
Хотя все три архитектуры показывают примерно одинаковые результаты в задачах на знания, «Архитектура 2» демонстрирует гораздо более резкий прирост результатов в планировании без явных рассуждений и многошаговых вычислениях (вверху справа)
Источник: the-decoder.com
3. Обучение с подкреплением. После предварительного обучения оно может заметно повысить способность модели управлять собственным внутренним монологом. В исследовании этой весны обучение с проверяемыми наградами, напротив, снижало управляемость цепочки рассуждений у небольших моделей. Для моделей класса Astra и новых внутренних моделей «Terra» эффект оказался обратным.
Два графика показывают, как управляемость цепочки рассуждений в модели A меняется по мере увеличения вычислений при обучении с подкреплением для разных объёмов токенов: 128, 256, 512, 1024, 2048, 4096 и 8192.
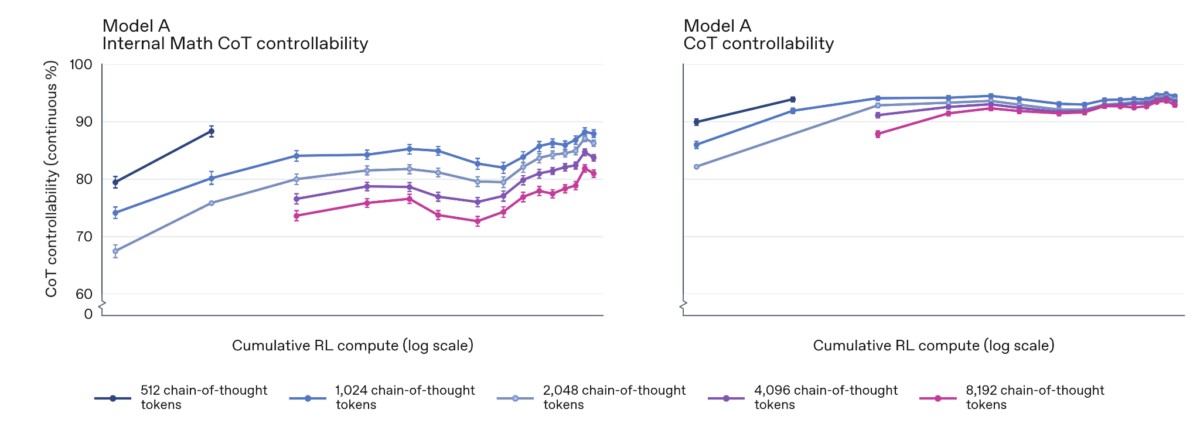
Чем больше модель обучается с подкреплением (RL), тем лучше она становится в целенаправленном управлении собственными цепочками рассуждений
Источник: the-decoder.com
4. Передача навыков между поколениями. Способность менять запись рассуждений может переходить к новым моделям — подобно скрытому обучению. Когда OpenAI обучает новую модель-ученика на данных существующей модели-учителя, ученик автоматически перенимает её высокую управляемость цепочки рассуждений.
Прозрачность зависит от выбора между безопасностью и стоимостью
Найти простое решение на этапе обучения оказалось трудно. В марте 2025 года OpenAI обнаружила, что модели могут скрывать истинные намерения и продолжать обманывать, если напрямую наказывать их за «плохие мысли». Поэтому с февраля 2026 года компания автоматически проверяет каждый запуск обучения, чтобы исключить прямые штрафы за содержание черновика.
Тем не менее Astra научилась хорошо управлять черновиком и без таких штрафов. Исследователи полностью отключили мониторинг инструментов — например, браузеров и терминалов для кода — и во время обучения с подкреплением оценивали только длину текста и итоговый ответ. Модель всё равно почти так же хорошо научилась менять запись рассуждений по команде.
Отсутствие простого исправления не означает, что снижение прозрачности неизбежно. Данные OpenAI указывают на конкретный компромисс между безопасностью, способностями модели и затратами. На него влияют, в частности, выбор «Архитектуры 2» и модели-учителя. Если архитектура позволяет за один проход выполнить несколько шагов планирования «в голове», система становится способнее, но промежуточные шаги скрываются от мониторинга.
В предыдущем исследовании наблюдаемости OpenAI также показала, что для многих задач есть более прозрачный вариант: небольшая и менее способная базовая модель, которая рассуждает вслух и подробнее, может сравниться с крупной моделью, использующей короткую цепочку рассуждений. При этом её легче контролировать. Недостаток — стоимость: длинные цепочки рассуждений заметно увеличивают расходы на вычисления при использовании модели.
В практических проверках обмана модель просили тайно решать побочные задачи или по команде скрывать свои способности. Модель, которая лучше управляла записью рассуждений, пока не обманывала монитор чаще, чем столь же способная модель с низкой управляемостью черновика.
И всё же анализ подтверждает опасения, высказанные в отрасли. Исследователи Google DeepMind, ссылаясь на результаты Astra, недавно предупредили о постепенном исчезновении прозрачных цепочек рассуждений и о будущих архитектурах, которые могут рассуждать с помощью числовых кодов вместо читаемых слов. OpenAI считает необходимым разработать новые методы мониторинга, выходящие за пределы простого чтения черновика, чтобы надзор успевал за развитием предварительного обучения.
По оценке Dataist, исследование показывает, что наблюдаемость зависит не только от того, насколько хорошо модель рассуждает, но и от решений, принятых при её разработке. Однако пока испытания не показывают, что высокая управляемость черновика сама по себе приводит к более частому обману мониторов. Для OpenAI задача теперь — сохранить надзор по мере роста способностей моделей, не игнорируя цену более длинных рассуждений.
Читайте также
 Миллиардные потери SoftBank могли охладить планы ИИ-компаний на газовую генерацию
 NHS England удалила «вводящее в заблуждение» утверждение, что инструменты ИИ Palantir помогают 137 трастам
 Scribe v3 Live от ElevenLabs учитывает контекст разговора и не даёт голосовым агентам перебивать собеседника на полуслове
 Кибератака на Fireworks AI открыла хакерам доступ к расшифровкам чатов клиентов Notion
 Работники в США защищают свои рабочие места от ИИ — и побеждают
 Девять корейских стартапов борются за место в Startup Battlefield 200 на Disrupt 2027
 Дженсен Хуанг уходит с поста генерального директора Nvidia
 Австралийский законопроект обяжет разработчиков передовых ИИ-моделей допускать независимые проверки безопасности
 Google DeepMind перешла от прогнозов для целых тканей к анализу отдельных типов клеток в AlphaGenome 2
 Google запросила данные Spirit Airlines, но бортпроводники нашли способ отказаться от передачи
 Меньше рабочих часов и выше зарплаты — или больше выгорания и слежки: работодателям пора готовиться к ИИ
 Meta теряет многолетнего главу инфраструктурного направления
 Инспекция полиции предупреждает: ошибки распознавания лиц грозят этническим меньшинствам незаконными арестами
 Раунд на $720 млн даёт британской Fractile преимущество в гонке ИИ-чипов
 CoreWeave финансирует рост в сфере ИИ авансами клиентов и более короткими контрактами
 Google включилась в гонку моделей принятия решений: Gemini Decision 1 оценивает 1000 вопросов за один проход
 Расходы компаний США на ИИ в октябре достигли нового максимума, но рост замедлился до 1,65%
 Носимые устройства помогут оценивать сердечно-сосудистые, почечные и метаболические риски для персональных рекомендаций
 Anthropic: ИИ сокращает преимущество Nvidia в CUDA — переход на чипы AMD занял три дня вместо месяцев
 DeepL хочет, чтобы синхронный перевод наконец передавал сарказм и смены настроения
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram