
Проверка на реальных запросах
Co-Design Bench проверяет, как агенты переделывают существующие веб-приложения по просьбе пользователя. Входными данными могут быть изображения, аудиозаписи, видео и документы.
Авторы считают, что привычные бенчмарки стали слишком простыми: модели, способные запускать, проверять и исправлять собственный код, набирают на них более 99%, и различия между системами почти не видны. Вместо этого исследователи собрали запросы из реальных сеансов программирования. Они отбирали случаи, когда пользователям приходилось несколько раз переформулировать задачу или отменять изменения, поэтому в тест вошли задачи, которые уже вызывали у ИИ-агентов затруднения на практике. Диапазон — от небольших правок, например извлечения суммы из чека и обновления всех связанных итогов, до полной переработки проекта.
Оценка тоже устроена строго. Один ИИ-судья проверяет готовое приложение в браузере, а второй перепроверяет каждый положительный результат и ищет макеты и жёстко заданные ответы. Баллы дают только за функции, которые действительно работают в приложении.
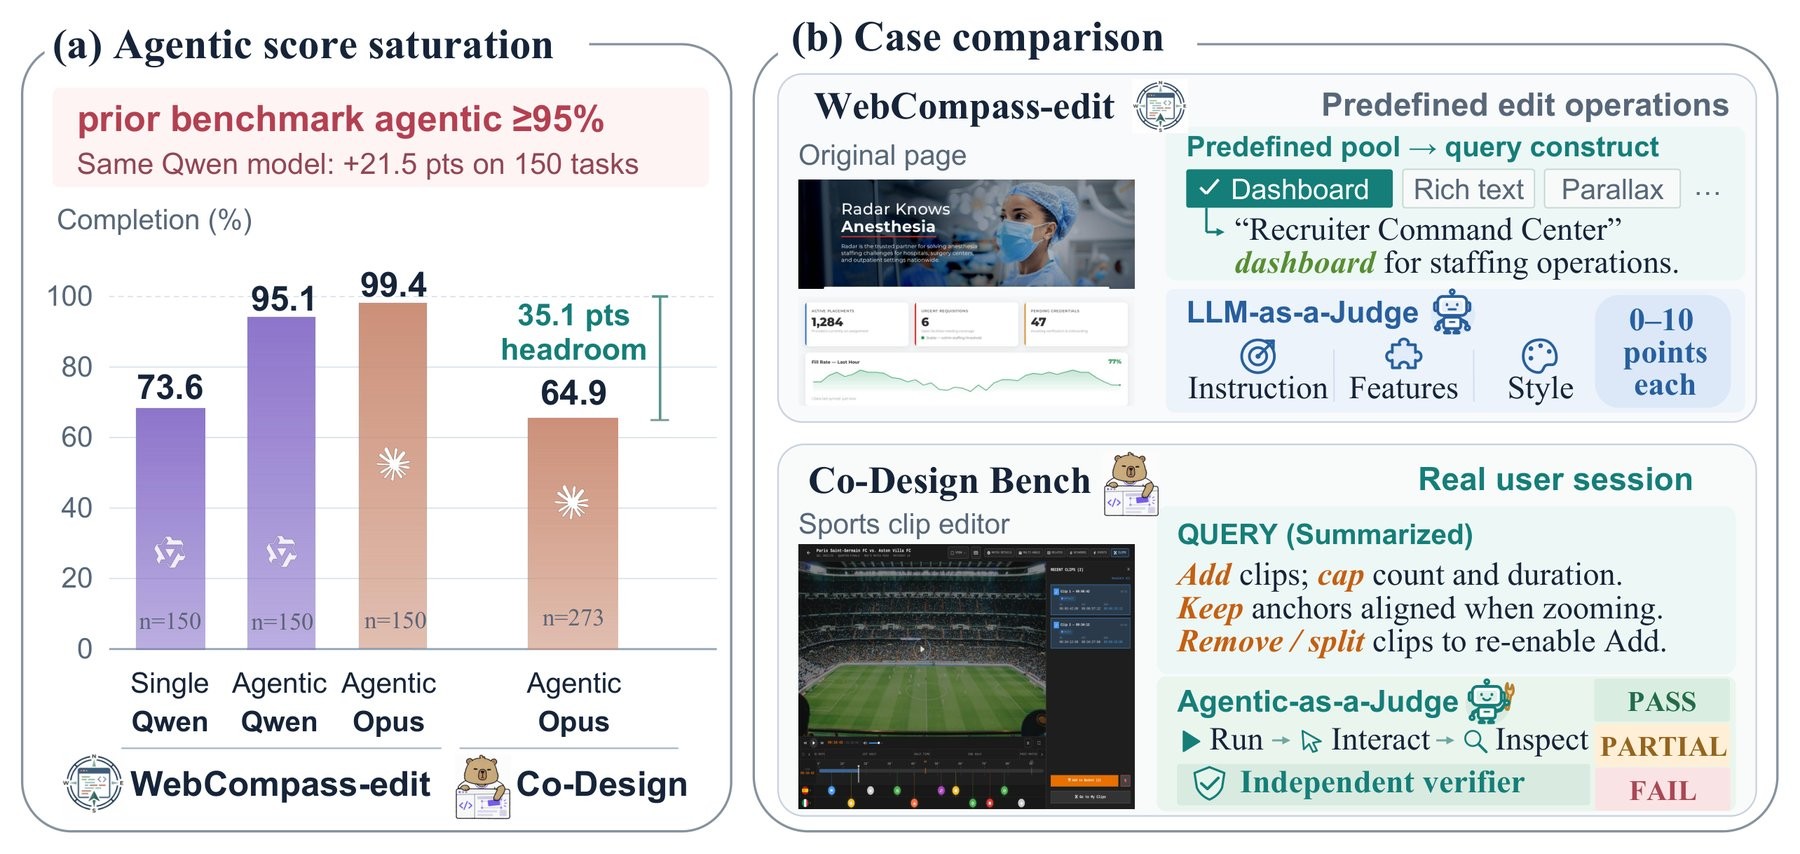
На более старых тестах, таких как WebCompass-edit, модели для агентного программирования набирают почти максимальные баллы, тогда как на Co-Design Bench разрыв превышает 35 процентных пунктов
Источник: the-decoder.com
Сложные изменения затрудняют выполнение задач
После GPT-6 Astra в рейтинге идут Claude Opus 5 и Qwen3.8-Max, а последнее место занимает Grok 4.6. На крупных переработках более компактная Qwen3.8-27B поднимается на второе место, но авторы не считают это доказательством общего преимущества модели.
Результаты всех моделей ухудшаются, когда задача требует одновременно менять компоновку, дизайн, взаимодействие и содержание. В реальных проектах такие сочетания требований встречаются обычно.
Дополнительные вычисления проблему не решают. На небольших изменениях GLM-5.2 использует почти в шесть раз больше токенов, чем GPT-6 Astra, но всё равно заметно уступает ей.
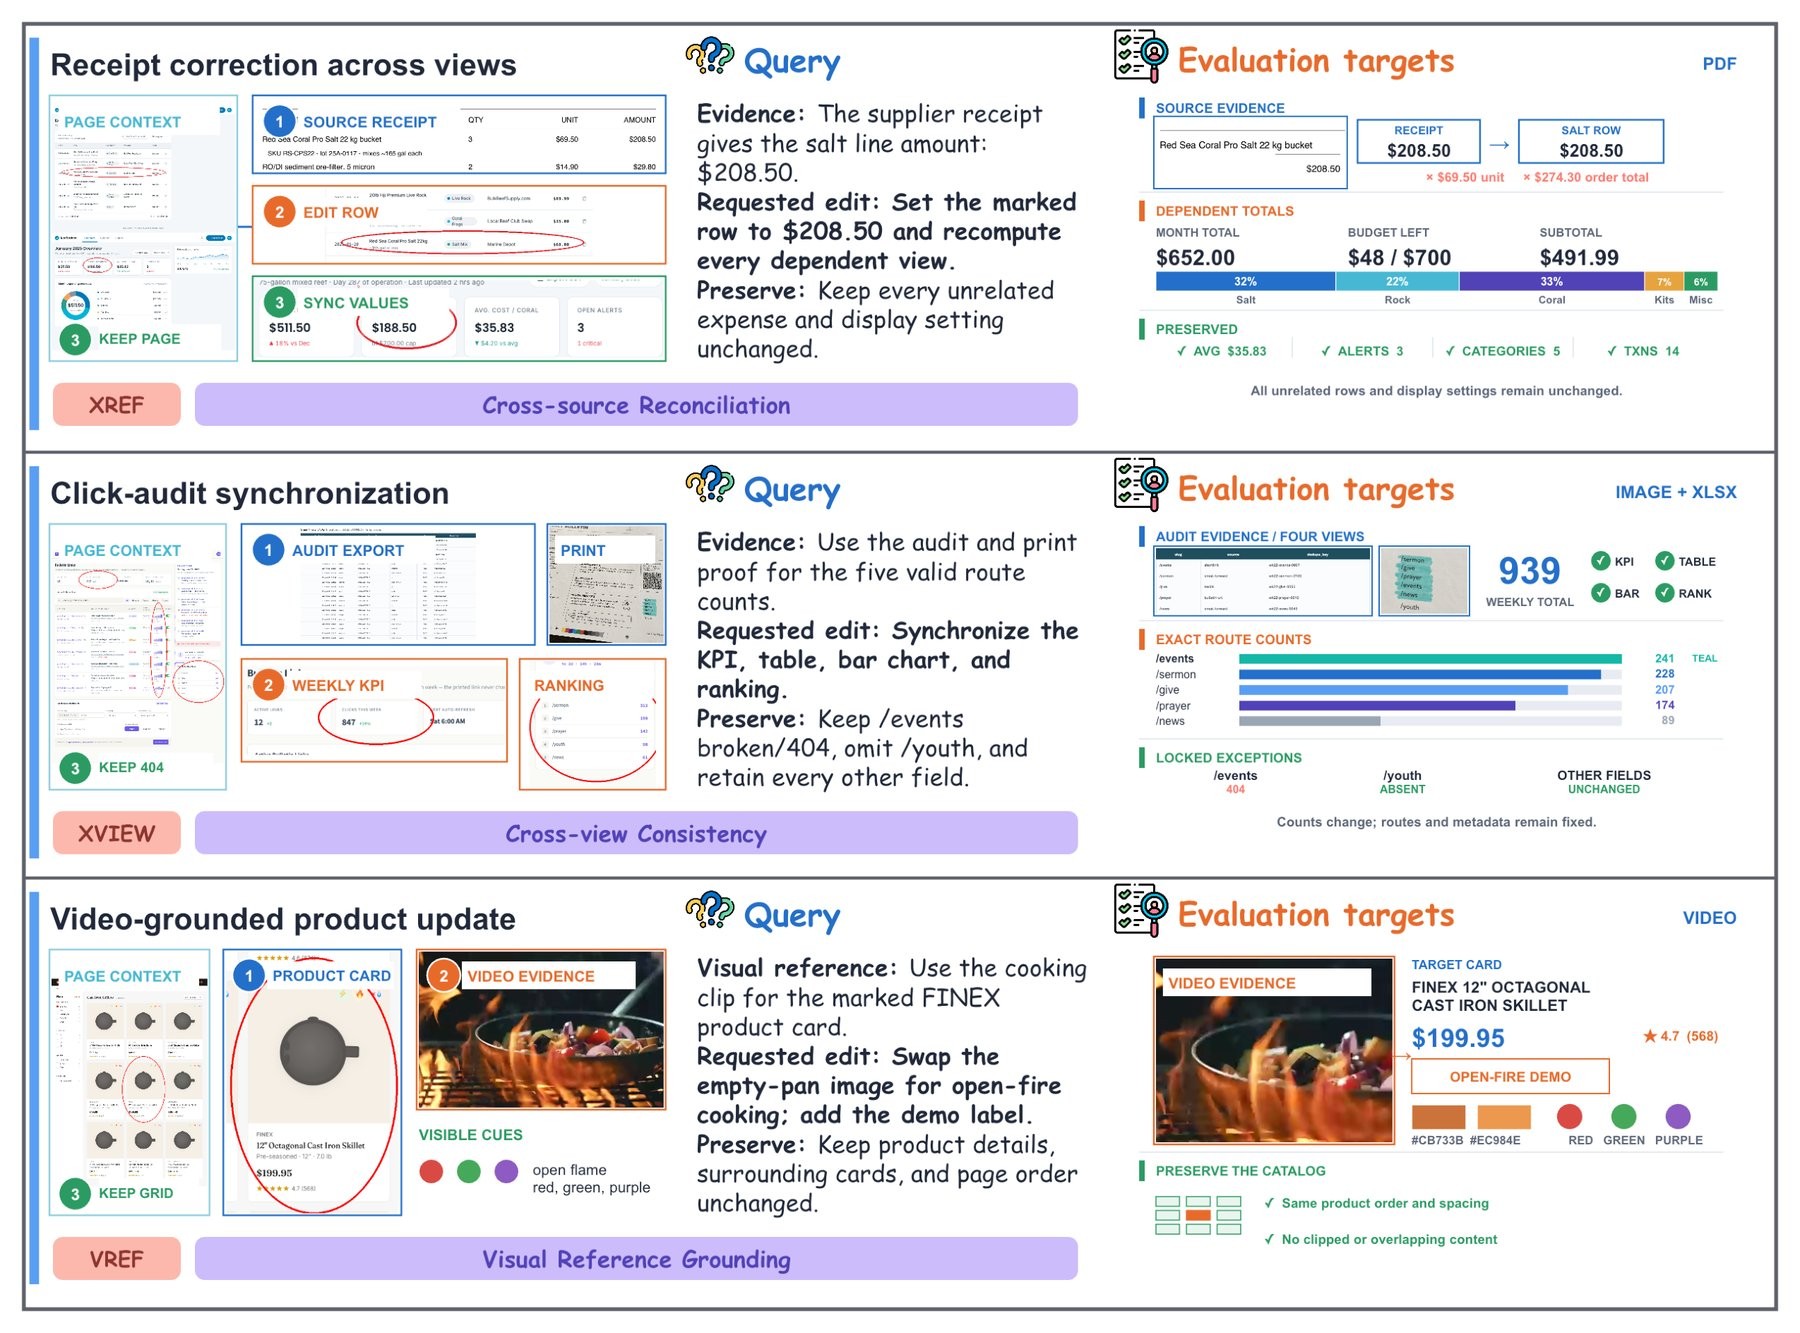
В мультимодальном треке агенты должны извлекать значения из чеков, таблиц или видео и согласованно обновлять все связанные представления
Источник: the-decoder.com
Среда запуска влияет на результат
В отдельном эксперименте исследователи запускали одни и те же модели в разных средах — программах, через которые агент читает, меняет и выполняет код. На крупных переработках результат Qwen3.8-27B составлял 75% в одной среде и лишь 56% в другой. От среды зависело и то, какая из двух моделей показывала лучший результат.
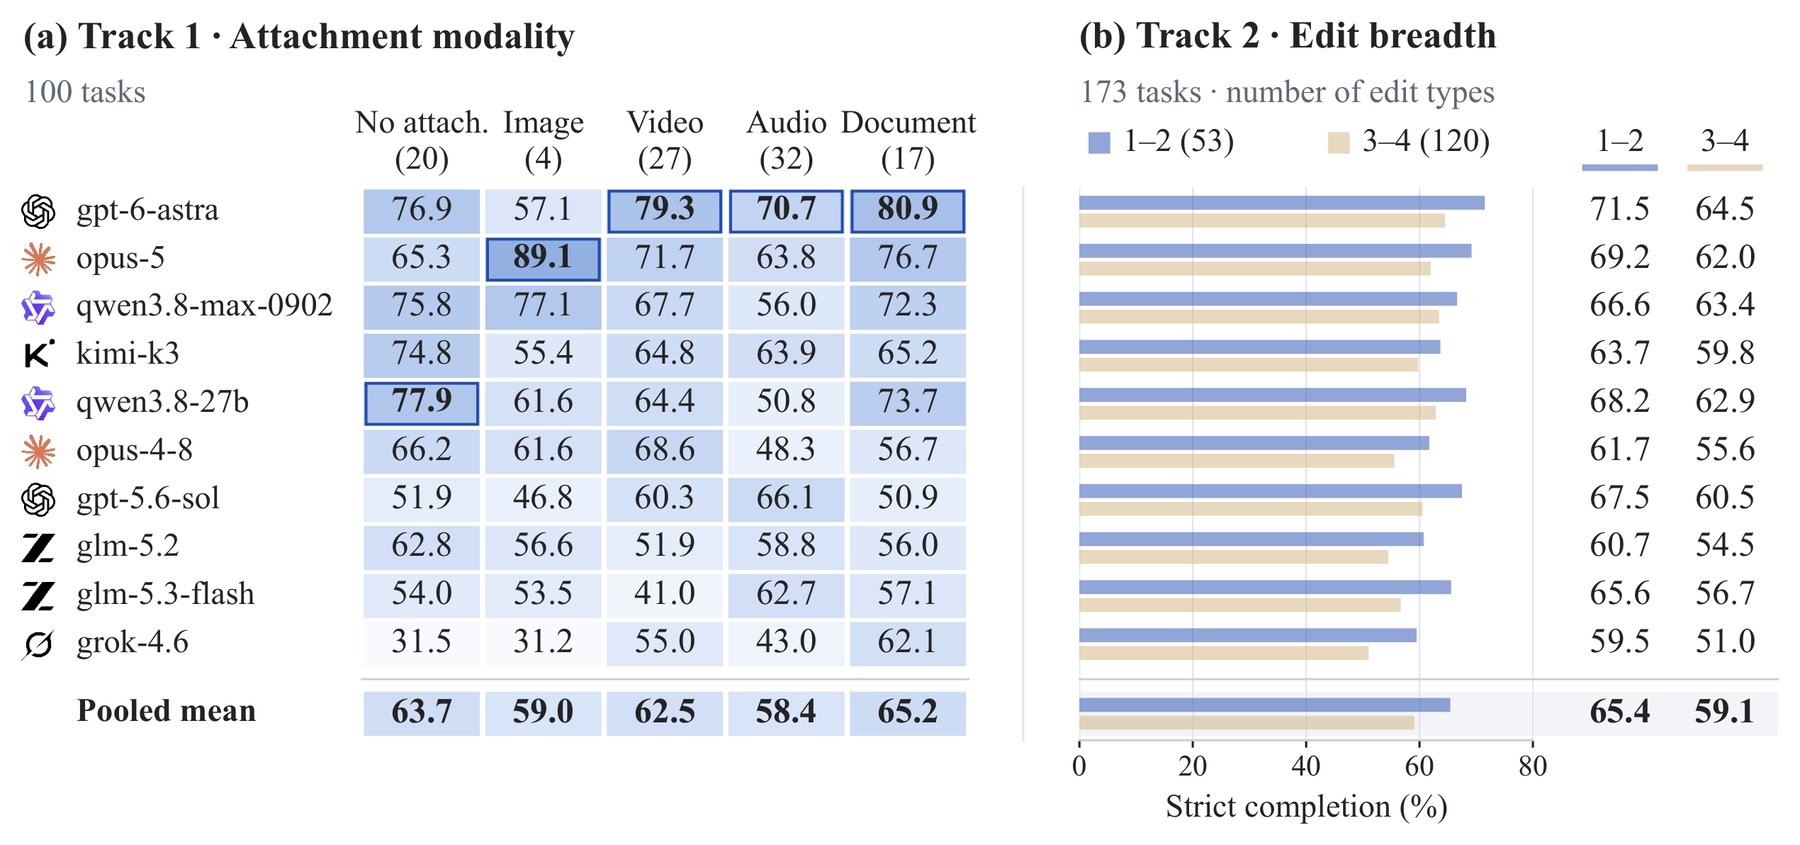
Все десять моделей показывают худшие результаты, когда задача требует трёх или четырёх различных типов изменений
Источник: the-decoder.com
Поэтому рейтинги, в которых указана только модель, дают неполную картину. Авторы советуют сообщать и модель, и среду её работы. Компаниям, выбирающим агента для программирования, следует проверять эти компоненты вместе.
У Co-Design Bench есть ограничения: для каждой задачи предусмотрен один фиксированный запрос, а уточняющие вопросы и исправления пользователя по ходу работы не проверяются. Кроме того, ИИ-судьи могут ошибаться.
Исследование METR уже показало разрыв между результатами бенчмарков и практической пригодностью кода: руководители проектов принимали код, созданный ИИ, примерно на 24 процентных пункта реже, чем подсказывали результаты популярного SWE-bench Verified.
На оценки также могут влиять недостатки тестовой среды: из-за них агент иногда проходит задачу, фактически её не решив. При этом роль среды не вполне однозначна. В другом недавнем исследовании агентов для программирования более сложные среды почти не дали измеримого прироста, хотя расходовали до трёх раз больше токенов.
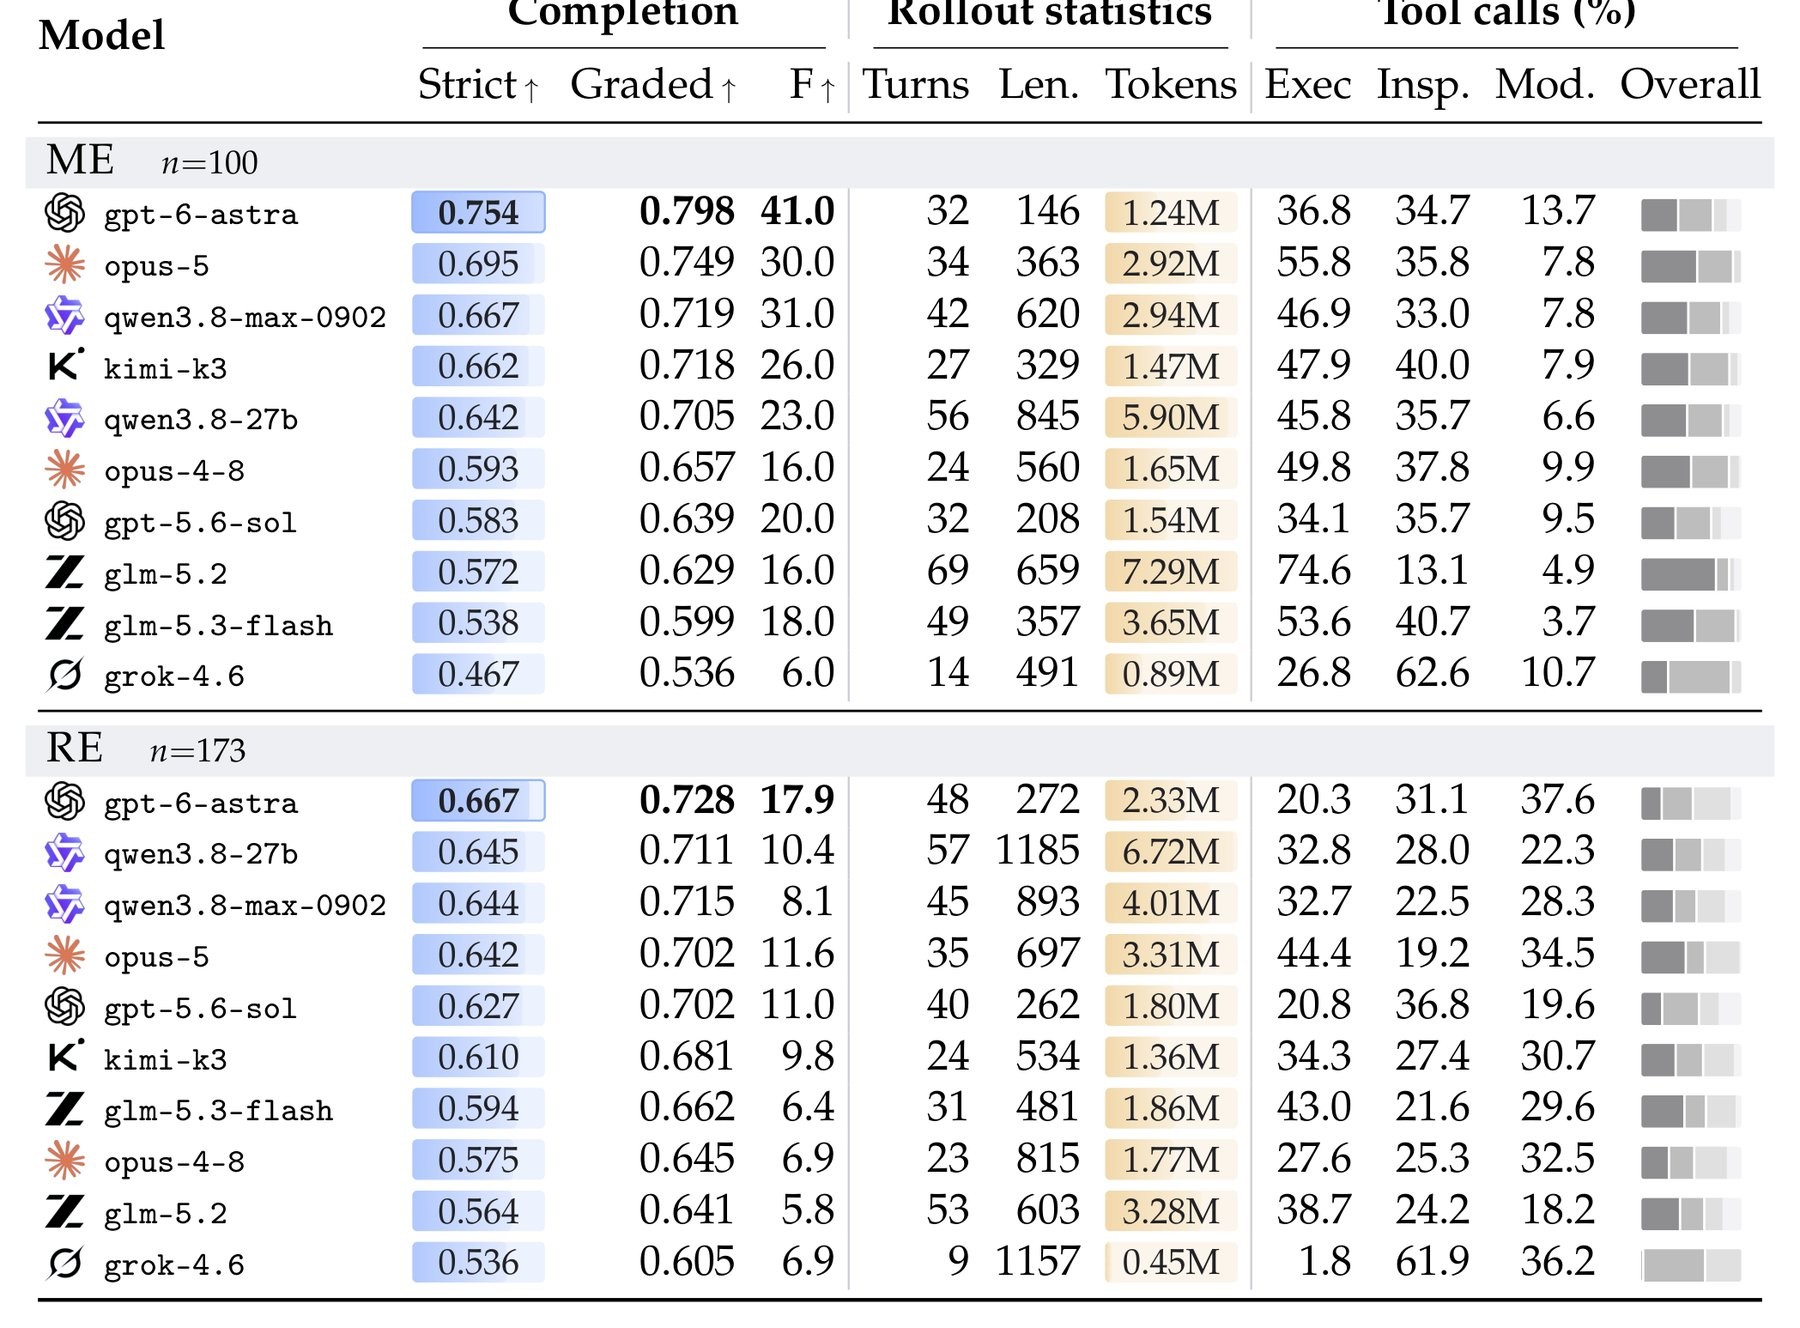
GPT-6 Astra лидирует в обоих треках, но полностью решает лишь 41 процент мультимодальных задач и чуть меньше 18 процентов задач с репозиториями
Источник: the-decoder.com
По оценке Dataist, Co-Design Bench показывает, насколько результаты агентов зависят от сложности реальных запросов и условий запуска. Его оценки полезно рассматривать вместе с ограничениями теста: пользователи не могут уточнять задачу по ходу работы, а проверку проводят ИИ-судьи.
Источник: the-decoder.com
Читайте также
 Модели мира скоро будут повсюду. Что о них нужно знать
 «Засорение ИИ»: британские госучреждения отбиваются от потока жалоб, написанных чат-ботами
 Горячие холодильники, ложная ядерная тревога и кража $6 млрд: мы на пороге эпидемии хакерских атак?
 По меморандуму разведки США, руководителя Megaspeed завербовали следить за главой Nvidia
 Модели решений вроде Jev не объясняют свои ответы — контекст приходится задавать вам
 ИИ-аудиторы находят большинство нарушений агентов, но заваливают проверяющих ложными тревогами — новое исследование
 Помните, как начальники заставляли сотрудников пользоваться ИИ? Теперь они понимают, что совершили серьёзную ошибку
 «Крестный отец ИИ» призывает готовиться к вызванному ИИ блэкауту масштаба Чернобыля
 Кто мешает роботам Uber Eats развозить еду по тротуарам: женщина против рободоставки
 Государственная пропаганда в некоторых китайских ИИ-моделях — лишь «тонкий слой», который снимает дообучение
 Девять ИИ-агентов взялись за самостоятельные исследования по открытым вопросам нацлабораторий США — ни один не прошёл экспертную проверку
 Гонка вооружений за дата-центры в Юго-Восточной Азии ставится на паузу
 Приложения для ухаживающих за близкими подключают ИИ — но этого может быть мало
 ИИ-дата-центр в Ланаркшире полностью перейдёт на электричество из национальной сети, несмотря на заявления о возобновляемой энергии
 Crusoe продала Google проблемный проект дата-центра в Вайоминге
 OpenAI, по сообщениям, привлекла ещё $11 млрд при оценке в $1,25 трлн
 В США трём мужчинам предъявили обвинения в использовании ИИ, чтобы выдавать себя за генеральных директоров и похитить миллионы долларов
 Meta представила Spaces — новый способ работать вместе с агентом Muse
 В интернете обнаружили сотни общедоступных хакерских инструментов Artex с ИИ
 Активисты проникли на стройку дата-центра Microsoft в Амстердаме
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram