
Почему важно учитывать связи экспертов
В MoE-моделях токен направляется только к нескольким экспертам, но память во время инференса требуется для всех. Например, в Qwen3.5-122B есть 48 слоёв MoE, по 256 экспертов в каждом. Их многослойные персептроны занимают 95% памяти параметров — около 250 ГБ, хотя для одного токена в каждом слое используются лишь 8 экспертов.
Один из способов уменьшить требования к памяти — навсегда удалить наименее полезных экспертов. Такой подход не требует дополнительного обучения, не создаёт задержек из-за динамической загрузки и выгрузки экспертов и сочетается с квантованием. Сложность в том, чтобы определить, каких экспертов можно удалить с наименьшим ущербом.
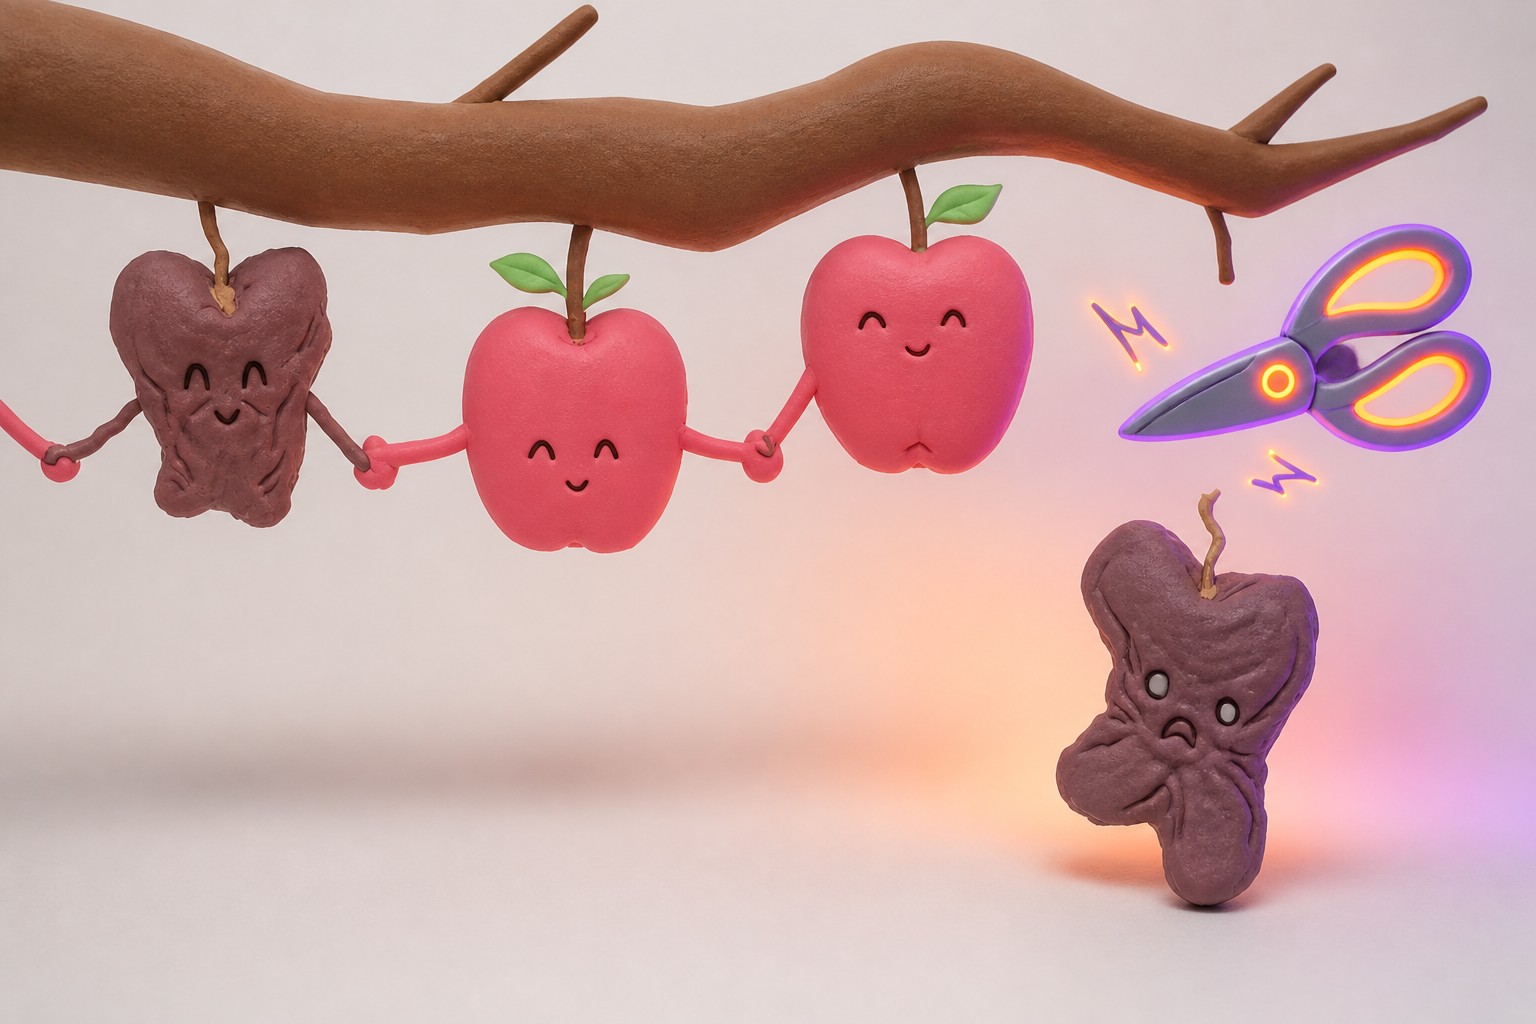
Большинство существующих методов оценивают экспертов по отдельности: каждому присваивается число, рассчитанное на калибровочных данных, после чего удаляются наименее важные. Такой подход не замечает, что эксперты могут работать устойчивыми группами и часто активироваться вместе. Если удалить одного участника важной группы, остальные могут потерять часть совместной работы.
Ранее исследователи уже наблюдали такие закономерности: группы совместно выбираемых экспертов возникают на ранних этапах обучения и затем сохраняются. Поэтому риск нарушить эти связи растёт вместе с долей удалённых экспертов. Особенно это важно при прореживании на 50%.
Как HOPE выбирает экспертов
Для каждого токена маршрутизатор MoE выбирает из общего числа экспертов E набор из K экспертов с наибольшими весами. Обычно K равно 8. Выход слоя складывается из выходов выбранных экспертов, взвешенных по значениям маршрутизатора.
Если удалить эксперта, которого выбрали бы для токена, вместо него подключается следующий по весу. Разница между исходным и новым выходом слоя — ошибка прореживания. HOPE ищет набор экспертов для удаления заданного размера, который уменьшает эту ошибку на калибровочных данных.
Найти лучший набор напрямую трудно: замены зависят от того, какие именно эксперты удалены. Поэтому HOPE использует более простой показатель Z, который служит верхней оценкой основной части ошибки. При его раскрытии возникают попарные слагаемые для экспертов: именно они учитывают совместный вклад, который игнорируют методы с независимой оценкой.
Затем HOPE минимизирует среднее значение Z на калибровочном наборе. Для этого строится матрица F и решается задача квадратичной оптимизации с ограничением на число удаляемых экспертов. Диагональные элементы F показывают индивидуальную важность экспертов, а элементы вне диагонали — силу их попарного совместного вклада. Задачу решают с помощью непрерывного приближения, а затем округляют результат до бинарного набора.
На практике матрица собирается на калибровочных данных. Для этого достаточно одного прямого прохода модели — столько же нужно и другим методам прореживания экспертов. Дополнительное время уходит на решение задачи оптимизации: хотя она невыпуклая, стандартный решатель справляется примерно за 1–2 секунды на слой. По оценке авторов, общие дополнительные затраты невелики по сравнению со временем калибровки.
В качестве примера авторы показывают матрицу F для GLM-4.5-Air с 128 экспертами в каждом слое и 106 млрд параметров. В раннем, среднем и позднем слоях видны блоки экспертов с сильными попарными связями.
Связь с REAP
HOPE тесно связан с REAP — методом прореживания, который оценивает экспертов по отдельности с учётом весов маршрутизатора. Диагональ матрицы F почти восстанавливает ранжирование экспертов, используемое REAP: коэффициент корреляции Спирмена равен 0,988. Разница между методами заключается в том, что HOPE дополнительно учитывает связи между экспертами, отражённые во внедиагональных элементах матрицы.
Результаты на трёх моделях
Авторы проверили HOPE на Qwen3.5-122B, Qwen3.5-35B и GLM-4.5-Air. Для калибровки использовали наборы Evol-CodeAlpaca и траектории SWE-Bench Verified. Прореженные модели оценивали на наборе тестов Tulu3 и бенчмарке SWE-Bench Pro, где модели-агенты самостоятельно решают задачи из GitHub. HOPE сравнивали с четырьмя методами: REAP, MAN, EAN и Frequency. Долю удаляемых экспертов меняли от 10% до 50%.
В пяти методах HOPE получил лучший средний ранг — 2,07. Он занимал первое место в 39% условий и входил в первую двойку в 67% условий. В прямых сравнениях HOPE обошёл каждый из остальных методов в большинстве случаев.
Чем выше доля удалённых экспертов, тем заметнее преимущество HOPE. При прореживании на 50% его средний ранг составил 1,58, тогда как у ближайшего конкурента REAP — 2,42. Авторы отмечают, что такое сокращение может высвободить память для более длинного контекста, более глубоких рассуждений и большего числа обращений к инструментам.
Особенно заметная разница получилась на SWE-Bench Pro. Такие задачи требуют сочетать программирование, вызовы инструментов и рассуждения на протяжении многих шагов, а значит, могут задействовать разные сочетания экспертов. Для Qwen3.5-35B-A3B при удалении половины экспертов HOPE набрал 42,3 балла против 41,8 у модели без прореживания. REAP в тех же условиях показал 36,2 — снижение на 13% относительно исходного результата.
Иногда прореженная модель может сравняться с исходной или превзойти её. Авторы предполагают, что удаление экспертов, мало относящихся к конкретным задачам, способно уменьшить помехи; такой результат встречается и у других методов прореживания. Кроме того, калибровка на задачах программирования не привела к серьёзному ухудшению результатов на тестах, не связанных с программированием. HOPE также показал хорошие результаты на всём наборе Tulu3 независимо от того, какой набор использовался для калибровки.
Какие связи HOPE старается сохранить
Авторы отдельно сравнили экспертов, для которых HOPE и REAP принимали разные решения. Они посчитали среднюю силу связи каждого такого эксперта с другими сохранёнными экспертами. Эксперты, оставленные только HOPE, в среднем имели более высокие оценки совместной работы, чем те, которых сохранял только REAP.
Иными словами, оптимизация HOPE может пожертвовать некоторыми экспертами с высокой индивидуальной оценкой, чтобы сохранить связанные группы. По результатам на бенчмарках авторы заключают, что в проверенных условиях такой обмен оказался полезным.
Как запустить HOPE
Пакет HOPE проверен на Qwen3, Qwen3-Next, Qwen3.5 и GLM-4.5. Работа состоит из трёх этапов: собрать данные калибровки, вычислить набор для прореживания и создать уменьшенную модель.
1. Собрать данные калибровки
hope calibrate \
    --model-path Qwen/Qwen3.5-35B-A3B \
    --prompts calibration_prompts.txt \
    --out-path observations.h5
Команда делает один прямой проход по калибровочным данным. Это могут быть последовательности действий ИИ-агента или отдельные запросы с ответами. Для подключения к слоям MoE используются инструменты Hugging Face Transformers. Для каждого токена сохраняются выбранные эксперты, их веса маршрутизатора, нормы выходов и статистика совместной активации. Результат — матрица F в файле HDF5.
2. Решить задачу оптимизации
hope solve \
    --obs-path observations.h5 \
    --prune-frac 0.50 \
    --out-path pruneset.json
Команда загружает матрицу F и решает бинарную задачу квадратичной оптимизации с помощью непрерывного приближения. На каждый слой уходит несколько секунд. Результат записывается в файл JSON: он содержит набор экспертов для удаления и представляет собой итог работы алгоритма HOPE.
3. Создать прореженную модель
hope prune \
    --model-path Qwen/Qwen3.5-35B-A3B \
    --pruneset-path pruneset.json \
    --out-path ./Qwen3.5-35B-A3B-pruned-50
Эта команда применяет полученный набор и создаёт уменьшенную контрольную точку модели. Результат — обычная контрольная точка Hugging Face, занимающая меньше места на диске и в памяти. Менять определения моделей для vLLM или SGLang не требуется.
Авторы также выпустили более компактный программный интерфейс на Python:
from
 hope.calibrate
import
 calibrate

from
 hope.solve
import
 solve

from
 hope.prune
import
 prune_model

calibrate(
"Qwen/Qwen3.5-35B-A3B"
, calibration_prompts,
"observations.h5"
)
solve(
"observations.h5"
, prune_frac=
0.50
, out_path=
"pruneset.json"
)
prune_model(
"Qwen/Qwen3.5-35B-A3B"
,
"pruneset.json"
,
"./Qwen3.5-35B-A3B-pruned-50"
)
Этот код последовательно собирает калибровочные данные, вычисляет набор для удаления половины экспертов и создаёт новую контрольную точку.
Ограничения метода
Преимущество HOPE сильнее всего проявляется при удалении 40–50% экспертов. При доле 10–20% REAP и MAN иногда показывают сопоставимые результаты, а разница между методами уменьшается.
Как и большинство методов прореживания экспертов, HOPE принимает решения отдельно для каждого слоя и не учитывает связи между разными слоями. В статье авторы описали теоретическую основу версии HOPE, которая учитывает межслойные связи, но результаты этой работы пока предварительные.
Наконец, HOPE моделирует взаимодействия между парами экспертов. Учитывать группы из трёх и более экспертов могло бы дать дополнительные данные, однако такие взаимодействия трудно оценивать из-за быстрого роста числа сочетаний.
Работа называется Higher-Order Pruning of Experts in Mixture-of-Experts Language Models. Её авторы — Алекс М. Ценг, Праннай Каул, Лука Занкато, Вэй Ся и Стефано Соатто. Препринт опубликован на arXiv под номером arXiv:2609.18916 в 2026 году. Код и материалы для применения HOPE к гибридным архитектурам авторы разместили в соответствующих репозиториях.
По оценке Dataist, HOPE показывает, что при сильном сокращении MoE-моделей важно сохранять не только отдельных полезных экспертов, но и их рабочие связи. Пока преимущество убедительнее всего на высоких уровнях прореживания, а решения между слоями и взаимодействия больших групп экспертов остаются за рамками проверенной версии метода.
Читайте также
 Могут ли авторы защититься от обвинений в использовании ИИ с помощью сервисов, фиксирующих историю текста? Достаточно ли этого?
 Климатические преимущества ИИ пока не доказаны
 Байкеры и защитники насекомых объединились против нового дата-центра Google
 Потеряет ли Дженсен Хуанг пост? Джеффри Зонненфельд из Йеля оценивает шансы как 50 на 50
 Глава Microsoft AI готов признать за ИИ-агентами права, если увидит убедительные доказательства
 Ловушка эффективности: почему оптимизация всего подряд может обернуться серьёзными проблемами
 Андрей Карпати за выходные создал платформу отобранных видео с помощью Claude и 20 лет Hacker News
 Ужасно, что Google не даёт пользователям просто отключить ИИ-обзоры Google
 Мозг как компьютер: метафора сформировала современный ИИ, но может сбивать с толку в споре о сознании
 IFPI предупредила Албанизе: ослабление авторских прав ради ИИ обернётся «катастрофой для творчества»
 Мамдани обвинил Google в том, что компания использует монополию, чтобы давить на школы, запрещающие ИИ
 Автор «Горького урока» приготовил горький урок для сторонников масштабирования больших языковых моделей
 1:0 в пользу человечества? На выборах в США ИИ, дата-центры и бро-олигархия получили отпор
 ИИ-агентам для программирования всё ещё нужна ручная доработка почти в трёх из четырёх реальных задач
 Модели мира скоро будут повсюду. Что о них нужно знать
 «Засорение ИИ»: британские госучреждения отбиваются от потока жалоб, написанных чат-ботами
 Горячие холодильники, ложная ядерная тревога и кража $6 млрд: мы на пороге эпидемии хакерских атак?
 По меморандуму разведки США, руководителя Megaspeed завербовали следить за главой Nvidia
 Модели решений вроде Jev не объясняют свои ответы — контекст приходится задавать вам
 ИИ-аудиторы находят большинство нарушений агентов, но заваливают проверяющих ложными тревогами — новое исследование
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram