
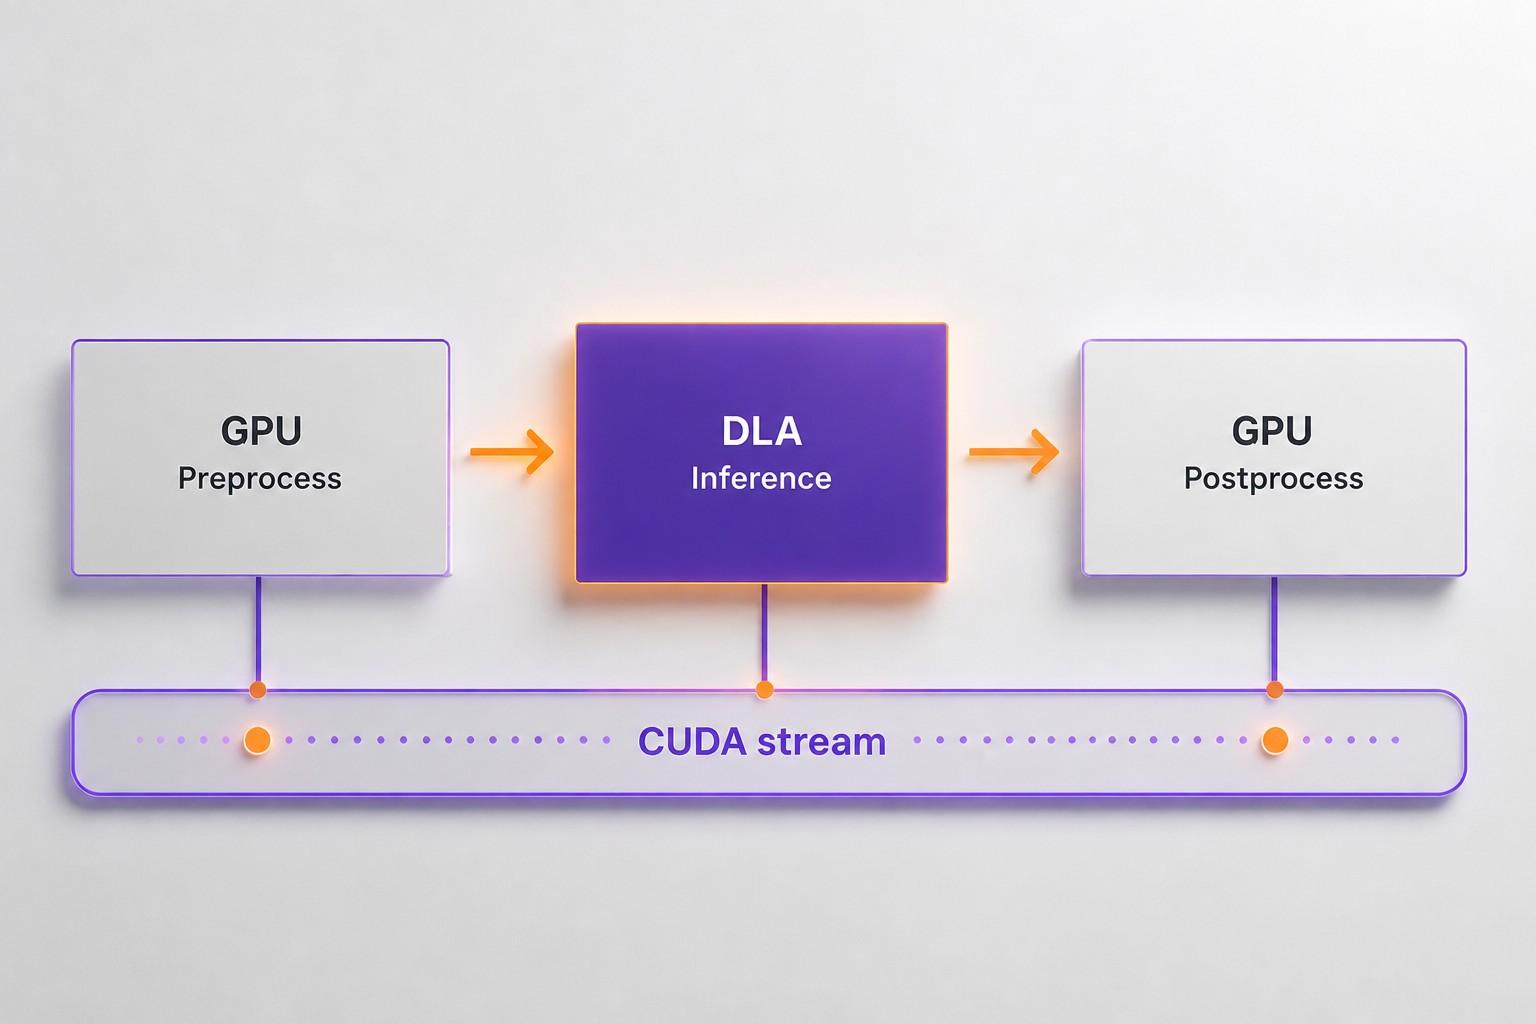
Как DLA работает вместе с Python и GPU
DLA — специализированный ускоритель для операций, часто встречающихся в нейросетях, например свёрток и пулинга. Он поддерживает меньше типов слоёв, чем GPU, но может выполнять многие операции распространённых архитектур. Передача ему части инференса помогает экономить энергию и оставляет GPU ресурсы для других задач приложения.
NVIDIA cuDLA — программный интерфейс для управления выполнением задач на DLA: с его помощью создают устройство, загружают скомпилированную сеть, регистрируют буферы памяти и отправляют задачи на выполнение. Модуль cuda.bindings.cudla открывает этот интерфейс Python-приложениям без необходимости писать на C++ код для управления средой выполнения.
Модуль появился в составе проекта CUDA Python с версии cuda-bindings 13.3.0. Это тонкий слой Python, созданный с помощью Cython поверх интерфейса cuDLA на C++. В нём 13 функций, 9 типов данных и 8 перечислений для гибридного режима, где потоки CUDA согласуют работу DLA и GPU. На Jetson Orin среду выполнения libcudla.so предоставляет NVIDIA JetPack.
Python-код управляет средой выполнения, а инференс исполняется на аппаратном DLA. Такой подход дополняет существующий сценарий на C++: управление и координацию операций можно оставить в Python.
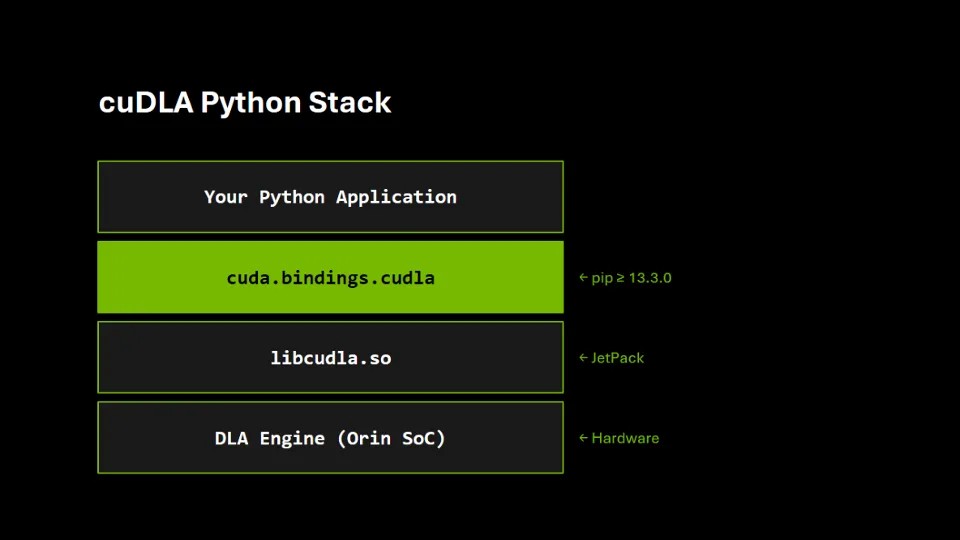
Программный стек: от приложения на Python до аппаратного ускорителя DLA на Jetson Orin через cuda.bindings.cudla
Источник: developer.nvidia.com
В статье NVIDIA рассматривает Jetson AGX Orin, но тот же интерфейс cuDLA действует на NVIDIA RTX Spark. Эта платформа переносит инференс на DLA на ноутбуки для разработчиков ИИ под Windows. Поэтому описанный для Jetson код, связанный с cuDLA, применим и к RTX Spark.
Установка и подготовка модели
На Jetson Orin с установленным JetPack библиотека libcudla.so уже есть в системе и автоматически находится Python-модулем. Отдельно устанавливать среду выполнения или SDK cuDLA не требуется.
Для установки привязок cuDLA нужен Python версии не ниже 3.10:
pip install "cuda-bindings>=13.3.0"Версия Python, поставляемая с JetPack по умолчанию, может быть старше требуемой. В таком случае NVIDIA предлагает установить Python 3.12 из PPA deadsnakes и создать виртуальное окружение:
sudo apt update && sudo apt install -y software-properties-common
sudo add-apt-repository -y ppa:deadsnakes/ppa
sudo apt update && sudo apt install -y python3.12 python3.12-venv python3.12-dev
python3.12 -m venv ~/dla-env
~/dla-env/bin/pip install "cuda-bindings>=13.3.0"
TensorRT нужен, чтобы преобразовать обученную модель в файл для DLA. Если такой файл уже подготовлен, для запуска достаточно libcudla.so, которая входит в JetPack.
Файл DLA, или loadable, — двоичный результат работы trtexec: он содержит сеть в формате, который DLA может исполнять напрямую. Пример NVIDIA рассчитан на TensorRT 11.4.1 и CUDA 13.4 Update 1 на Jetson AGX Orin с JetPack 7.2.2 или новее. Для создания файла в формате FP16 CHW16 используют модель ONNX с типом FP16 и фиксированными размерами входа:
trtexec \
    --onnx=your_model_fp16.onnx \
    --useDLACore=0 \
    --inputIOFormats=chw16 \
    --outputIOFormats=chw16 \
    --memPoolSize=dlaSRAM:1 \
    --saveEngine=model.bin \
    --buildDLAStandalone
Ключи задают параметры сборки:
--useDLACore=0 выбирает первый DLA-движок на Orin.--buildDLAStandalone создаёт отдельный файл DLA, для запуска которого не нужен TensorRT.В TensorRT 11 точность определяется типами тензоров в модели: параметры --fp16 и --int8 больше не поддерживаются. Поскольку в примере размеры входа фиксированы, параметр --shapes не используется. Описание соответствует текущему сценарию FP16 в примере и изменениям параметров TensorRT 11.
Не все слои сети совместимы с DLA. Поэтому перед сборкой часто требуется обработать граф ONNX и убрать несовместимые начальные и конечные слои. Дальнейший код Python работает с любым полученным файлом .bin или .nvdla.
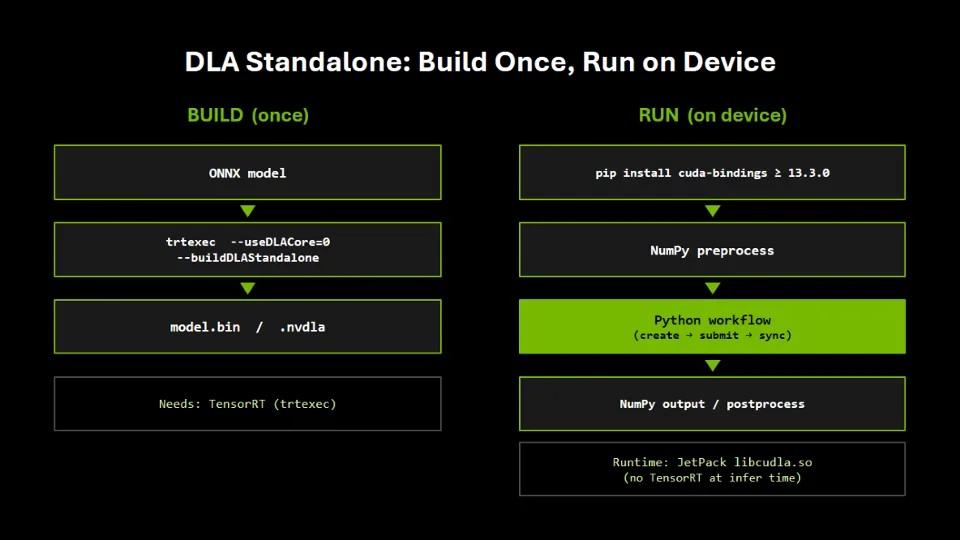
Один раз скомпилируйте автономный загружаемый модуль DLA и запускайте инференс на Python с помощью JetPack libcudla.so
Источник: developer.nvidia.com
Девять шагов инференса
Для работы с CUDA и cuDLA в примере достаточно трёх импортов:
import numpy as np
from cuda.bindings import cudla
from cuda.bindings import driver, runtime
cudla — новый модуль. driver и runtime — уже существующие привязки Python к интерфейсам драйвера и среды выполнения CUDA; в примере они отвечают за потоки, память и копирование данных. Операции DLA и GPU координируются одним потоком CUDA.
1. Настроить CUDA и создать устройство DLA
Режим cudla.Mode.CUDA_DLA включает гибридную работу: задачи DLA отправляются через поток CUDA. В одном потоке можно поставить в очередь предварительную обработку на GPU, инференс на DLA и последующую обработку на GPU — они выполнятся по порядку.
driver.cuInit(0)
runtime.cudaSetDevice(0)

cudla_device = cudla.create_device(0, int(cudla.Mode.CUDA_DLA))
В этой версии не поддерживается автономный режим, которому нужны буферы и средства синхронизации NvSci. Если запросить его через create_device, вызов завершится ошибкой CudlaError(ErrorUnsupportedOperation).
2. Загрузить файл модели
Файл передают в module_load_from_memory как объект Python типа bytes. Путь к файлу и файловый дескриптор не нужны: данные можно загружать также из файла, отображённого в память, встроенного ресурса или сетевого потока.
with open("model.bin", "rb") as f:
    loadable_data = f.read()

module_handle = cudla.module_load_from_memory(
    cudla_device, loadable_data, len(loadable_data), 0
)
3. Получить описание входов и выходов
До выделения памяти приложение запрашивает у загруженного модуля число входных и выходных тензоров, а также их описания:
num_inputs = cudla.module_get_attributes(
    module_handle, int(cudla.ModuleAttributeType.NUM_INPUT_TENSORS)
)
num_outputs = cudla.module_get_attributes(
    module_handle, int(cudla.ModuleAttributeType.NUM_OUTPUT_TENSORS)
)
input_descs = cudla.module_get_attributes(
    module_handle, int(cudla.ModuleAttributeType.INPUT_TENSOR_DESCRIPTORS)
)
output_descs = cudla.module_get_attributes(
    module_handle, int(cudla.ModuleAttributeType.OUTPUT_TENSOR_DESCRIPTORS)
)
Каждое описание имеет тип cudla.ModuleTensorDescriptor и содержит размер буфера (size_), форму тензора (n, c, h, w), имя, формат данных и шаги между элементами. Размеры выделяемой памяти берутся из описаний, а не задаются в коде вручную. Благодаря этому один и тот же сценарий подходит для разных моделей.
4. Выделить память на GPU
input_gpu  = runtime.cudaMalloc(input_descs[0].size_)[1]
output_gpu = runtime.cudaMalloc(output_descs[0].size_)[1]
Вызовы CUDA-драйвера и среды выполнения возвращают кортеж, где первым элементом идёт код состояния. В полном примере каждый такой вызов обёрнут в вспомогательную функцию, которая проверяет статус и сообщает об ошибке; в сокращённых фрагментах эту проверку опустили. Для рабочей программы она необходима. Если у модели несколько входов или выходов, нужно пройти по описаниям и выделить буфер для каждого тензора. Поле size_ задаёт точный размер в байтах.
5. Зарегистрировать буферы в cuDLA
Перед передачей буфера задаче его нужно зарегистрировать в устройстве DLA. Регистрация возвращает дескриптор, с помощью которого ускоритель обращается к памяти:
input_registered  = cudla.mem_register(
    cudla_device, int(input_gpu), input_descs[0].size_, 0
)
output_registered = cudla.mem_register(
    cudla_device, int(output_gpu), output_descs[0].size_, 0
)
Вызов int() извлекает исходный указатель из объекта памяти CUDA. Привязки cuda.bindings возвращают непрозрачные объекты-дескрипторы, а преобразование в целое число передаёт указатель интерфейсу C, который его ожидает.
6. Подготовить данные и скопировать их на GPU
Предварительная обработка — нормализация значений и приведение данных к нужным шагу тензора и формату — это единственная часть сценария, специфичная для модели. Требуемую раскладку можно определить по полям stride, data_format и data_type в описании тензора. Для модели с несколькими входами копирование повторяют для каждого буфера; остальные этапы не зависят от содержимого файла модели.
stream = driver.cuStreamCreate(driver.CUstream_flags.CU_STREAM_NON_BLOCKING)[1]

# Preprocess your input into a numpy array `input_cpu`
# matching the tensor layout described by input_descs[0] ...

runtime.cudaMemcpyAsync(
    input_gpu, input_cpu, input_descs[0].size_,
    runtime.cudaMemcpyKind.cudaMemcpyHostToDevice, stream
)
runtime.cudaMemsetAsync(output_gpu, 0, output_descs[0].size_, stream)
7. Создать задачу и отправить её на выполнение
cudla.Task оборачивает структуру C cudlaTask. Если присвоить task.input_tensor или task.output_tensor список Python, соответствующее число тензоров обновится автоматически. Вызов submit_task ставит инференс в очередь потока CUDA, связывая его с GPU-операциями до или после него в том же потоке.
task = cudla.Task()
task.module_handle = module_handle
task.input_tensor  = [int(input_registered)]
task.output_tensor = [int(output_registered)]
task.wait_events   = 0
task.signal_events = 0

cudla.submit_task(cudla_device, int(task), 1, int(stream), 0)
8. Дождаться выполнения и прочитать результат
Первая синхронизация ждёт завершения задачи на DLA. Затем выходной массив NumPy создаётся размером в байтах, указанным в описании тензора. После копирования данных с GPU в оперативную память выполняется вторая синхронизация: она гарантирует, что перенос закончен до чтения результата.
runtime.cudaStreamSynchronize(stream)

output_cpu = np.empty(output_descs[0].size_, dtype=np.uint8)
runtime.cudaMemcpyAsync(
    output_cpu, output_gpu, output_descs[0].size_,
    runtime.cudaMemcpyKind.cudaMemcpyDeviceToHost, stream
)
runtime.cudaStreamSynchronize(stream)
9. Освободить ресурсы
Для каждого созданного дескриптора предусмотрен вызов освобождения: для устройства DLA, модуля, зарегистрированной памяти, выделений GPU и потока CUDA.
cudla.mem_unregister(cudla_device, input_registered)
cudla.mem_unregister(cudla_device, output_registered)
cudla.module_unload(module_handle, 0)
cudla.destroy_device(cudla_device)
runtime.cudaFree(input_gpu)
runtime.cudaFree(output_gpu)
driver.cuStreamDestroy(stream)
Обработка ошибок и результат
Вызовы cuDLA при ошибке выбрасывают исключение cudla.CudlaError, а не возвращают код ошибки. В исключении есть числовой статус и его текстовое имя:
try:
    device = cudla.create_device(0, int(cudla.Mode.CUDA_DLA))
except cudla.CudlaError as e:
    print(e)  # e.g. "ErrorInvalidDevice (8)"
Такие ошибки можно обрабатывать стандартными средствами Python. Для освобождения ресурсов автор рекомендует использовать try/finally: дескрипторы устройств DLA — непрозрачные ресурсы C и не освобождаются автоматически при сборке мусора. Чтобы реагировать на конкретные причины сбоя, можно проверять e.status по значениям перечисления cudla.Status — от ошибок параметров ErrorInvalidParam до аппаратных сбоев, например ErrorDlaErrEngineTimeout.
После cudaStreamSynchronize массив output_cpu содержит необработанный выход модели в формате NumPy. Это могут быть оценки классов, карты признаков или координаты ограничивающих рамок — результат зависит от сети. Интерпретация данных остаётся обычной частью Python-пайплайна инференса; выход можно обрабатывать с помощью NumPy, PyTorch или OpenCV, не покидая процесс Python.
Для сети с основой ResNet-50, скомпилированной в файл DLA, в примере приведён такой вывод:
cuDLA device created: 0x55a1b2c30000
Module loaded: 0x55a5b6c70000
numInputTensors = 1
numOutputTensors = 1
Input 0:  size=..., shape=(1,64,56,56), name=resnetv17_pool0_fwd
Output 0: size=..., shape=(1,2048,7,7), name=resnetv17_stage4_activation2
SUBMIT IS DONE (task queued; completion pending)
Output tensor written to host
Вывод показывает, какие размеры буферов и имена тензоров ожидает модель. Приложение может получать эти значения из описания, не задавая их вручную. После синхронизации output_cpu — плоский массив NumPy; его можно интерпретировать или преобразовать в нужную форму по полям data_type, data_format, stride и shape в output_descs[0], а затем передать следующему этапу пайплайна.
От создания устройства через create_device до синхронизации через cudaStreamSynchronize общий сценарий не меняется в зависимости от архитектуры сети. Меняются имена и размеры тензоров, а также последующая обработка.
Примеры и проверки
Модуль cuda.bindings.cudla входит в cuda-bindings 13.3.0. Для запуска инференса на DLA нужно установить его, собрать файл модели с помощью trtexec, а затем выполнить описанные девять шагов на устройстве.
pip install "cuda-bindings>=13.3.0"В репозитории NVIDIA/cuda-python есть модульные тесты для перечислений, простых типов данных и программного интерфейса. Они находятся в cuda_bindings/tests/cudla/ и запускаются без DLA и без libcudla.so:
pytest cuda_bindings/tests/cudla/ -vПолный пример инференса, входные данные и сценарии подготовки модели и сборки файла для DLA опубликованы в примерах Deep Learning Accelerator.
По оценке Dataist, привязки Python упрощают встраивание DLA в приложения и позволяют согласовать его работу с GPU через поток CUDA. При этом запуск зависит от заранее скомпилированного файла, а совместимость слоёв с DLA нужно учитывать ещё при подготовке модели.
Читайте также
 Ой, Дженсен! За самыми мощными ИИ-моделями Китая стоят запрещённые к экспорту чипы Nvidia
 Каково бороться с потоком жалоб, сгенерированных ИИ
 Anthropic подключила Claude for Manufacturing напрямую к заводским программам для автоматизации промышленных процессов
 NVIDIA SOMA Retargeter адаптирует движения человека для роботов
 ИИ помог раскрыть открытия в тетрадях Курта Гёделя — математика, опередившего своё время
 Новый кошелёк ChatGPT позволяет ИИ-агентам выбирать товары и оформлять покупки за вас
 Новое приложение ElevenLabs объединяет заметки со встреч и диктовку для команд
 Бывший инженер Alibaba запустил Octen: ИИ-поиск за 10 миллисекунд и безлимитный тариф за $20 в месяц
 Бесстыдные мошенники наживаются на фальшивых ИИ-фото папарацци: знаменитости резко худеют, пьют во время беременности и изменяют партнёрам
 Израильские венчурные инвесторы видят шанс для конкурентов на фоне потрясений в Nvidia
 Отрасль дата-центров использует пропаганду, чтобы подавить сопротивление — Сэмюэл Вулли, Дин Джексон и Майя Волучем
 Стартап делает ставку на ИИ-микродрамы, чтобы Голливуд снимал больше историй о чернокожих героях
 Скандал вокруг Nvidia: на Говарда Латника давят из-за предполагаемого бездействия
 Больше самостоятельности, меньше NDA: добровольцы выдвинули новые требования к испытаниям мозговых имплантов
 Nectar запустила ИИ-агента, который ищет авторов и пишет им от имени брендов
 United Airlines блокирует ИИ-агентам бронирование билетов, ссылаясь на риски кибербезопасности
 Phota Labs превращает обычные фото в профессиональные снимки с помощью ИИ
 Norwest усиливает инвестиции в ИИ, запустив новый фонд на $4 млрд
 Muse теперь звонит в компании США — но только по платной подписке
 Anthropic переносит Claude в Google Meet: он будет создавать документы и доски прямо на встречах
Ежедневные новости об ИИ
Каждый день отбираем важные новости об ИИ и рассказываем главное — без хайпа и воды. Если хотите понимать, что происходит в ИИ раньше остальных, — подписывайтесь.
Только важное — каждый день
В Telegram